Deskripsi
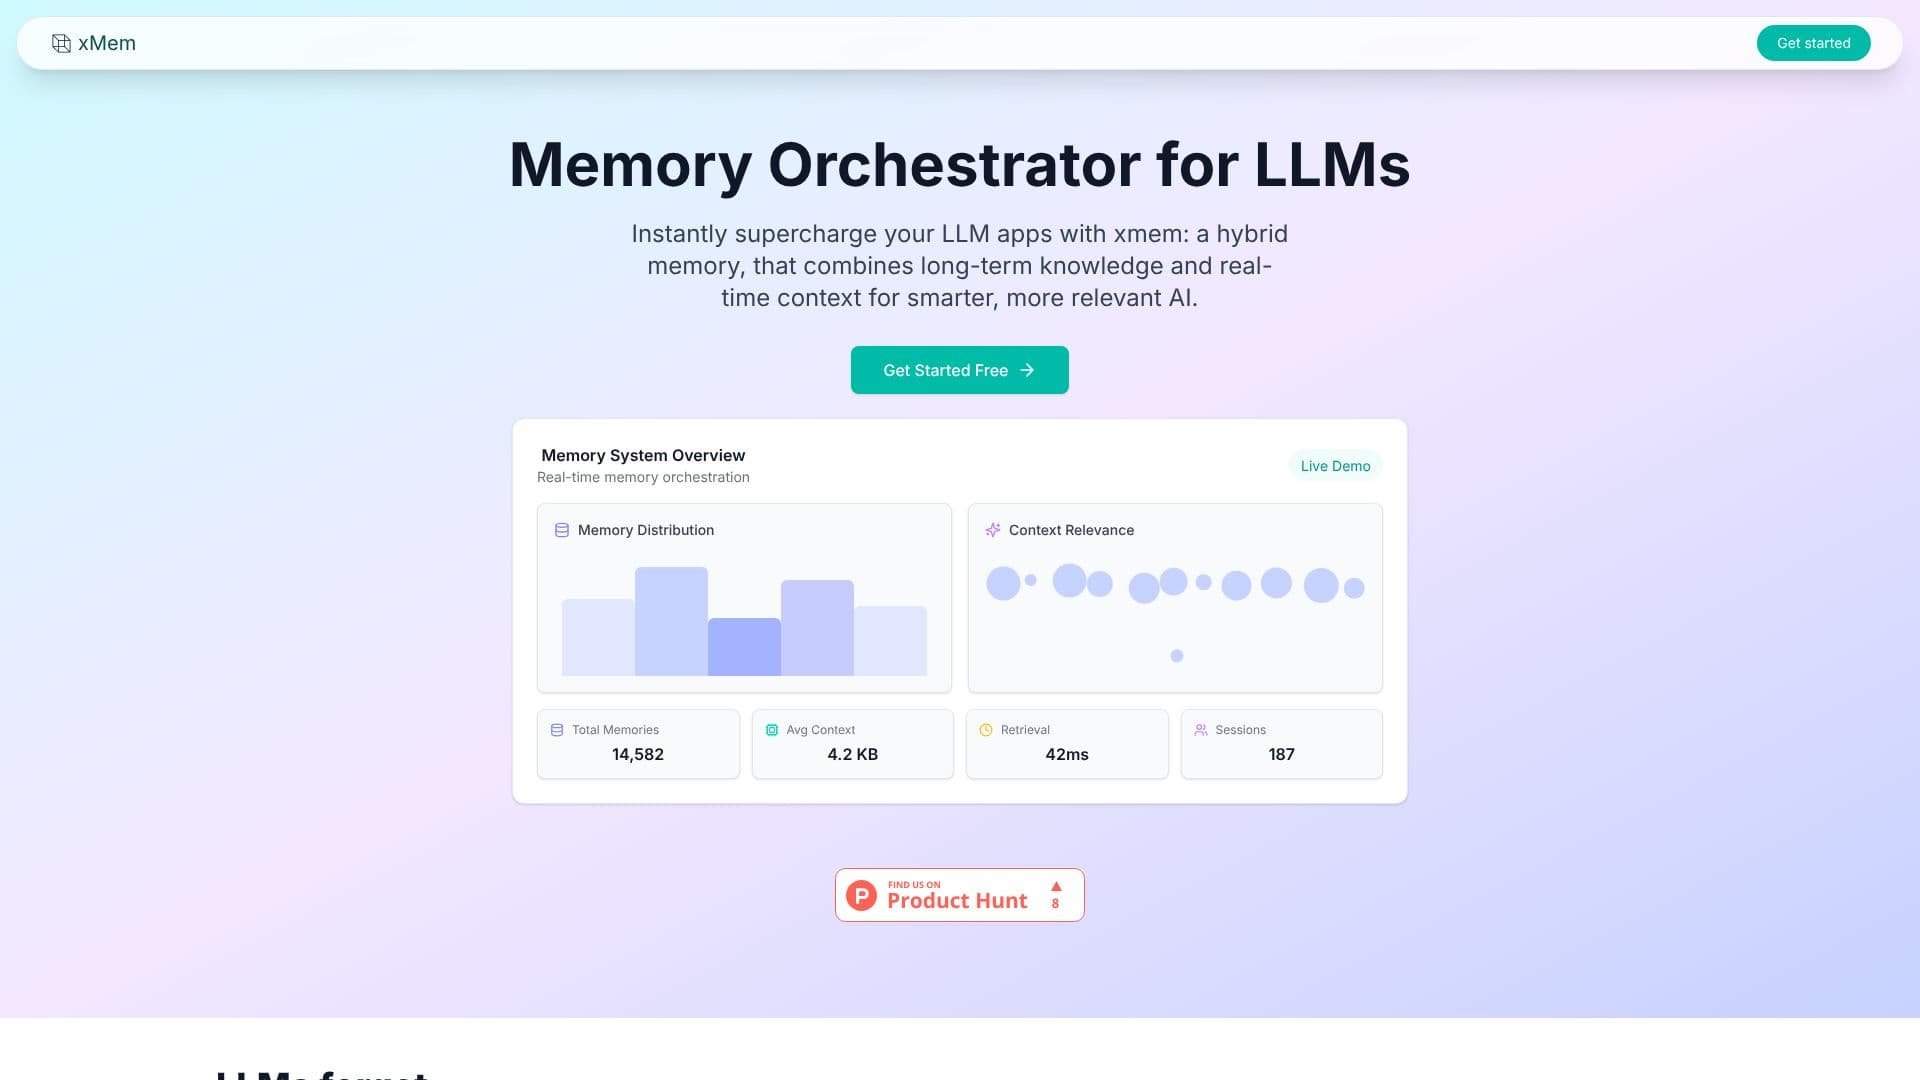
LLM seringkali kesulitan dengan memori, yang menyebabkan kehilangan konteks dan pengalaman pengguna yang berulang. xMem mengatasi tantangan ini dengan menyediakan sistem memori hibrida yang mengorkestrasi pengetahuan jangka panjang dan konteks sesi waktu nyata untuk setiap interaksi LLM. Ini memastikan bahwa aplikasi AI Anda tetap relevan, akurat, dan terkini, bahkan di berbagai sesi.
Baca Selengkapnya
Sistem xMem dirancang untuk mencegah jebakan umum kehilangan memori LLM. Ini menggabungkan penyimpanan memori persisten untuk pengetahuan jangka panjang, dokumen, dan catatan, yang dapat diakses melalui pencarian vektor, dengan komponen memori sesi yang melacak percakapan, instruksi, dan konteks terbaru untuk diingat segera. Pendekatan ganda ini memungkinkan LLM untuk mengakses pemahaman komprehensif tentang interaksi sebelumnya dan informasi yang disimpan.
Inti dari fungsionalitas xMem terletak pada orkestrasi RAG (Retrieval-Augmented Generation). Ini secara otomatis merakit konteks yang paling relevan untuk setiap panggilan LLM, menghilangkan kebutuhan untuk penyesuaian manual. Alur data melibatkan prompt pengguna yang diproses melalui penyimpanan sesi dan database vektor (seperti Qdrant, ChromaDB, Pinecone), sebelum diberikan ke penyedia LLM (seperti Llama.cpp, Ollama, OpenAI) dengan konteks yang dirakit secara optimal.
Selanjutnya, xMem menampilkan grafik pengetahuan dinamis yang berkembang yang menghubungkan konsep, fakta, dan konteks pengguna secara real time. Grafik ini memungkinkan LLM untuk bernalar, mengingat, dan menghubungkan informasi seperti otak manusia, yang mengarah pada jawaban yang lebih cerdas dan relevan. Kemampuan ini sangat bermanfaat untuk aplikasi seperti RAG, agen, dan kopilot.
xMem dibangun dengan filosofi open-source, memastikan kompatibilitas dengan berbagai LLM open-source dan database vektor. Integrasinya yang mudah difasilitasi oleh API yang mudah digunakan dan dasbor pemantauan. Sistem ini menawarkan manajemen memori cerdas, pencarian dan pengambilan semantik melalui integrasi database vektor, dan perakitan konteks waktu nyata untuk memproses ukuran konteks hingga 8,2 KB dengan latensi rendah.
- KategoriBasis Data Vektor & Pengambilan
- Model HargaPaket Gratis
- PenerapanDi-hosting Sendiri / Cloud
- PlatformWeb
Fitur Inti xMem
Sistem memori hibrida yang menggabungkan konteks jangka panjang dan sesi
Memori persisten untuk pengetahuan dan konteks pengguna
Memori sesi untuk melacak interaksi terbaru
Orkestrasi RAG untuk perakitan konteks otomatis
Grafik pengetahuan waktu nyata untuk penautan konsep
Pencarian vektor untuk pengambilan pengetahuan
Dukungan untuk LLM open-source (Llama, Mistral, dll.)
Integrasi dengan berbagai database vektor (Qdrant, ChromaDB, Pinecone)
API mudah untuk integrasi yang mulus
Dasbor pemantauan untuk pengawasan
Manajemen memori cerdas
Kemampuan pencarian dan pengambilan semantik
Struktur pengetahuan dinamis dan berkembang
Cara menggunakan xMem?
Konfigurasi: Siapkan penyimpanan vektor, penyimpanan sesi, dan penyedia LLM Anda.
Integrasi: Gunakan API xMem untuk menghubungkan aplikasi LLM Anda.
Kueri: Kirimkan prompt ke orkestrator untuk respons yang relevan secara kontekstual.
Pantau: Manfaatkan dasbor untuk melacak penggunaan memori dan kinerja.
Optimalkan: Sempurnakan perakitan konteks dan grafik pengetahuan untuk akurasi AI yang lebih baik.
Kasus Penggunaan xMem
- Chatbot Kontekstual
- Asisten yang Dipersonalisasi
- Sistem RAG
- Agen AI
- Kopilot
- Manajemen Pengetahuan
- AI Dukungan Pelanggan