Deskripsi
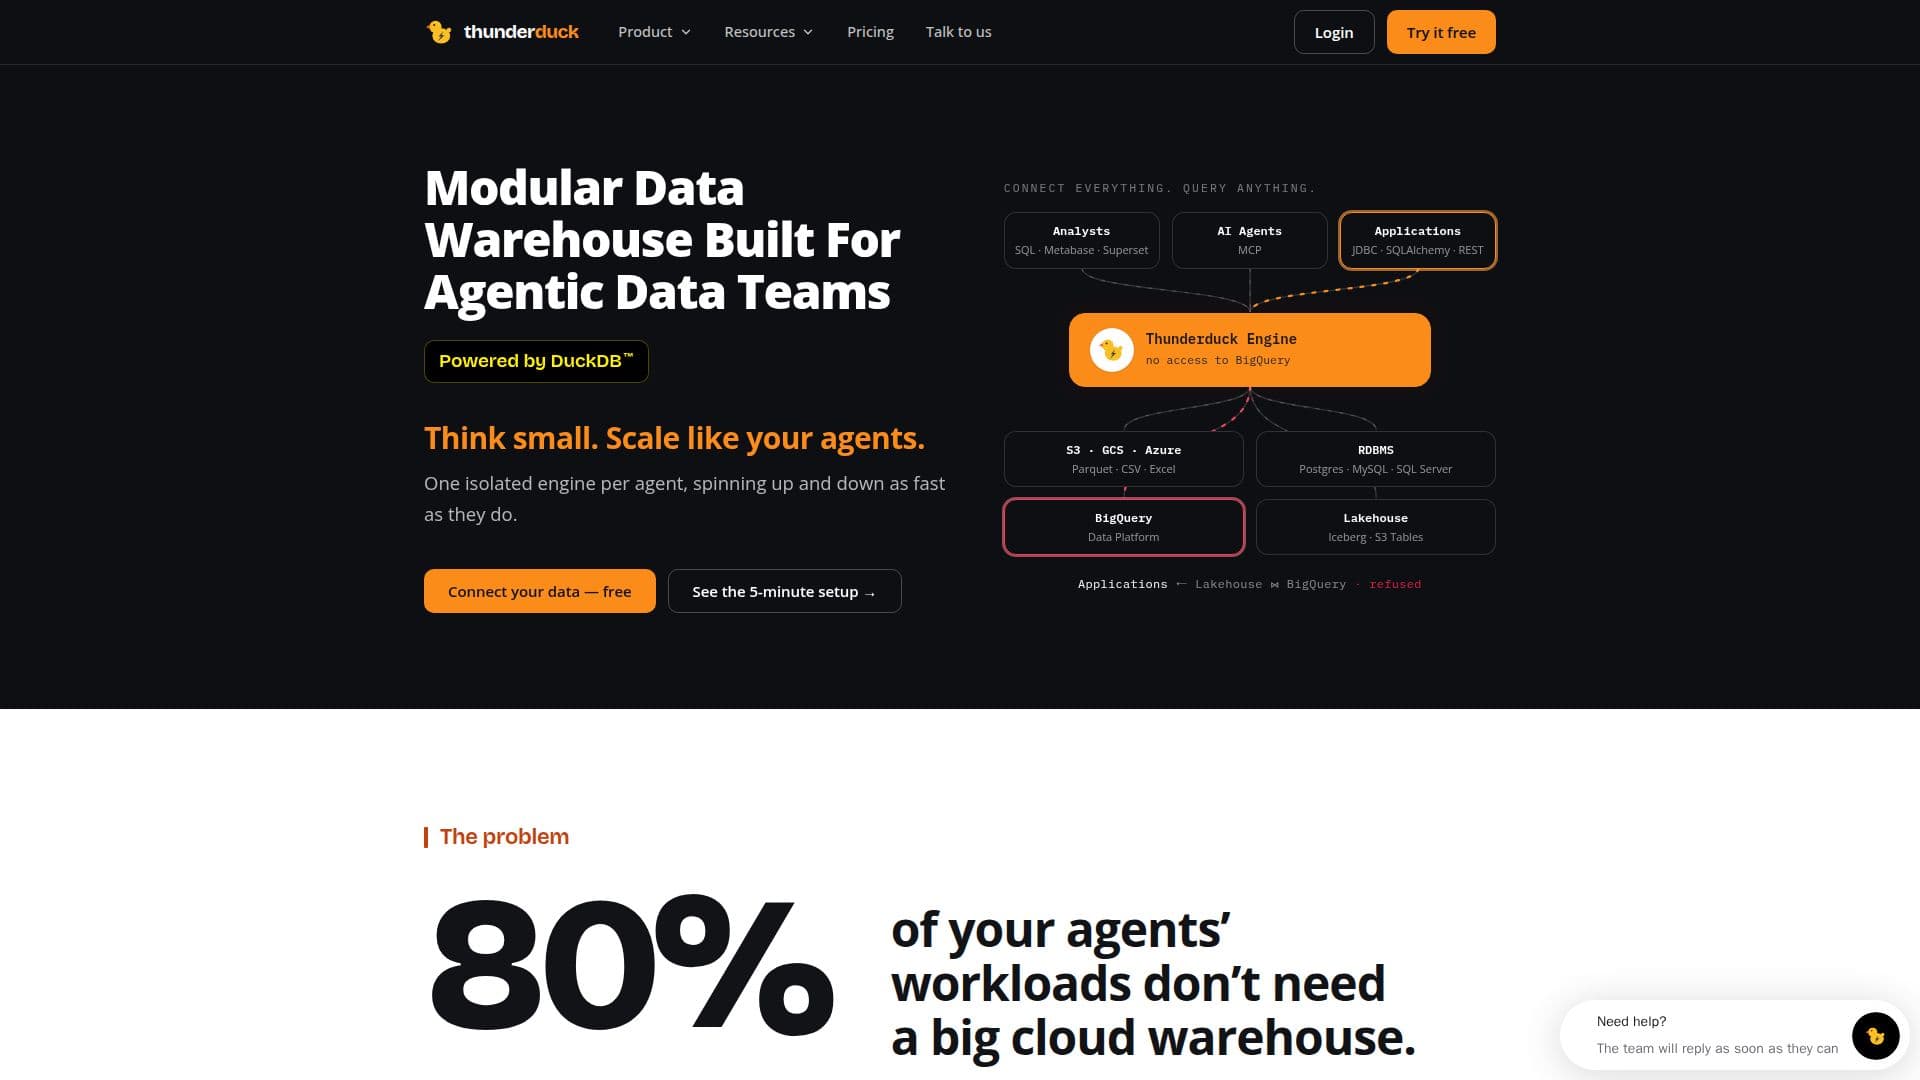
Thunderduck menawarkan solusi gudang data modular yang dirancang khusus untuk tim data agentik, memanfaatkan kekuatan DuckDB. Ini mengatasi masalah umum di mana 80% beban kerja agen tidak memerlukan gudang cloud besar, namun tim menghadapi biaya sistem terdistribusi yang signifikan dan premi layanan terkelola. Dengan menyediakan satu mesin terisolasi per agen, Thunderduck memungkinkan mesin untuk dinyalakan dan dimatikan dengan cepat, sesuai dengan sifat dinamis dari beban kerja agentik.
Baca Selengkapnya
Platform ini dirancang untuk memberikan kueri sub-detik pada terabyte data, terlepas dari jumlah agen yang berjalan. Ini menyederhanakan konstruksi jalur data dan mengotomatiskan tugas DevOps, sambil tetap mempertahankan tata kelola tingkat perusahaan. Pengguna memiliki fleksibilitas untuk menerapkan Thunderduck di mana saja, baik di tempat dengan fleksibilitas seperti cloud atau dalam infrastruktur cloud yang sudah ada.
Pada intinya, Thunderduck memanfaatkan DuckDB, sebuah basis data analitik sumber terbuka, dalam proses dengan mesin tervektorisasi. Arsitektur ini berarti ia berjalan di mana kode Anda berjalan, menghilangkan kebutuhan untuk manajemen server. Ini mendukung multi-tenancy dan menawarkan keamanan tingkat perusahaan, memastikan kedaulatan data dengan menjaga data tetap dalam cloud atau pusat data pengguna sesuai dengan aturan akses mereka.
Thunderduck memfasilitasi integrasi yang mulus dengan agen AI seperti Claude, ChatGPT, atau Cursor melalui MCP. Agen dapat menginterpretasikan makna tabel dan kolom, bukan hanya nama, untuk menemukan tabel yang tepat, membaca partisi dan indeks, serta menulis kueri yang efisien. Kueri ini berjalan di bawah peran dan batas biaya yang telah ditentukan. Platform ini juga dapat mengotomatiskan pembangunan model dbt, mengikuti lapisan medali, pengujian di cabang, dan membuka permintaan tarik untuk menjaga data mart tetap bersih dan dapat dikelola.
Ini mendukung federasi kueri tanpa ETL, memungkinkan pengguna untuk menggabungkan data dari berbagai sumber seperti Postgres, BigQuery, tabel Iceberg, dan file dalam satu kueri, dengan filter yang diterapkan pada setiap sumber. Ini menghilangkan kebutuhan untuk salinan data, pekerjaan pemuatan, atau pengawasan sinkronisasi untuk data kecil dan ad-hoc. Ketika dataset tumbuh atau memerlukan pemodelan, pengguna dapat membangun jalur dbt ke dalam Iceberg dan terus melakukan kueri secara konsisten. Thunderduck juga menyediakan estimasi biaya untuk setiap kueri sebelum dijalankan, memungkinkan kontrol anggaran dan mencegah pengeluaran yang tidak terduga.
- KategoriAlat SQL & Basis Data AI
- Model HargaFreemium
- PenerapanCloud, On-Premise
- PlatformWeb
Fitur Inti Thunderduck
Arsitektur gudang data modular
Satu mesin DuckDB terisolasi per agen
Kueri sub-detik pada terabyte data
Opsi penerapan di tempat atau di cloud
Tugas DevOps otomatis
Tata kelola tingkat perusahaan
Dukungan multi-tenant
Latensi lebih rendah tanpa overhead terdistribusi
Kedaulatan data dan aturan akses
Integrasi dengan agen AI (Claude, ChatGPT, Cursor) melalui MCP
Generasi kueri yang dibantu AI dan pembangunan model dbt
Federasi kueri di berbagai sumber (PostgreSQL, BigQuery, Iceberg, S3)
Penemuan skema, tabel, kolom, dan tipe otomatis
Estimasi biaya dan waktu untuk setiap kueri sebelum eksekusi
Diagnosis kueri gagal yang didukung AI dan perbaikan yang disarankan
Kontrol akses berbasis peran untuk katalog
Caching kueri untuk kueri ulang instan dan gratis
Cara menggunakan Thunderduck?
Hubungkan Katalog: Berikan kredensial untuk sumber data Anda seperti basis data, gudang, lakehouse, atau penyimpanan objek.
Temukan Data: Thunderduck secara otomatis membaca skema, tabel, kolom, dan menyimpulkan makna kolom, menjaga mereka tetap segar.
Kueri dan Gabungkan: Akses tabel mana pun sebagai katalog.skema.tabel dan gabungkan dari berbagai sumber dalam satu pernyataan SQL.
Integrasikan Agen AI: Hubungkan Claude, ChatGPT, atau klien MCP lainnya untuk memungkinkan agen AI menjelajahi katalog dan menjalankan SQL.
Otomatisasi Alur Kerja: Jadwalkan pernyataan SQL pada jadwal cron atau hubungkan repositori dbt untuk menjalankan pembangunan, pengujian, dan snapshot.
Pantau dan Kelola: Manfaatkan estimasi biaya pra-kueri, log audit, dan kontrol akses berbasis peran untuk mengelola penggunaan dan keamanan.
Kasus Penggunaan Thunderduck
- Beban Kerja Data Agentik
- Optimisasi Biaya untuk Tim Data
- Analitik Data Waktu Nyata
- Otomatisasi Jalur Data
- Kedaulatan dan Keamanan Data
- Pengkuerian yang Dibantu AI
- Penggabungan Data Lintas Sumber
- Manajemen Biaya Proaktif
- Tata Kelola dan Audit Data
- Pembangunan Lakehouse