Deskripsi
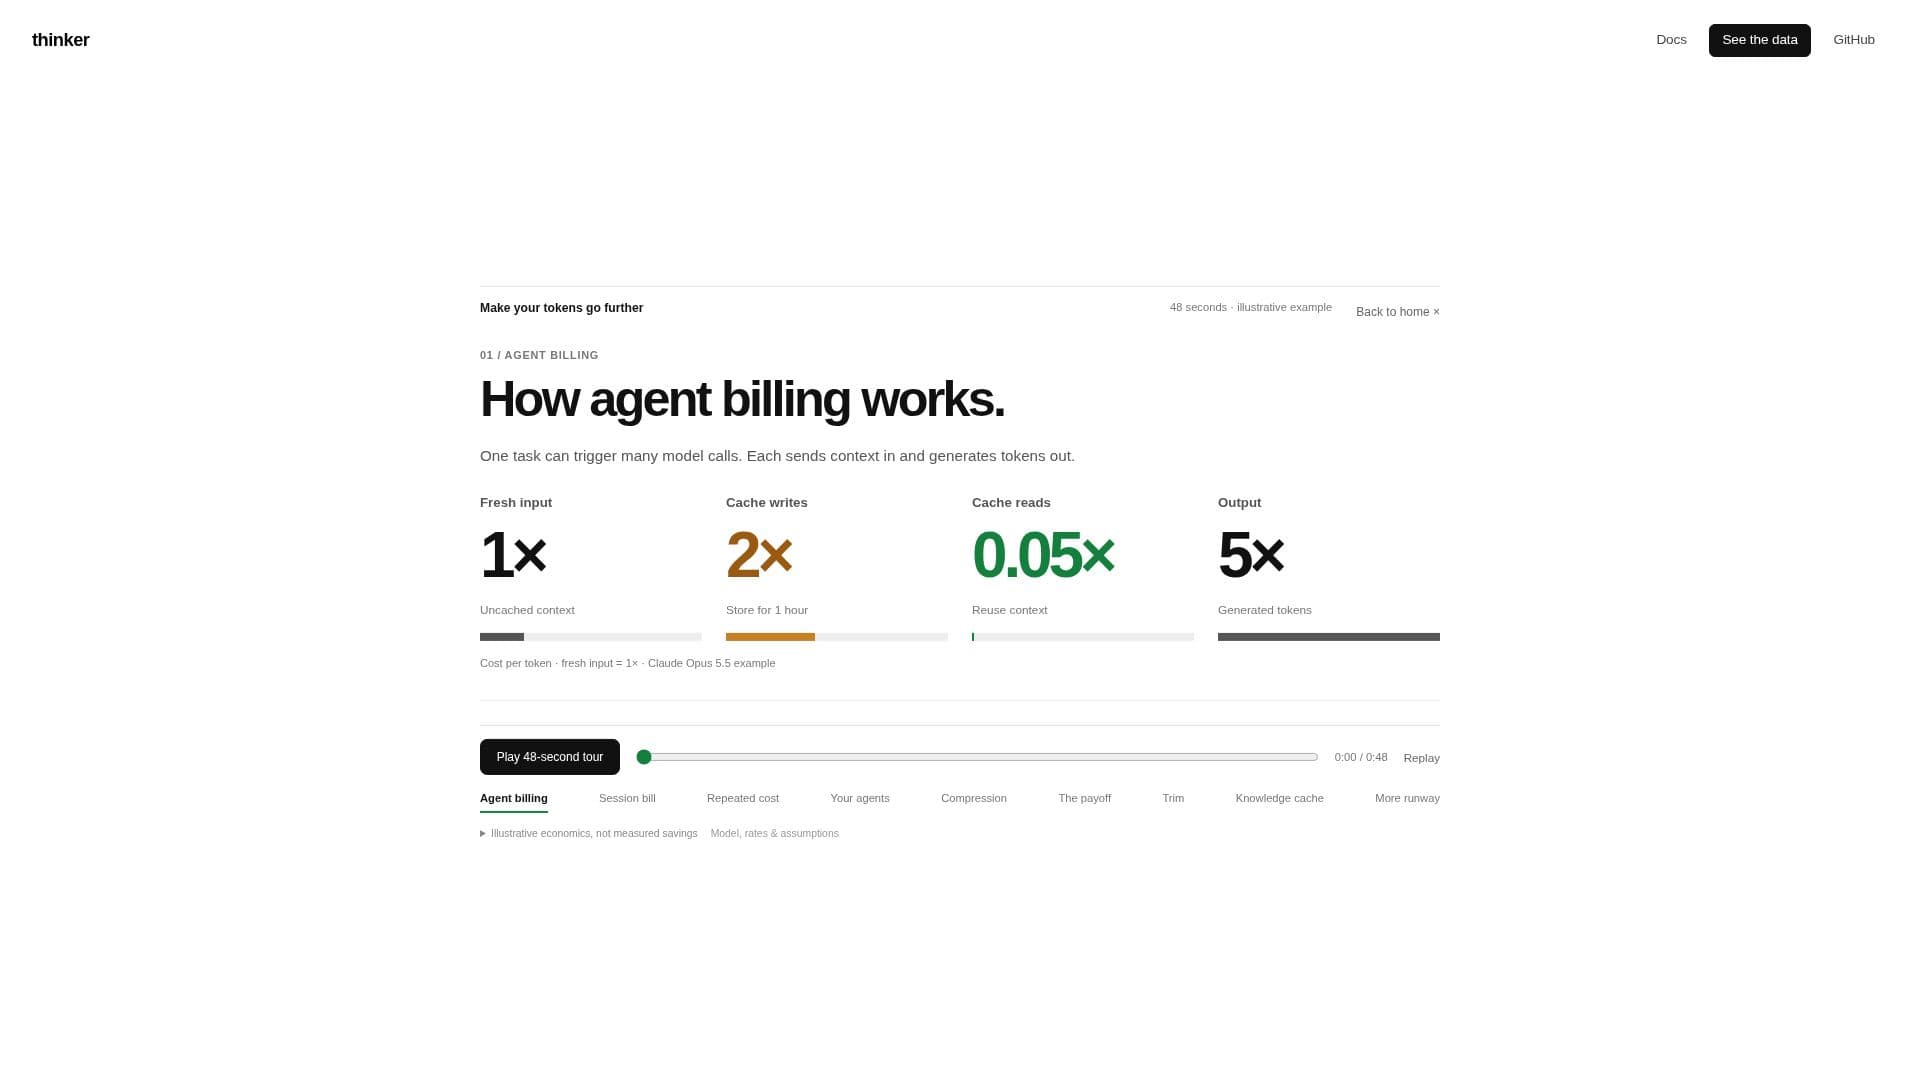
Thinker adalah alat khusus yang dirancang untuk mengoptimalkan kinerja dan efisiensi biaya agen AI dengan mengelola penggunaan token mereka secara cerdas. Ini mengatasi tantangan umum di mana agen memproses konteks yang sama berulang kali, yang dapat menyebabkan peningkatan biaya dan operasi yang lebih lambat. Thinker mencapai ini melalui tiga mekanisme inti: kompresi konteks, pemangkasan instruksi, dan cache pengetahuan.
Baca Selengkapnya
Kompresi konteks secara otomatis mengidentifikasi dan menghapus informasi yang redundan atau kurang relevan dari konteks agen, memastikan bahwa hanya data penting yang dibawa ke dalam panggilan berikutnya. Ini secara signifikan mengurangi jumlah token yang diproses per panggilan, membuat interaksi agen lebih efisien. Misalnya, ia dapat memangkas keluaran alat yang besar, hanya mempertahankan bagian yang paling relevan untuk referensi di masa mendatang.
Pemangkasan instruksi menganalisis file instruksi dan pengaturan alat untuk mengidentifikasi dan menghilangkan instruksi yang tidak perlu atau memiliki utilitas rendah yang mungkin diproses agen berulang kali. Dengan fokus pada instruksi yang benar-benar layak, Thinker membantu agen beroperasi dengan seperangkat arahan yang lebih ramping dan efektif, lebih lanjut menghemat token dan meningkatkan kecepatan pemrosesan. Pengguna dapat meninjau dan menerapkan pemotongan yang disarankan, yang kemudian diintegrasikan ke dalam konfigurasi agen mereka.
Cache pengetahuan memungkinkan agen untuk belajar dan menggunakan kembali informasi, mencegah kebutuhan untuk memproses kembali pengetahuan yang sama. Ketika agen mempelajari informasi baru, itu dapat disimpan sebagai 'catatan' (misalnya, aturan, peta, cara, perilaku) dan diambil saat relevan. Cache ini bersifat dinamis, belajar dari setiap sesi dan mengetahui kapan catatan menjadi usang, memastikan bahwa agen selalu memiliki akses ke pengetahuan yang terkini dan relevan tanpa menanggung biaya token berulang untuk eksplorasi.
Thinker mendukung berbagai agen AI populer, termasuk Claude Code, Codex CLI, Gemini CLI, Cursor, Devin CLI, Pi, Windsurf Cascade, GitHub Copilot CLI, dan OpenCode. Ini terintegrasi dengan menginstal secara lokal dan menghubungkan ke pengaturan agen, memungkinkan operasi yang mulus. Platform ini menyediakan tampilan seperti 'Temukan Penghematan' untuk memantau biaya dan penggunaan konteks, 'Lihat Laporan' untuk melacak biaya token dari waktu ke waktu, dan 'Aktivitas Terbaru' untuk mengelola perubahan yang diterapkan. Ekonomi ilustratif Thinker menunjukkan penghematan signifikan dengan mengurangi input baru, penulisan baru, dan token keluaran, pada akhirnya memperpanjang jalur efektif untuk tugas agen dalam batas token yang ada.
- KategoriAlat Rekayasa Prompt
- Model HargaBerbayar
- PenerapanLokal
- PlatformWeb
Fitur Inti Thinker
Kompresi Konteks Otomatis: Mengurangi konteks yang berulang dalam sesi agen.
Pemangkasan Instruksi: Menganalisis dan menghapus token instruksi yang tidak perlu.
Cache Pengetahuan: Menyimpan dan menggunakan kembali informasi yang dipelajari untuk menghindari pemrosesan ulang.
Optimisasi Biaya Token: Membantu agen beroperasi dalam batas token dengan lebih efisien.
Integrasi Agen: Terhubung dengan berbagai agen AI seperti Claude Code, Codex, Gemini, Cursor, Devin, Pi, Copilot CLI, OpenCode.
Pemangkasan Keluaran: Fitur opsional untuk memangkas hasil alat sebelum masuk ke konteks.
Pelaporan Penggunaan: Memberikan wawasan tentang biaya konteks dan penggunaan token dari waktu ke waktu.
Manajemen Perubahan: Melacak dan memungkinkan pengelolaan pemotongan konteks dan perubahan yang diterapkan.
Penyimpanan Data Lokal: Menyimpan catatan dan konfigurasi secara lokal di bawah ~/.thinker.
Integrasi GitHub: Mengelola perubahan instruksi melalui permintaan tarik untuk ditinjau.
Dukungan Multi-Bahasa: Menggunakan parser tree-sitter untuk Python, JavaScript, TypeScript, Go, Rust.
Pembelajaran yang Dapat Dikonfigurasi: Memungkinkan kontrol atas distilasi sesi dan verifikasi.
Kontrol Telemetri: Opsi untuk menonaktifkan pengiriman metrik demi privasi.
Beberapa Jenis Cache: Mendukung berbagai jenis cache untuk alat, instruksi, konteks RAG, dan riwayat percakapan.
Manajemen Invalidasi Cache: Merinci perubahan apa yang menginvalidasi segmen cache yang berbeda.
Cara menggunakan Thinker?
Instal Thinker: Instal Thinker secara lokal, yang mengatur di bawah ~/.thinker dan menghubungkan ke pengaturan agen Anda.
Analisis Penggunaan: Thinker menghasilkan laporan awal dengan membaca sesi terbaru dari repositori aktif Anda.
Identifikasi Penghematan: Gunakan tampilan 'Temukan Penghematan' untuk melihat biaya dan penggunaan konteks, serta mengidentifikasi area untuk pemotongan.
Terapkan Kompresi Konteks: Aktifkan kompresi konteks otomatis di mana didukung oleh agen Anda.
Pemangkasan Instruksi: Tinjau pemotongan instruksi yang disarankan dan terapkan untuk mengurangi token yang terbuang.
Manfaatkan Cache Pengetahuan: Biarkan Thinker belajar dari sesi dan menggunakan kembali pengetahuan melalui catatan.
Pantau Kinerja: Gunakan 'Lihat Laporan' untuk melacak biaya token dan penghematan cache dari waktu ke waktu.
Kelola Perubahan: Tinjau dan kelola semua perubahan yang diterapkan dan statusnya di bawah 'Aktivitas Terbaru'.
Kasus Penggunaan Thinker
- Mengoptimalkan Penggunaan Token Agen
- Pengurangan Biaya untuk Agen AI
- Meningkatkan Efisiensi Agen
- Mengelola Alur Kerja Pengembang
- Manajemen Pengetahuan untuk Agen
- Debugging Konteks Agen
- Kustomisasi Instruksi Agen
- Memperpanjang Batas Penggunaan Agen