Deskripsi
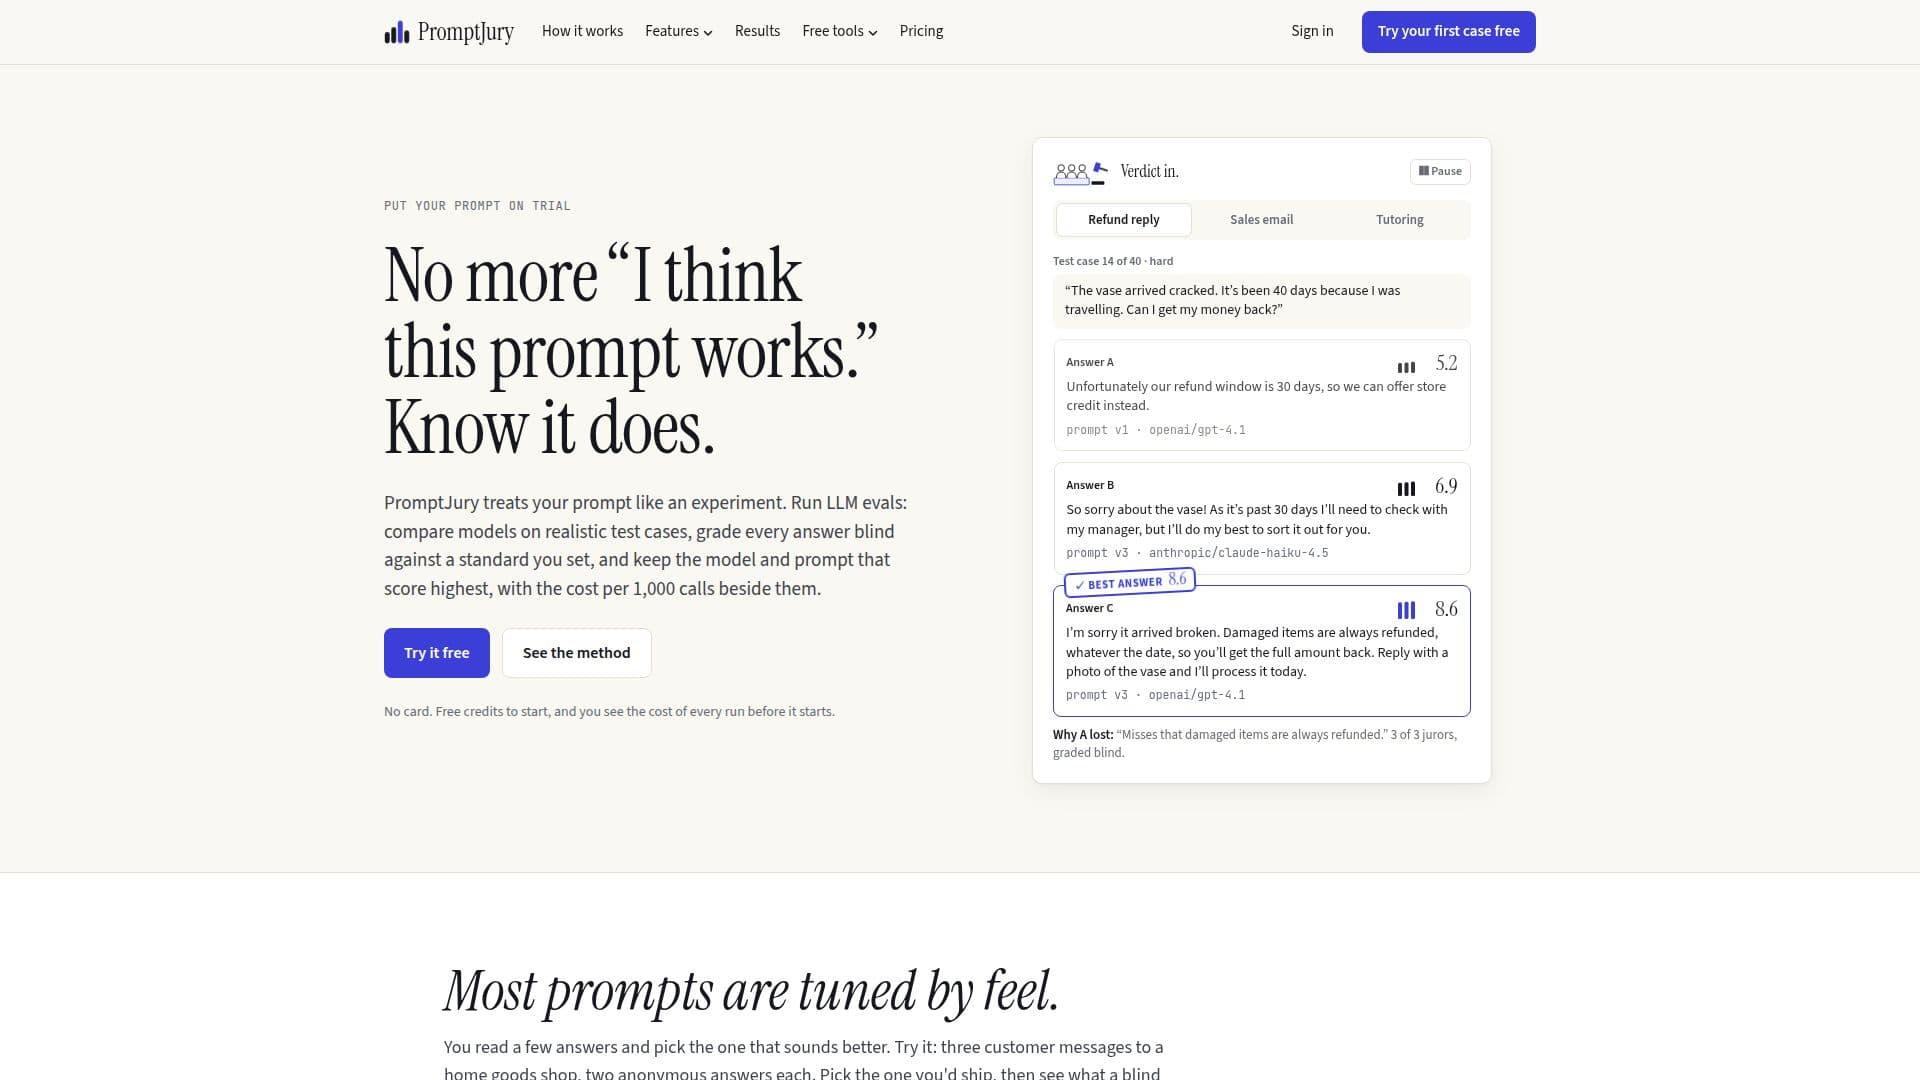
PromptJury menawarkan platform komprehensif untuk mengevaluasi Model Bahasa Besar (LLM) dan prompt, dirancang untuk membantu pengguna membuat keputusan berbasis data tentang aplikasi AI mereka. Layanan ini memungkinkan individu dan tim untuk menjalankan evaluasi LLM pada prompt kustom mereka, membandingkan model seperti GPT, Claude, dan Gemini pada kasus uji yang dinilai secara buta.
Baca Selengkapnya
Proses ini mengungkap kombinasi model dan prompt mana yang mencapai skor tertinggi dan berapa biaya masing-masing opsi, memberikan pendekatan ilmiah untuk rekayasa prompt.
Berbeda dengan platform evaluasi yang berfokus pada pengembang yang memerlukan SDK, konfigurasi kustom, dan set uji yang disediakan pengguna, PromptJury menyederhanakan seluruh alur kerja evaluasi. Ini secara otomatis menghasilkan panduan penilaian dan kasus uji, menyusun prompt saingan, dan melakukan penilaian buta menggunakan juri yang beragam dari berbagai pembuat. Platform ini kemudian memberikan rekomendasi yang jelas, termasuk prompt pemenang, model, dan biaya terkait, semuanya tanpa memerlukan keahlian pengkodean.
PromptJury memastikan ketelitian ilmiah dari evaluasinya dengan menetapkan definisi yang jelas tentang "jawaban yang baik" sebelum penilaian dimulai. Setiap prompt dan model dikenakan pada set kasus uji yang sama, dan penilaian dilakukan secara buta. Setiap skor disajikan dengan rentang, memungkinkan pengguna untuk menilai dampak dari perubahan yang dilakukan pada prompt atau model mereka. Sistem ini mengatasi kekhawatiran tentang AI yang menilai AI dengan memastikan bahwa standar penilaian disetujui pengguna, beberapa model dari pembuat yang berbeda menilai jawaban tanpa mengetahui sumbernya, dan tidak ada model yang menilai outputnya sendiri. Skor median dari tiga atau lebih penilai mencegah bias dari satu juri yang keras atau dermawan.
Pengguna dapat membandingkan model obrolan apa pun yang tersedia di daftar langsung OpenRouter, termasuk penawaran dari OpenAI, Anthropic, Google, xAI, DeepSeek, dan Mistral. Platform ini juga membantu mengidentifikasi model yang lebih murah yang berkinerja sebanding dengan pesaing teratas, memberikan "pilihan nilai" di samping pemenang. Ini termasuk data biaya per 1.000 panggilan dan potensi penghematan bulanan berdasarkan volume panggilan yang ditentukan pengguna. Akun baru menerima 200 kredit gratis untuk menjalankan evaluasi awal tanpa memerlukan kartu kredit, dengan rencana berbayar mulai dari $25 per bulan. Layanan ini tidak memerlukan kunci API, SDK, atau akun OpenRouter, karena semua panggilan model dikelola melalui akun OpenRouter milik PromptJury dan dibayar dengan kredit pengguna. Platform ini mendukung output subjektif dengan memungkinkan pengguna untuk mendefinisikan dimensi kualitas dengan contoh tertulis untuk penilaian. Pengguna juga dapat mengunggah kasus uji mereka sendiri melalui file CSV atau JSONL atau mengedit yang dihasilkan sistem. PromptJury secara eksplisit menyatakan bahwa ia tidak melatih pada prompt atau data pengguna, memastikan privasi dan kontrol atas konten pengguna.
- KategoriAlat Rekayasa Prompt
- Model HargaFreemium
- PenerapanCloud
- PlatformWeb
Fitur Inti PromptJury
Platform Evaluasi LLM
Bandingkan GPT, Claude, Gemini, dan model lainnya
Kasus uji yang dinilai secara buta
Pembuatan kasus uji otomatis
Pembuatan panduan penilaian otomatis
Menyusun prompt saingan
Proses evaluasi tanpa kode
Biaya per 1.000 panggilan ditampilkan
Mengidentifikasi pilihan nilai (model baik termurah)
Mendukung penilaian output subjektif
Unggah kasus uji kustom (CSV, JSONL)
Tidak memerlukan kunci API atau SDK
Tidak melatih pada data pengguna
Pengujian regresi terjadwal (pengulangan)
Laporan putusan pribadi
Cara menggunakan PromptJury?
Deskripsikan Tugas: Definisikan tujuan AI Anda dan audiensnya dalam dua kalimat.
Buat Panduan Penilaian: Setujui seperti apa jawaban yang hebat, dimensi demi dimensi, dengan skala untuk masing-masing.
Hasilkan Prompt Saingan: Biarkan model menyusun prompt saingan dan mengkritik satu sama lain berdasarkan panduan penilaian Anda.
Kumpulkan Kasus Uji: Gunakan input realistis yang dihasilkan sistem atau unggah file CSV/JSONL Anda sendiri.
Jalankan Uji Buta: Setiap prompt dan model menjawab setiap kasus uji, dengan panel terpisah yang menilai jawaban secara buta.
Tinjau Putusan & Tingkatkan: Dapatkan prompt dan model terbaik, dengan bukti dan saran untuk perbaikan lebih lanjut.
Kasus Penggunaan PromptJury
- Optimasi Prompt
- Perbandingan Model
- Jaminan Kualitas
- Efisiensi Biaya
- Penilaian Output Subjektif
- Pengujian Regresi
- Pelaporan Klien
- Pengembangan Fitur AI