Deskripsi
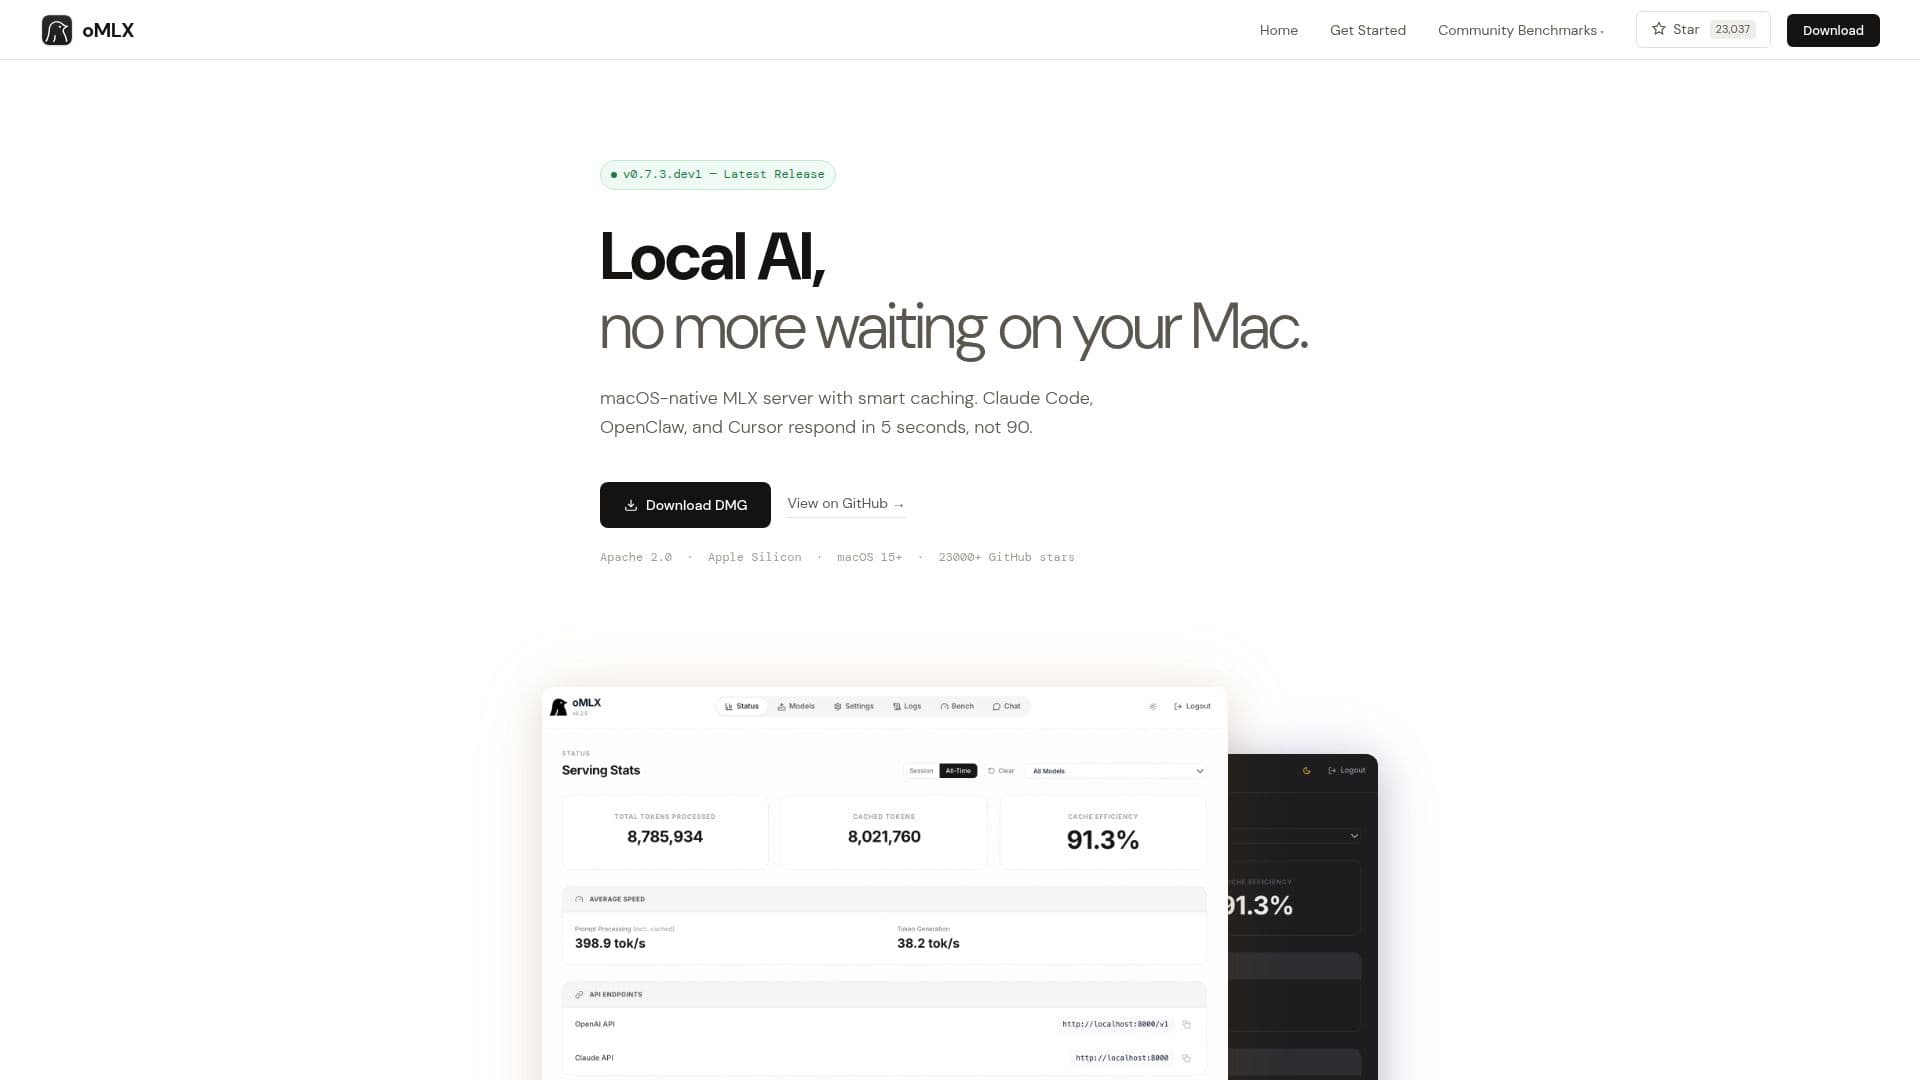
oMLX adalah server inferensi mutakhir yang dirancang khusus untuk macOS, memanfaatkan kekuatan Apple Silicon. Dibangun di atas kerangka kerja MLX, ini menawarkan solusi asli untuk menjalankan model bahasa besar (LLM) secara lokal di komputer Mac. Salah satu fitur unggulannya adalah caching KV SSD yang dipaged, yang secara drastis mengurangi waktu hingga token pertama (TTFT) dari 30-90 detik menjadi kurang dari 5 detik. Peningkatan ini sangat bermanfaat bagi agen pengkodean yang sering membatalkan cache, karena oMLX memastikan bahwa setiap blok cache disimpan di SSD, memungkinkan pemulihan cepat dari disk.
Baca Selengkapnya
Server ini kompatibel dengan API populer seperti OpenAI dan Anthropic, menjadikannya alat yang serbaguna bagi pengembang yang bekerja dengan platform ini. Ini mendukung batching berkelanjutan dan menyediakan API drop-in untuk model seperti Claude Code, OpenClaw, dan Cursor, memastikan bahwa respons disampaikan dalam hitungan detik. Benchmark kinerja yang dilakukan pada M3 Ultra dengan RAM 512GB menunjukkan throughput dan efisiensi memori yang mengesankan di berbagai konteks dan ukuran batch.
oMLX dirancang untuk pengembang dan penggemar AI yang memerlukan solusi AI lokal yang cepat dan andal di Mac mereka. Ini menghilangkan kebutuhan untuk inferensi berbasis cloud, mengurangi latensi dan ketergantungan pada server eksternal. Alat ini bersifat open-source di bawah lisensi Apache 2.0, dengan kehadiran komunitas yang kuat, seperti yang dibuktikan oleh lebih dari 23.000 bintang di GitHub. Pengguna dapat dengan mudah memulai dengan mengunduh DMG atau menginstal dari sumber, dengan kompatibilitas untuk cache Hugging Face standar dan folder LM Studio.
Secara keseluruhan, oMLX menawarkan solusi yang kuat dan efisien untuk menjalankan model AI secara lokal di macOS, memberikan peningkatan kecepatan yang signifikan dan integrasi yang mulus dengan alur kerja AI yang ada.
- KategoriMLOps & Penerapan Model
- Model HargaOpen source
- PenerapanLokal
- PlatformmacOS 15+
Fitur Inti oMLX
Server inferensi macOS asli
Caching KV SSD yang dipaged
Kompatibilitas API OpenAI & Anthropic
Dukungan batching berkelanjutan
API drop-in untuk Claude Code, OpenClaw, dan Cursor
Pemulihan cache cepat dari SSD
Open-source di bawah Apache 2.0
Lebih dari 23.000 bintang di GitHub
Cara menggunakan oMLX?
Unduh: Dapatkan DMG atau sumber
Instal: Ikuti petunjuk instalasi
Konfigurasi: Siapkan dengan cache Hugging Face
Gunakan: Jalankan model dengan TTFT yang lebih rendah
Optimalkan: Manfaatkan batching berkelanjutan
Kasus Penggunaan oMLX
- Pengembangan AI Lokal
- Integrasi API
- Agen Pengkodean
- Pemrosesan Batch
- Kontribusi Open-Source