

Deskripsi
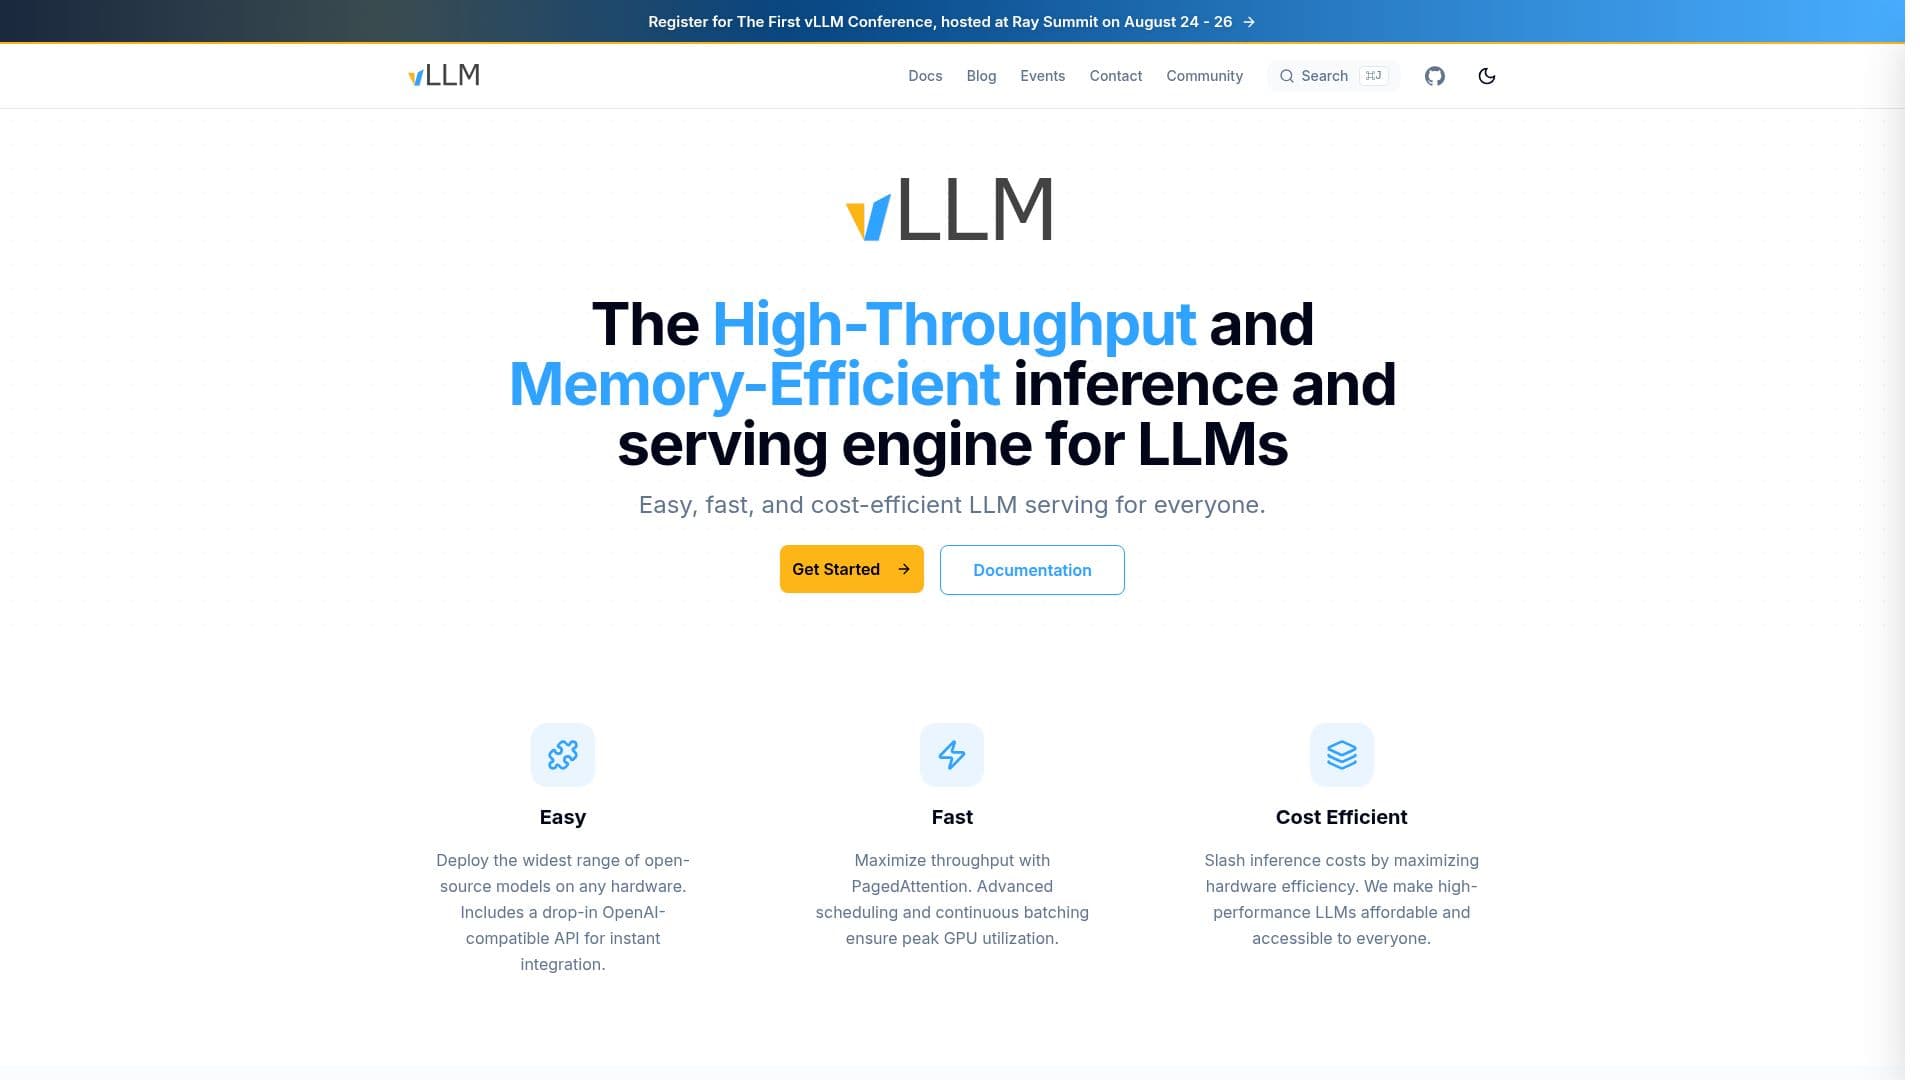
vLLM dirancang untuk mengoptimalkan inferensi dan penyajian Model Bahasa Besar (LLM) dengan fokus pada throughput tinggi dan efisiensi memori. Mesin ini memanfaatkan teknik canggih seperti kernel GEMM/MoE yang dioptimalkan untuk berbagai presisi, menggunakan kerangka kerja seperti CUTLASS dan TRTLLM-GEN. Tujuan dari vLLM adalah untuk memberikan pengalaman yang mulus dalam menerapkan model AI, memastikan bahwa pengguna dapat mencapai kinerja terbaik tanpa kompleksitas yang biasanya terkait dengan penyajian LLM.
Baca Selengkapnya
Platform ini dibangun untuk kompatibilitas universal, memungkinkan integrasi dengan berbagai konfigurasi perangkat keras, termasuk dukungan untuk GPU NVIDIA, GPU AMD, dan TPU Google. Fleksibilitas ini menjadikan vLLM pilihan ideal bagi pengembang dan organisasi yang ingin menerapkan solusi AI di berbagai lingkungan. Pengguna dapat dengan cepat mulai menggunakan vLLM dengan pengaturan minimal, berkat proses konfigurasi yang sederhana.
vLLM juga menawarkan pendekatan yang didorong oleh komunitas, dengan forum yang tersedia bagi pengguna untuk mendiskusikan topik mulai dari dukungan perangkat keras hingga integrasi model. Lingkungan kolaboratif ini mendorong berbagi pengetahuan dan membantu pengguna mengoptimalkan penggunaan platform. Selain itu, vLLM mendukung berbagai model, termasuk arsitektur populer seperti Llama, BART, dan GPT, di antara lainnya.
Singkatnya, vLLM menonjol sebagai alat yang kuat bagi siapa saja yang ingin menerapkan LLM secara efisien. Kombinasi kinerja, kemudahan penggunaan, dan dukungan komunitas menjadikannya sumber daya yang berharga di bidang AI yang berkembang pesat.
- KategoriMLOps & Penerapan Model
- Model HargaSumber Terbuka
- PenerapanCloud
- PlatformNVIDIA, AMD, Google TPU
Fitur Inti vLLM
Throughput Tinggi
Efisiensi Memori
Kompatibilitas Universal
Kernel GEMM/MoE yang Dioptimalkan
Dukungan untuk Berbagai Perangkat Keras
Forum Komunitas
Konfigurasi Mulai Cepat
Dukungan Model yang Luas
Cara menggunakan vLLM?
Konfigurasi: Siapkan lingkungan perangkat keras Anda untuk mendukung vLLM.
Instal: Ikuti petunjuk instalasi yang diberikan dalam dokumentasi.
Terapkan: Muat model AI yang Anda inginkan ke dalam mesin vLLM.
Optimalkan: Sesuaikan konfigurasi untuk kinerja berdasarkan kasus penggunaan spesifik Anda.
Kasus Penggunaan vLLM
- Penerapan Model AI
- Optimasi Kinerja
- Keterlibatan Komunitas
- Integrasi Model Kustom
- Kompatibilitas Lintas Platform






