Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

Flide

Flide adalah infrastruktur inferensi berkinerja tinggi yang dirancang untuk model keputusan gaya Jev. Ini mempercepat inferensi keputusan dengan membagi satu keadaan menjadi semua pertanyaannya dalam satu langkah maju, memastikan setiap pertanyaan menerima jawaban yang identik dengan apa yang akan didapatkan jika ditanyakan sendiri. Pendekatan ini secara signifikan meningkatkan throughput dan mempertahankan akurasi tinggi untuk proses pengambilan keputusan yang kompleks.

Kunjungi URL
Bagikan
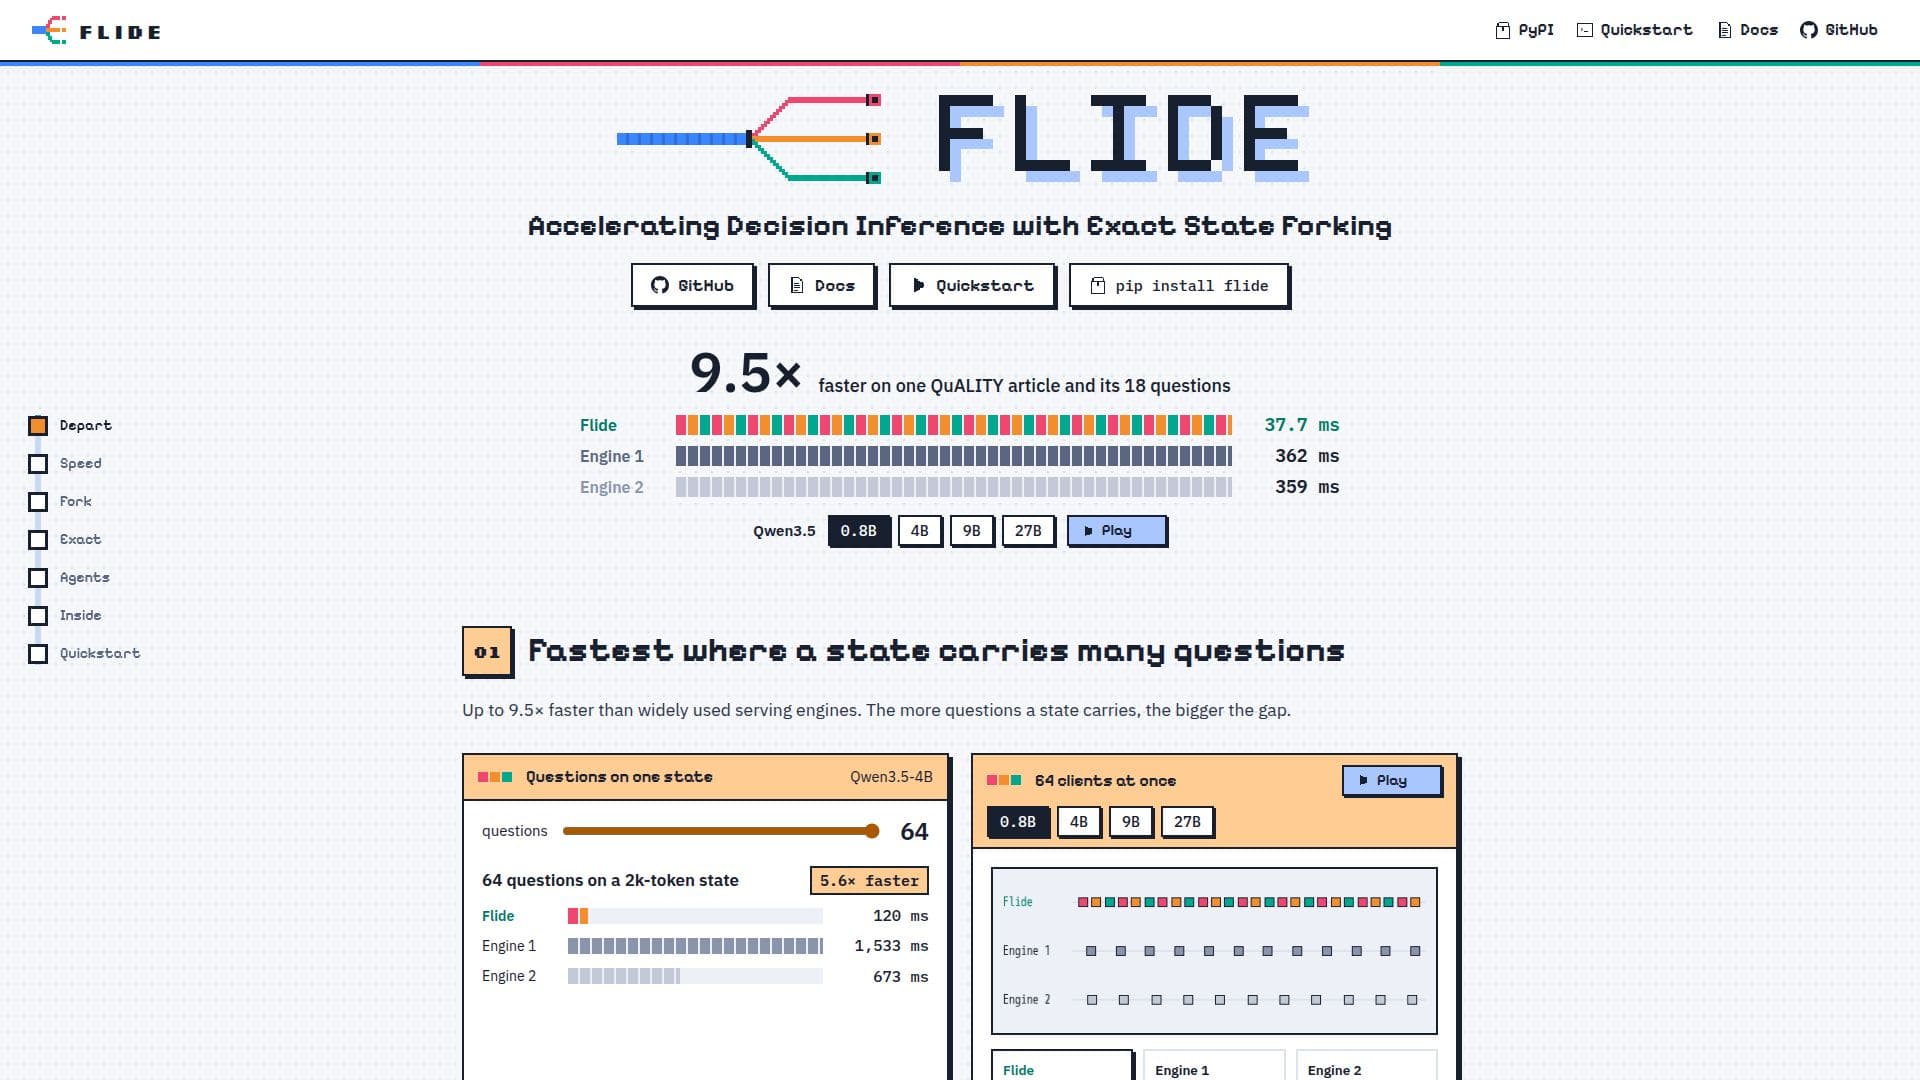
Tangkapan layar Flide

Flide adalah infrastruktur inferensi canggih yang secara khusus dirancang untuk mempercepat model keputusan gaya Jev. Inovasi inti terletak pada kemampuannya untuk melakukan pemisahan keadaan yang tepat, memungkinkan satu keadaan input diproses untuk beberapa pertanyaan dalam satu langkah maju. Ini berarti keadaan dibaca hanya sekali, dan kemudian dibagi secara efisien, memastikan bahwa setiap pertanyaan menerima jawaban yang tepat seperti yang akan didapatkan jika ditanyakan secara terpisah.

Baca Selengkapnya

Arsitektur unik ini memberikan peningkatan kinerja yang substansial, dengan Flide menunjukkan inferensi hingga 9,5 kali lebih cepat dibandingkan dengan mesin penyajian yang banyak digunakan seperti vLLM dan SGLang. Keuntungan kinerja menjadi semakin jelas seiring dengan meningkatnya jumlah pertanyaan yang terkait dengan keadaan tertentu. Misalnya, dengan 64 pertanyaan pada keadaan 2k-token, Flide mencapai percepatan 9,5x dan throughput 2,2x lebih tinggi dengan 64 klien.

Selain kecepatan, Flide memprioritaskan akurasi, tetap dalam 1,1 poin dari referensi float32, menjadikannya salah satu mesin yang paling mendekati referensi kebenaran. Ini mendukung berbagai model, termasuk model obrolan berbasis Qwen3.5 dan Gemma 4, serta model OneJev. Flide juga menangani model hibrida, di mana lapisan Gated DeltaNet memastikan setiap pertanyaan dimulai dari keadaan tepat dari konteks bersama. Sistem ini menawarkan opsi `--batch-invariant`, menjamin bahwa permintaan menghasilkan bit yang sama terlepas dari bagaimana ia dikelompokkan.

Instalasi sangat mudah melalui pip, dan mendukung penyajian dengan kernel yang telah dibangun sebelumnya untuk berbagai GPU NVIDIA, termasuk A40, A10, RTX 30, H100, dan H200. Flide mengekspos API `/v1/systemone` yang sama seperti vLLM dan SGLang, memberikan probabilitas untuk setiap opsi dalam jawaban. Ini mendukung input multimodal, termasuk teks, gambar, dan video, tergantung pada model backbone. Fitur seperti kuantisasi FP8 untuk Qwen3.5 pada GPU Ada, Hopper, dan Blackwell, serta cache sesi untuk melanjutkan keadaan agen, semakin meningkatkan kemampuannya.

  • KategoriMLOps & Penerapan Model
  • PenerapanDi-host Sendiri
  • PlatformWeb

  • Pemisahan Keadaan yang Tepat: Memproses satu keadaan untuk semua pertanyaan dalam satu langkah maju.

  • Inferensi Dipercepat: Hingga 9,5x lebih cepat daripada mesin penyajian lainnya.

  • Throughput Tinggi: Mencapai throughput 2,2x dengan 64 klien pada tolok ukur tertentu.

  • Proksimitas Referensi Float32: Tetap dalam 1,1 poin dari referensi float32 untuk akurasi.

  • Invarian Batch: Menjamin hasil yang konsisten terlepas dari pengelompokan dengan `--batch-invariant`.

  • Mekanisme ForkAttention: Setiap pertanyaan membaca keadaannya di tempat, seolah-olah ditanyakan sendiri.

  • Tepat pada Model Hibrida: Mendukung lapisan Gated DeltaNet untuk penanganan konteks yang tepat.

  • Pemrosesan Aliran Datar Tunggal: Menjalankan permintaan sebagai aliran token tunggal yang diputar ulang oleh grafik CUDA.

  • API Kompatibel vLLM/SGLang: Menggunakan standar API `/v1/systemone`.

  • Kernel yang Dibangun Sebelumnya: Dioptimalkan untuk GPU NVIDIA A40, A10, RTX 30, H100, dan H200.

  • Model Backbone: Mendukung Qwen3.5 (0.8B, 2B, 4B, 9B, 27B) dan Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).

  • Input Multimodal: Menangani input teks, gambar, dan video.

  • Kuantisasi FP8: Menjalankan Qwen3.5 dalam FP8 pada GPU Ada, Hopper, dan Blackwell.

  • Cache Sesi: Menyimpan keadaan sebelumnya untuk agen untuk melanjutkan dari (misalnya, `--session-cache-gb 40`).

  • Proses Frontend: Mendukung menjalankan HTTP, rendering, dan tokenisasi dalam proses terpisah untuk banyak klien.

  1. Instal Flide: Gunakan pip untuk menginstal paket Flide.

  2. Mulai Server: Jalankan `flide serve` untuk memulai server inferensi, dengan opsi untuk menentukan `--host`.

  3. Konfigurasi Model: Sajikan model obrolan seperti Qwen3.5 atau Gemma 4 secara langsung, atau gabungkan adaptor Open-Jev.

  4. Kirim Permintaan: Berinteraksi dengan server menggunakan API `/v1/systemone` untuk mengirim keadaan dan pertanyaan.

  5. Proses Input Multimodal: Sertakan jalur gambar dalam keadaan dan kirim media untuk model yang mendukung gambar.

  • Model Keputusan Dipercepat
  • Inferensi Multimodal
  • Pemrosesan Batch Konsisten
  • Manajemen Keadaan Agen
  • Penyajian LLM Berkinerja Tinggi
  • Penelitian & Pengembangan

Ulasan Flide

Memuat...

Alat AI Populer Seperti Flide

vLLM

Aplikasi AI

vLLM adalah mesin inferensi dan penyajian yang efisien dalam memori dan throughput tinggi untuk Model Bahasa Besar (LLM). Ini memungkinkan penerapan model AI yang lebih cepat…

MLOps & Penerapan Model
Lihat Alat

Aplikasi AI

Mesin inferensi dan penyajian yang efisien dalam memori dan throughput tinggi untuk Model Bahasa Besar (LLM). Ini memungkinkan penerapan model AI yang lebih cepat…vLLM adalah mesin inferensi dan penyajian yang efisien dalam memori dan throughput tinggi untuk Model Bahasa Besar (LLM). Ini memungkinkan penerapan model AI yang lebih cepat…

MLOps & Penerapan Model
Lihat Top 250 Aplikasi AI

General Compute

Aplikasi AI

Penyedia inferensi AI berkecepatan tinggi yang menyajikan model pada infrastruktur ASIC yang dirancang khusus melalui API yang kompatibel dengan OpenAI, menawarkan waktu ke token…

MLOps & Penerapan Model
Lihat Alat

Aplikasi AI

Penyedia inferensi AI berkecepatan tinggi yang menyajikan model pada infrastruktur ASIC yang dirancang khusus melalui API yang kompatibel dengan OpenAI, menawarkan waktu ke token…

MLOps & Penerapan Model
Lihat Top 250 Aplikasi AI

Inference.net

Aplikasi AI

Inference.net menyediakan infrastruktur untuk tim yang berbasis AI untuk menjalankan, memantau, dan mengoptimalkan beban kerja AI. Ini menawarkan inferensi yang sangat cepat untuk…

MLOps & Penerapan Model

Peringkat 78 untuk Menyempurnakan model AI

Lihat Alat

Aplikasi AI

Menyediakan infrastruktur untuk tim yang berbasis AI untuk menjalankan, memantau, dan mengoptimalkan beban kerja AI. Ini menawarkan inferensi yang sangat cepat untuk…Inference.net menyediakan infrastruktur untuk tim yang berbasis AI untuk menjalankan, memantau, dan mengoptimalkan beban kerja AI. Ini menawarkan inferensi yang sangat cepat untuk…

MLOps & Penerapan Model
Peringkat 78 untuk Menyempurnakan model AI

Jev AI

Aplikasi AI

Jev AI adalah alat kecerdasan keputusan untuk tim perangkat lunak, menawarkan model AI cepat tanpa daftar tunggu. Ini mengubah keadaan dunia nyata menjadi keputusan terstruktur…

Alat DevOps & Cloud AI
Lihat Alat

Aplikasi AI

Alat kecerdasan keputusan untuk tim perangkat lunak, menawarkan model AI cepat tanpa daftar tunggu. Ini mengubah keadaan dunia nyata menjadi keputusan terstruktur…Jev AI adalah alat kecerdasan keputusan untuk tim perangkat lunak, menawarkan model AI cepat tanpa daftar tunggu. Ini mengubah keadaan dunia nyata menjadi keputusan terstruktur…

Alat DevOps & Cloud AI
Lihat Top 250 Aplikasi AI

JevModel

Aplikasi AI

JevModel adalah platform yang menggunakan model Jev untuk keputusan AI terstruktur, menawarkan output Choice, Score, dan Noul. Ini memungkinkan pengguna untuk menguji teks atau…

Platform Machine Learning
Lihat Alat

Aplikasi AI

Platform yang menggunakan model Jev untuk keputusan AI terstruktur, menawarkan output Choice, Score, dan Noul. Ini memungkinkan pengguna untuk menguji teks atau…JevModel adalah platform yang menggunakan model Jev untuk keputusan AI terstruktur, menawarkan output Choice, Score, dan Noul. Ini memungkinkan pengguna untuk menguji teks atau…

Platform Machine Learning
Lihat Top 250 Aplikasi AI

Morph

Aplikasi AI

Platform inferensi yang dibangun untuk agen pengkodean, menawarkan model frontier cepat serta model khusus untuk pencarian kode, menerapkan perubahan, kompak konteks, dan…

MLOps & Penerapan Model
Lihat Alat

Aplikasi AI

Platform inferensi yang dibangun untuk agen pengkodean, menawarkan model frontier cepat serta model khusus untuk pencarian kode, menerapkan perubahan, kompak konteks, dan…

MLOps & Penerapan Model
Lihat Top 250 Aplikasi AI

vLLM

Repositori GitHub AI

vllm-project/vllm adalah mesin inferensi dan penyajian yang berkecepatan tinggi dan efisien dalam penggunaan memori, dirancang untuk model bahasa besar (LLM). Ini mengoptimalkan…

MLOps & Penerapan Model

Peringkat 23 di Repositori GitHub AI

Lihat Alat

Repositori GitHub AI

Mesin inferensi dan penyajian yang berkecepatan tinggi dan efisien dalam penggunaan memori, dirancang untuk model bahasa besar (LLM). Ini mengoptimalkan…vllm-project/vllm adalah mesin inferensi dan penyajian yang berkecepatan tinggi dan efisien dalam penggunaan memori, dirancang untuk model bahasa besar (LLM). Ini mengoptimalkan…

UnggulanMLOps & Penerapan Model
Peringkat 23 di Repositori GitHub AI

trnrt

Repositori GitHub AI

trnrt adalah mesin inferensi LLM sumber terbuka yang dirancang untuk AWS Trainium, menawarkan megakernel NKI dan mendukung konteks 1M-token. Dikembangkan oleh RunAnywhere, ini…

MLOps & Penerapan Model

Peringkat 160 di MLOps & Penerapan Model

Lihat Alat

Repositori GitHub AI

Mesin inferensi LLM sumber terbuka yang dirancang untuk AWS Trainium, menawarkan megakernel NKI dan mendukung konteks 1M-token. Dikembangkan oleh RunAnywhere, ini…trnrt adalah mesin inferensi LLM sumber terbuka yang dirancang untuk AWS Trainium, menawarkan megakernel NKI dan mendukung konteks 1M-token. Dikembangkan oleh RunAnywhere, ini…

MLOps & Penerapan Model
Peringkat 160 di MLOps & Penerapan Model
1 dari 8