Description
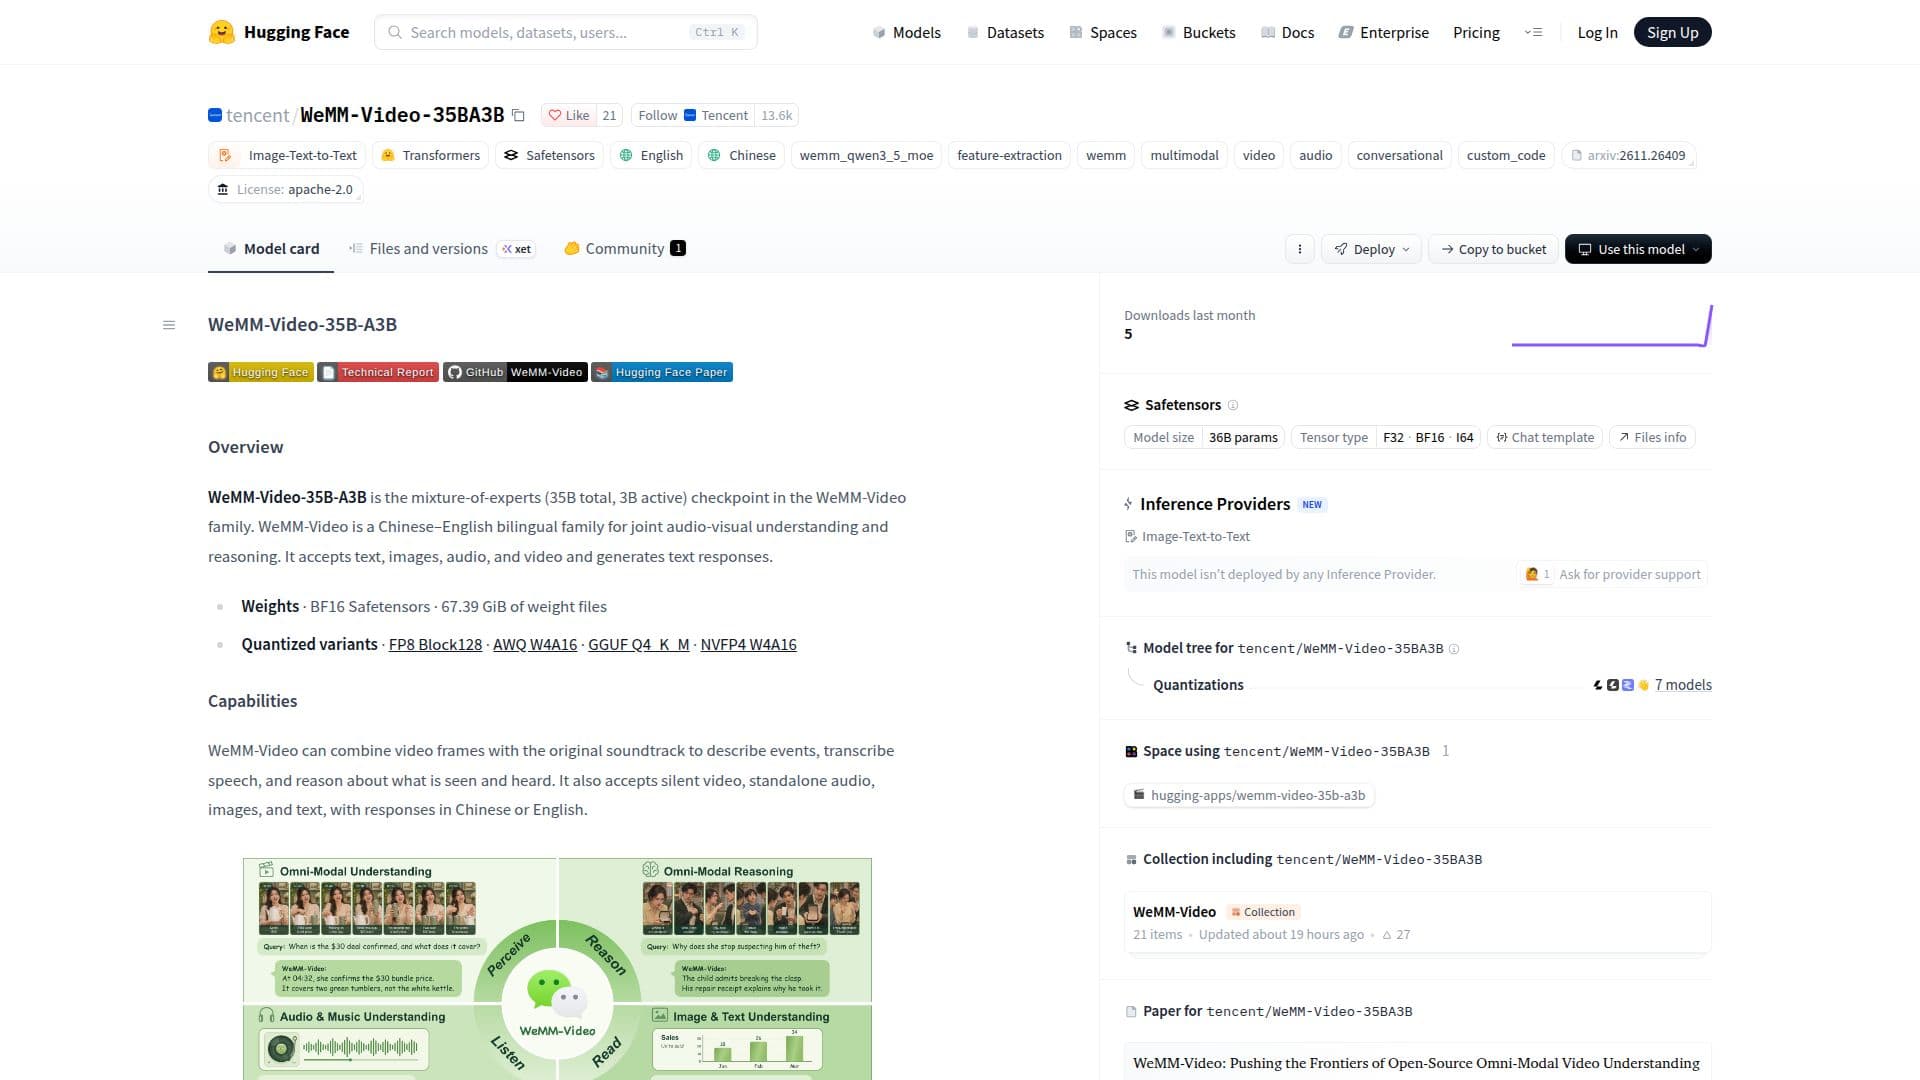
WeMM-Video-35B-A3B est un modèle sophistiqué de mélange d'experts, faisant partie de la famille plus large WeMM-Video, développé pour une compréhension et un raisonnement audio-visuels complets. Avec 35 milliards de paramètres au total et 3 milliards de paramètres actifs, ce modèle est spécifiquement conçu pour traiter et interpréter des entrées multimodales, y compris du texte, des images, de l'audio et de la vidéo, générant des réponses textuelles cohérentes en chinois ou en anglais.
Lire la suite
Les capacités fondamentales du modèle incluent la capacité de combiner des images vidéo avec leurs bandes son originales pour décrire des événements, de transcrire avec précision des discours et d'effectuer des tâches de raisonnement basées sur des informations visuelles et auditives. Il est également suffisamment polyvalent pour traiter des vidéos silencieuses, de l'audio autonome, des images et des entrées textuelles de manière indépendante. Cela le rend adapté à un large éventail d'applications nécessitant une compréhension contextuelle approfondie à travers différents types de médias.
Architecturalement, WeMM-Video-35B-A3B utilise des encodeurs visuels et audio pour convertir les entrées multimédias en jetons, qui sont ensuite traités par un modèle de langage aux côtés du texte. Les images vidéo sont enrichies de timestamps pour maintenir le contexte temporel. La famille de modèles a subi un pré-entraînement approfondi sur environ 1,2 trillion de jetons multimodaux, suivi de techniques de post-entraînement avancées telles que l'OPD multi-enseignants, le MrDPO anti-répétition et l'apprentissage par renforcement spécialisé pour améliorer ses performances et sa robustesse.
Le déploiement et l'intégration sont facilités par diverses options de service. Les utilisateurs peuvent configurer l'environnement Transformers et exécuter des exemples directement à partir du dépôt WeMM-Video. Le modèle prend en charge des variantes quantifiées telles que FP8 Block128, AWQ W4A16, GGUF Q4_K_M et NVFP4 W4A16. Pour le service, il est compatible avec des versions patchées de vLLM (0.18.0 et 0.31.0) et SGLang (0.5.16 ou 0.5.19), permettant une inférence efficace, y compris le parallélisme tensoriel sur plusieurs GPU. Le modèle propose également différents modes de chat, y compris un mode d'instruction par défaut et un « mode de réflexion » pour des réponses de raisonnement.
WeMM-Video-35B-A3B a démontré de solides performances, établissant un nouvel état de l'art open-source. Il a montré qu'il surpasse des modèles propriétaires tels que Qwen3.5-Omni-Flash et Seed2.0-Mini-0428, réduisant considérablement l'écart de performance avec des modèles avancés tels que Gemini-3.0-Flash. Le modèle est publié sous la licence Apache 2.0, promouvant l'accès ouvert et la collaboration au sein de la communauté IA.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de WeMM-Video-35B-A3B
Traitement bilingue chinois-anglais
Compréhension et raisonnement audio-visuels conjoints
Accepte des entrées de texte, d'images, d'audio et de vidéo
Génère des réponses textuelles
Décrit des événements à partir d'images vidéo et de bandes son
Transcrit des discours à partir de l'audio
Raisonne sur des informations visuelles et auditives
Prend en charge le traitement de vidéos silencieuses et d'audio autonome
Architecture de mélange d'experts (35B au total, 3B de paramètres actifs)
Pré-entraîné sur 1,2 trillion de jetons multimodaux
Post-entraîné avec OPD multi-enseignants et MrDPO
Apprentissage par renforcement spécialisé pour des performances améliorées
Prend en charge diverses variantes quantifiées (FP8, AWQ, GGUF, NVFP4)
Compatible avec vLLM et SGLang patchés pour le service
Propose des modes de chat Instruct et Thinking
Premiers pas avec WeMM-Video-35B-A3B
Configurer l'environnement : Installez l'environnement Transformers et les dépendances nécessaires.
Charger le modèle : Chargez le modèle WeMM-Video-35B-A3B et le processeur depuis Hugging Face Hub.
Préparer les entrées : Fournissez des entrées multimédias telles que des fichiers vidéo MP4, de l'audio autonome, des images ou du texte.
Traiter les médias : Utilisez le script pour traiter les images vidéo seules ou avec la bande sonore originale.
Générer des réponses : Envoyez des requêtes au modèle, en spécifiant le mode de chat (Instruct ou Thinking) pour la génération de texte.
Servir le modèle (optionnel) : Installez le patch d'exécution WeMM et utilisez vLLM ou SGLang patchés pour le service API.
Envoyer des requêtes API : Utilisez le client de requêtes inclus pour envoyer des médias en ligne vers le point de terminaison de chat compatible OpenAI.
Cas d'utilisation de WeMM-Video-35B-A3B
- Analyse de contenu vidéo
- Transcription de discours
- Raisonnement multimodal
- Traitement de contenu bilingue
- Description d'événements audio-visuels
- Développement de modèles IA
- Recherche et expérimentation