Description
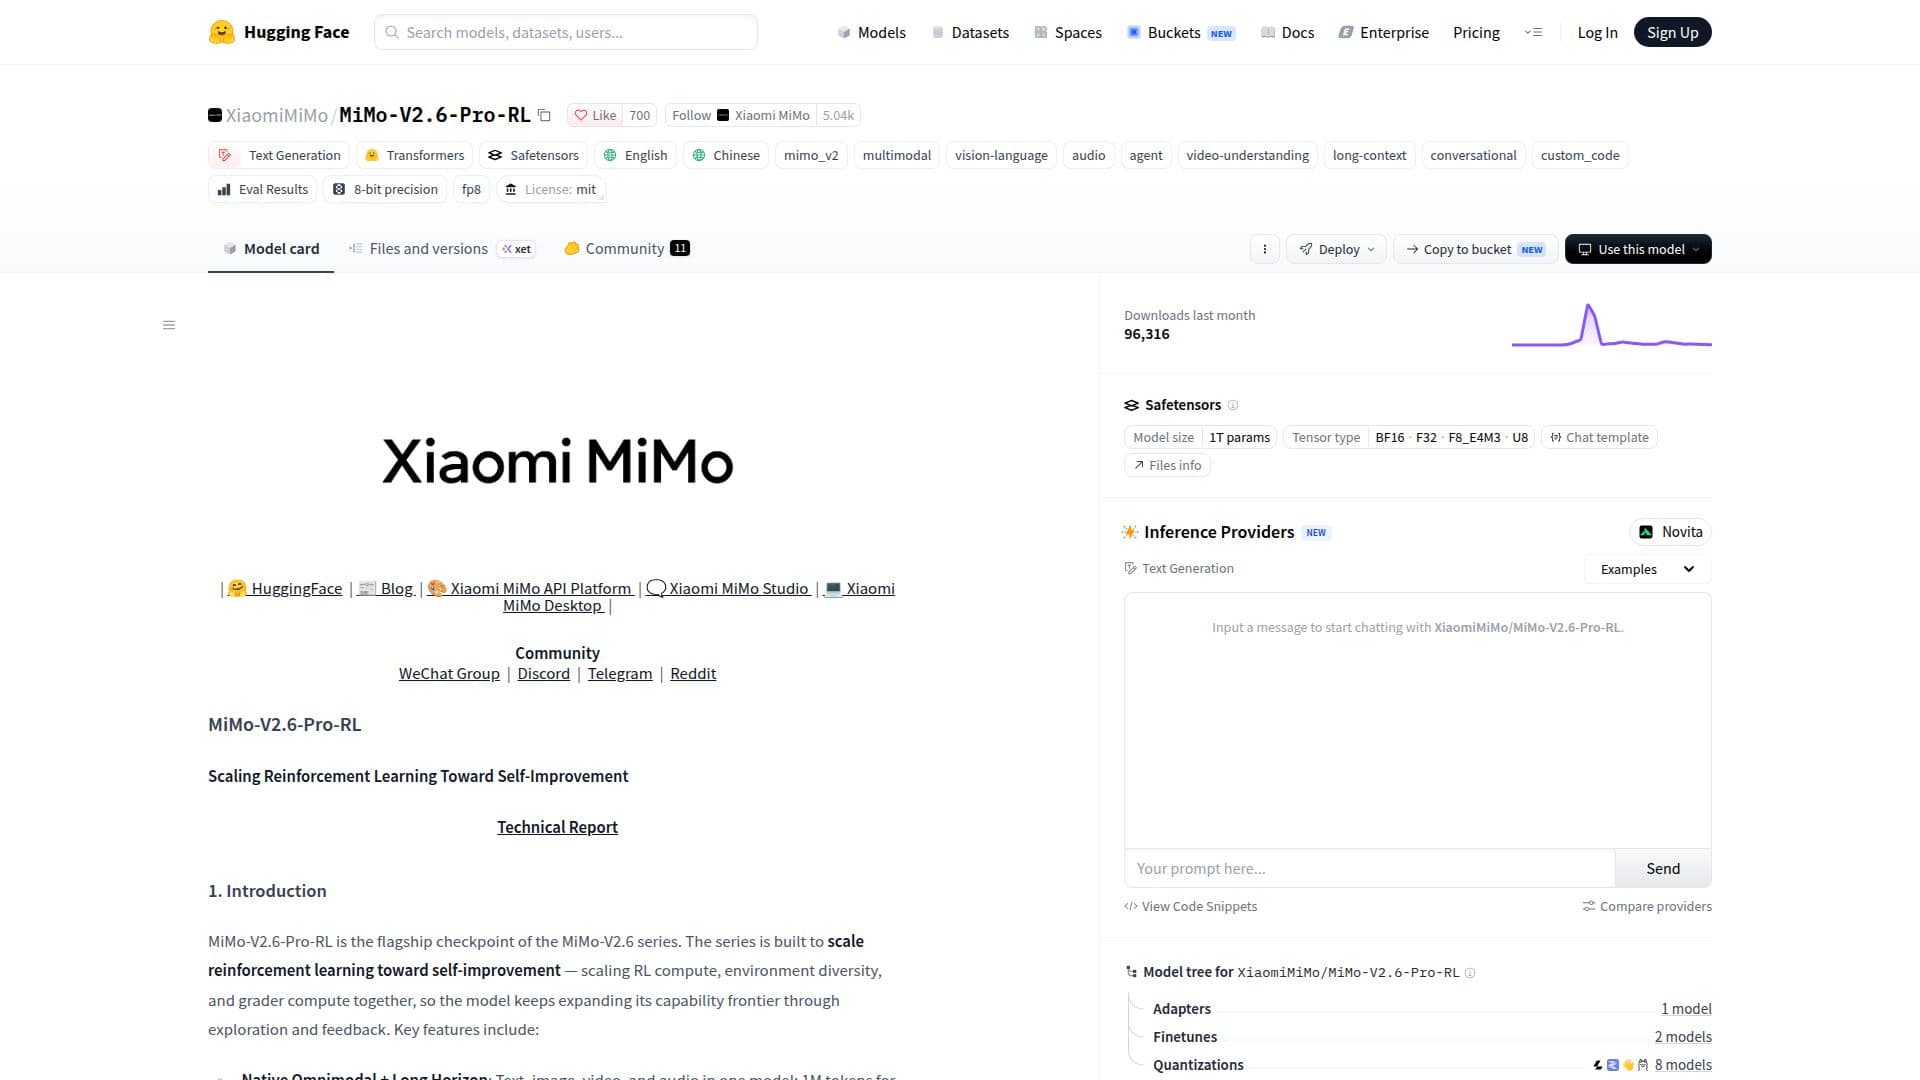
MiMo-V2.6-Pro-RL est le modèle leader de la série MiMo, développé pour faire progresser l'apprentissage par renforcement vers l'auto-amélioration. Ce modèle est conçu pour faire évoluer le calcul RL, la diversité des environnements et le calcul des évaluateurs ensemble, lui permettant d'élargir ses capacités grâce à l'exploration et aux retours d'information.
Lire la suite
Les caractéristiques clés incluent une approche omnimodale native, intégrant le texte, l'image, la vidéo et l'audio en un seul modèle, ainsi qu'une longueur de contexte de 1 million de tokens pour gérer des dépôts étendus et des exécutions d'agents multi-sessions.
Le modèle utilise une stratégie unique 'You Only RL Once', mélangeant des tâches et des ressources dans un seul lot pour renforcer les capacités et transférer des stratégies à travers les domaines. Il utilise une optimisation de politique relative de groupe (GRPO) entièrement asynchrone sur de grands lots, traitant des milliards de tokens par mise à jour. Le système de notation agentique de groupe améliore la boucle d'auto-amélioration en classant les solutions et en orientant vers des chemins efficaces.
MiMo-V2.6-Pro-RL propose également une distillation multi-préfixe multi-enseignant (MOPD2), qui combine des déploiements d'étudiants autonomes avec des déploiements conditionnés par préfixe, étendant les capacités à des tâches complexes. L'architecture du modèle comprend un mélange clairsemé d'experts avec 1,02 trillion de paramètres au total et un encodeur visuel avec 681 millions de paramètres.
Ce modèle est disponible pour déploiement via diverses plateformes, y compris AI Studio, MiMo Code et Xiaomi MiMo Desktop. Il prend en charge le déploiement Docker pour des performances optimales et est accessible via l'API de la plateforme ouverte Xiaomi MiMo et OpenRouter.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de MiMo-V2.6-Pro-RL
Intégration Omnimodale Native
Longueur de Contexte de 1M Tokens
Stratégie You Only RL Once
Optimisation de Politique Relative de Groupe
Notation Agentique de Groupe
Distillation Multi-Préfixe Multi-Enseignant
Architecture de Mélange Clairsemé d'Experts
Disponible sur Plusieurs Plateformes
Premiers pas avec MiMo-V2.6-Pro-RL
Accéder à la page du modèle : Visitez la page officielle de Hugging Face pour MiMo-V2.6-Pro-RL.
Authentifiez-vous : Assurez-vous d'avoir les identifiants nécessaires pour accéder au modèle.
Configurez : Configurez les paramètres du modèle selon vos besoins.
Envoyez des invites : Saisissez vos données pour interagir avec le modèle et recevoir des sorties.
Cas d'utilisation de MiMo-V2.6-Pro-RL
- Traitement Multimodal
- Apprentissage par Renforcement
- Gestion de Données à Grande Échelle
- Transfert de Stratégies Inter-Domaines
- Systèmes de Notation Avancés