Description
Mage-VL-Cowork est un agent hybride multimodal sophistiqué de 4 milliards de paramètres développé par l'équipe Mage de Microsoft. Il est conçu pour combler le fossé entre les agents d'utilisation informatique basés sur des pixels (CUAs) et ceux ayant un accès naïf à la fois aux outils GUI et terminal. Le modèle atteint une compétence hybride en combinant l'interaction GUI basée sur des captures d'écran (`computer_use`) et l'exécution de code/terminal persistante (`bash`) au sein d'une seule politique de vision-langage, éliminant ainsi le besoin d'un orchestrateur externe.
Lire la suite
L'entraînement du modèle implique un curriculum progressif en cinq étapes, commençant par un point de contrôle intermédiaire de 4 milliards de paramètres Mage-VL. Ce curriculum construit une solide base de visualisation autonome, d'exécution GUI et de compétence en codage/terminal avant de les unifier par le biais de Hybrid SFT et de l'apprentissage par renforcement hybride en ligne asynchrone. Un aspect clé de son développement est l'évolution du harnais d'enseignant, qui émonde les routes d'action redondantes et équipe les bibliothèques de domaine, entraînant des gains significatifs en distillation des étudiants.
Mage-VL-Cowork tire également parti de Mage-CUA-Forge, un moteur de synthèse axé sur le flux de travail qui génère un grand nombre de tâches à travers des compétences atomiques tout en réduisant considérablement les coûts de génération récurrents par tâche. Cette approche réduit la consommation de jetons et les dépenses par rapport aux méthodes de construction standard axées sur les agents.
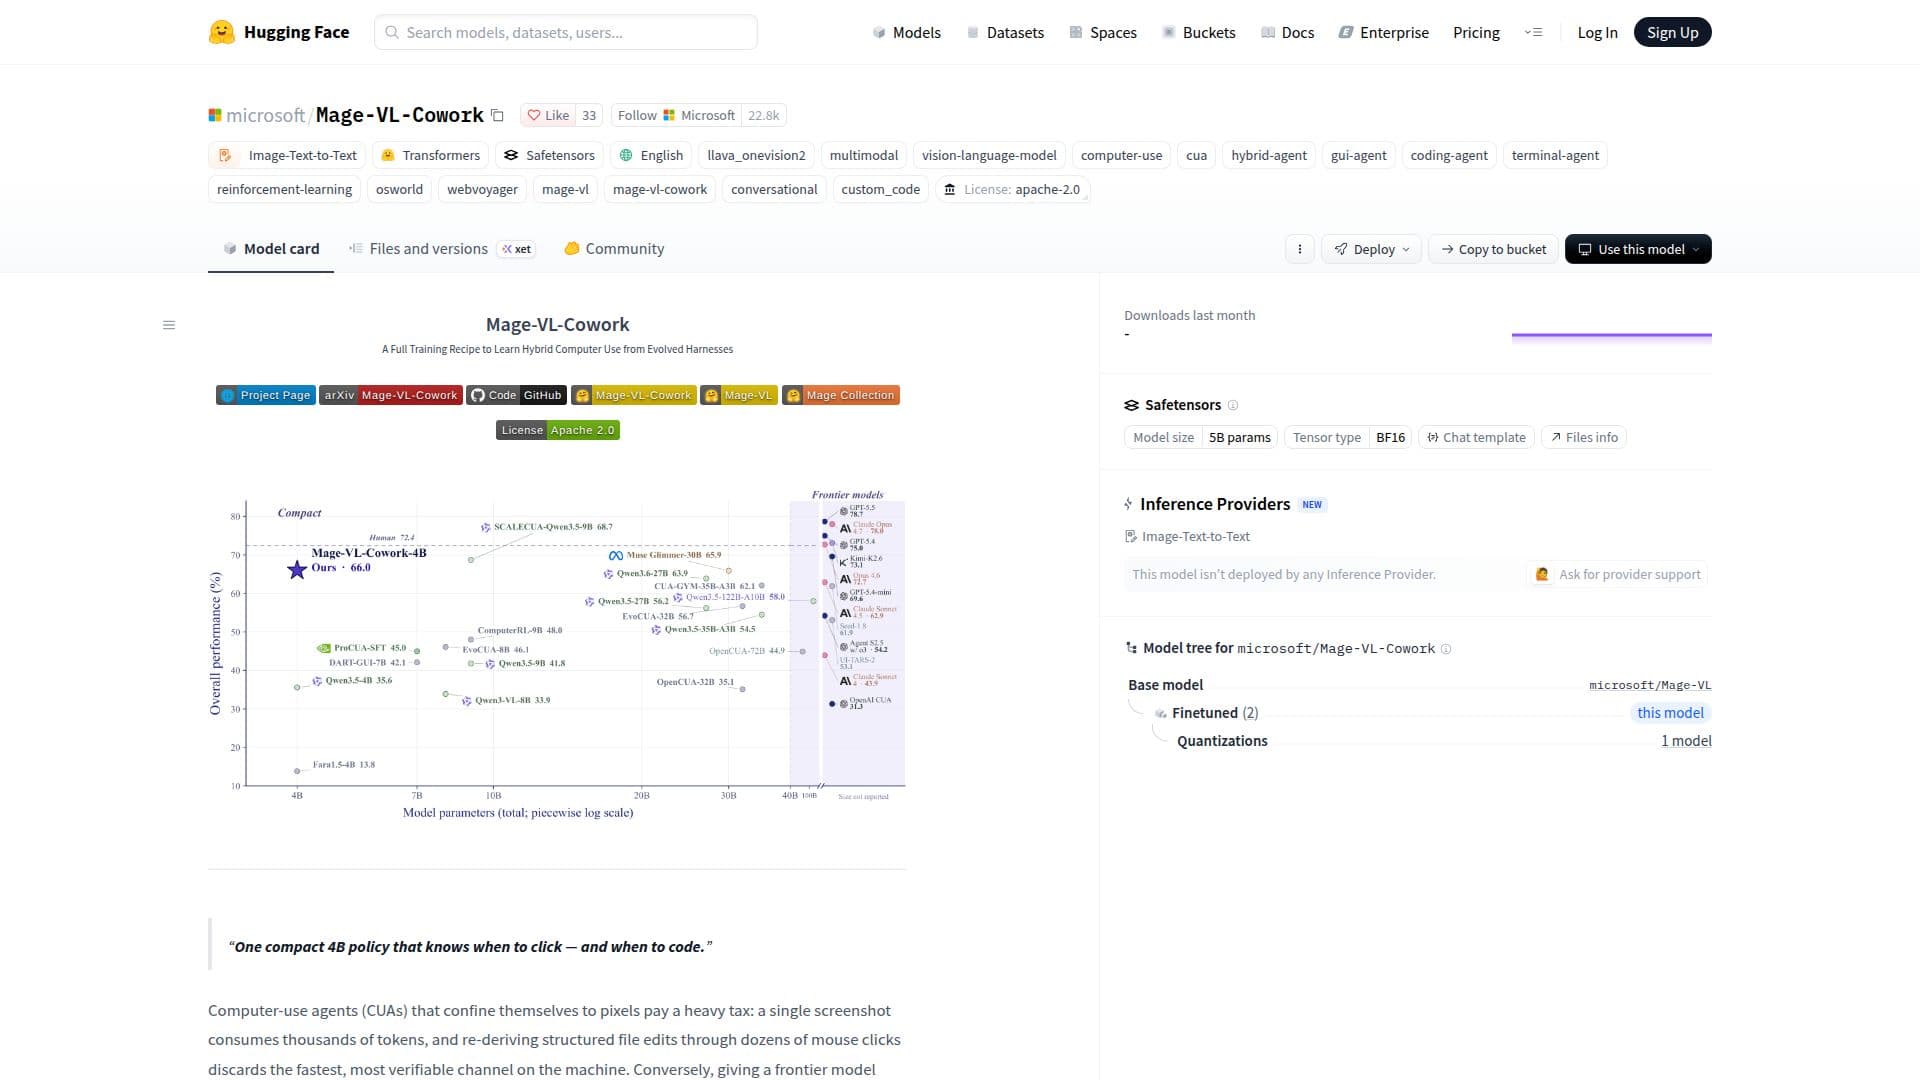
Avec 4 milliards de paramètres, Mage-VL-Cowork atteint 66,0 % sur OSWorld-Verified sous un budget de 50 étapes, marquant la meilleure performance parmi les modèles de sa taille. Il démontre une forte exécution sur les tâches de système d'exploitation (87,5 %) et les flux de travail multi-applications (62,7 %). L'efficacité du modèle est encore améliorée par l'apprentissage par renforcement en ligne, qui ajoute des améliorations significatives de précision tout en réduisant simultanément les appels moyens au modèle et les jetons de sortie. Sa mémoire de travail asymétrique lui permet de gérer des tâches de bureau à long terme en compressant les tours précédents et en conservant les données visuelles et de réponse récentes.
Mage-VL-Cowork est publié sous la licence Apache-2.0 et est destiné à être déployé dans des environnements de bac à sable isolés et jetables en raison de ses capacités autonomes. Il prend en charge une architecture multimodale personnalisée et nécessite des configurations spécifiques pour l'inférence, y compris un contrat unifié à deux canaux pour les interactions GUI et terminal.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesWeb
Points forts de Mage-VL-Cowork
Utilisation hybride de l'ordinateur : Combine l'interaction GUI et l'exécution terminale au sein d'une seule politique.
4 milliards de paramètres : Atteint des performances de premier ordre à l'échelle de 4 milliards.
Architecture multimodale : Modèle Image-Texte-à-Texte basé sur l'architecture llava_onevision2.
Curriculum de formation en cinq étapes : Approche progressive de spécialisation puis d'unification pour un développement complet des compétences.
Harnais d'enseignant évolués : Amplifie la distillation des étudiants et améliore l'efficacité.
Synthèse d'environnement axée sur le flux de travail (Mage-CUA-Forge) : Réduit le coût de génération des tâches et la consommation de jetons.
Routage de canal au niveau des tours internalisé : Sélectionne dynamiquement entre GUI et bash pour une exécution optimale.
Performance élevée vérifiée par OSWorld : Atteint 66,0 % sur les tâches vérifiées par OSWorld.
Exécution solide des tâches OS et des flux de travail multi-applications : 87,5 % sur les tâches OS, 62,7 % sur les flux de travail multi-applications.
Apprentissage par renforcement en ligne : Améliore la précision de +10,16 pp et réduit les appels au modèle/jetons de sortie.
Mémoire de travail asymétrique : Gère les tâches à long terme avec une mémoire compressée et une fenêtre visuelle active.
Point de contrôle unifié : Gère la visualisation, la manipulation GUI, les opérations programmatiques et le changement de canal.
Licence Apache-2.0 : Licence open-source pour l'utilisation et la distribution.
Architecture multimodale personnalisée : Utilise llava_onevision2 avec Qwen2_5_VLProcessor.
Premiers pas avec Mage-VL-Cowork
Installer les dépendances : Configurez l'environnement requis, y compris SGLang, PyTorch et Transformers.
Servir avec SGLang : Lancez le serveur d'inférence GPU en utilisant le conteneur Docker fourni ou un environnement personnalisé.
Configurer les requêtes multimodales : Rendre les invites avec AutoProcessor.apply_chat_template et envoyer des charges utiles d'image base64 à l'endpoint /generate de SGLang.
Appliquer les paramètres d'échantillonnage : Utilisez les paramètres recommandés comme température 0,7, top_p 0,8 et max_new_tokens 4096.
Mettre en œuvre le système de prompt et le schéma d'outils : Utilisez le contrat unifié à deux canaux exact pour computer_use et bash.
Effectuer une inférence Transformers hors ligne : Utilisez le modèle pour l'inférence avec les exemples fournis.
Reproduire l'évaluation vérifiée par OSWorld : Lancez l'exécution de SGLang et exécutez le harnais d'évaluation vérifié par OSWorld.
Déployer en toute sécurité : Exécutez toujours l'agent dans un environnement de bac à sable isolé avec une autorisation limitée et aucune exposition de crédentiels.
Cas d'utilisation de Mage-VL-Cowork
- Automatisation de bureau autonome
- Interaction GUI
- Édition de fichiers programmatiques
- Opérations système
- Interaction avec l'environnement web
- Tâches d'ingénierie logicielle
- Intelligence sur appareil
- Recherche et développement