Description
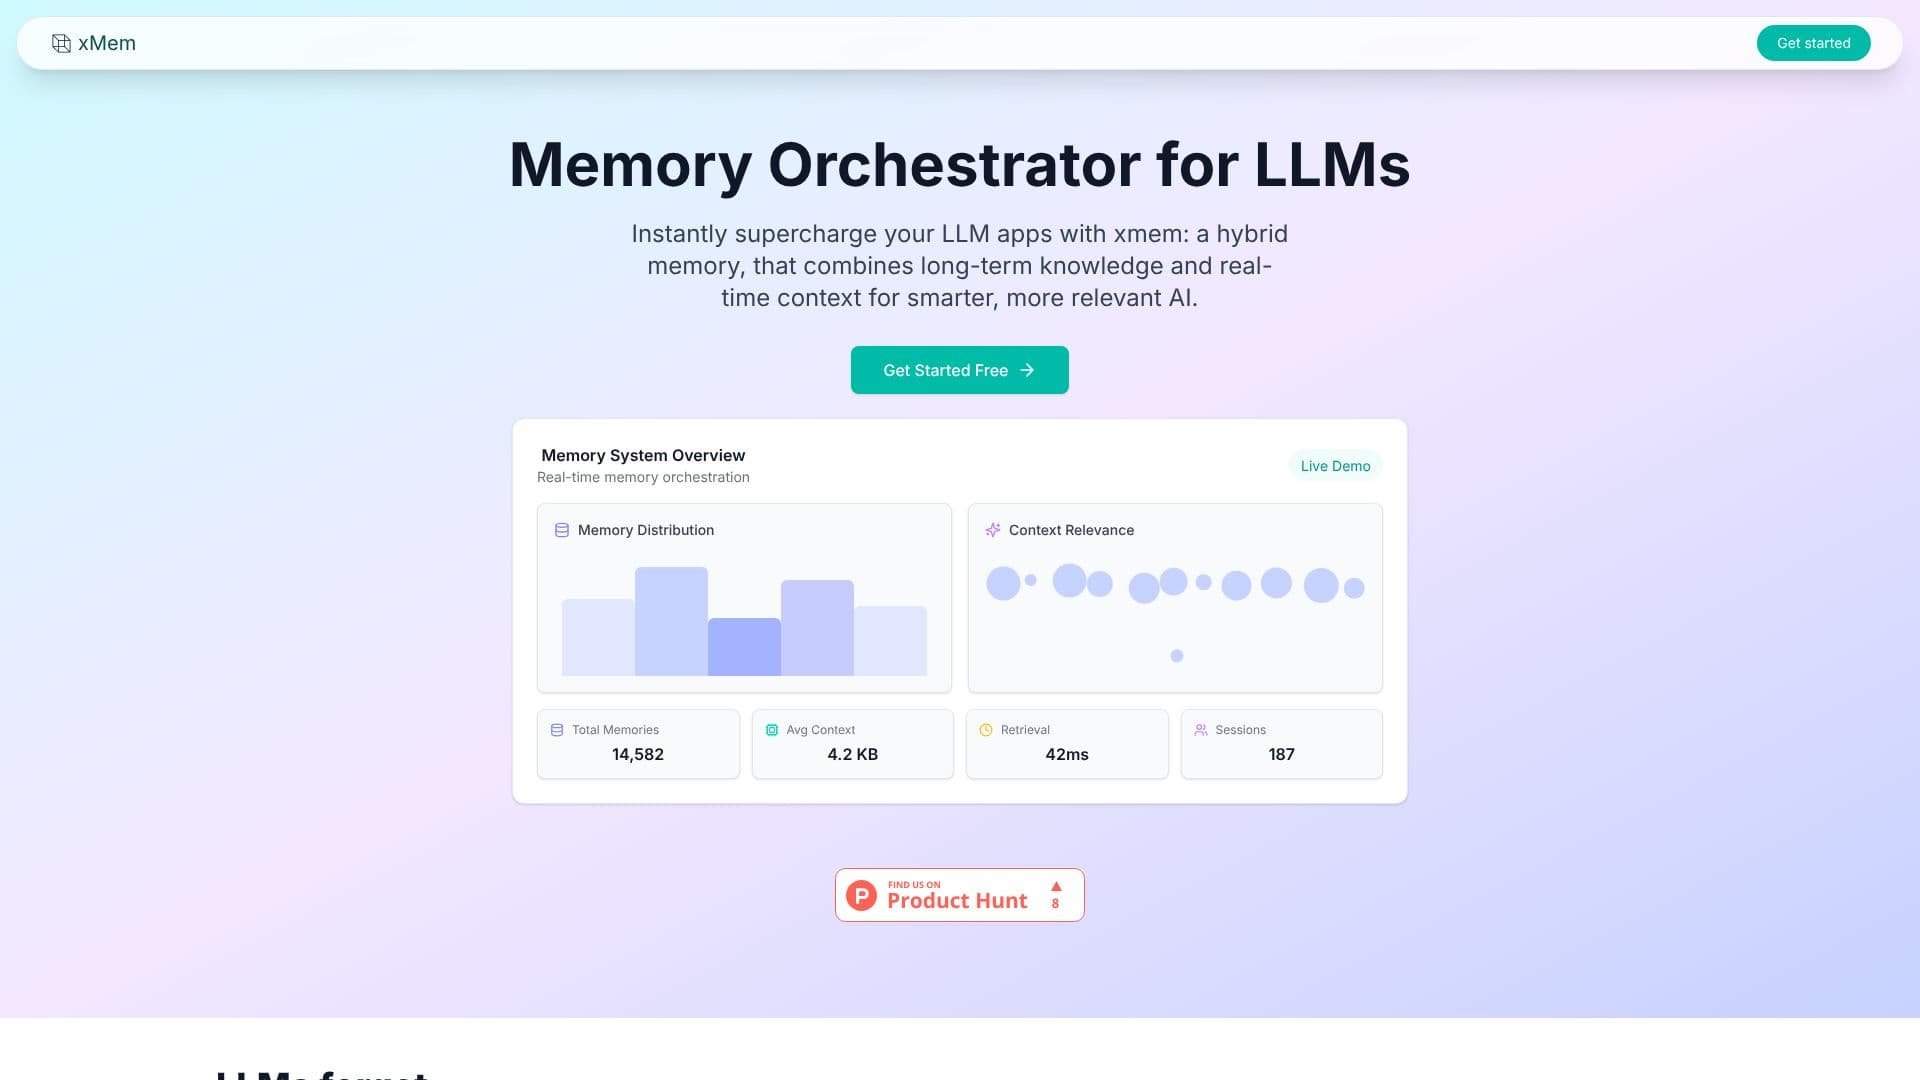
Les LLM ont souvent des difficultés avec la mémoire, ce qui entraîne une perte de contexte et des expériences utilisateur répétitives. xMem relève ce défi en fournissant un système de mémoire hybride qui orchestre à la fois les connaissances à long terme et le contexte de session en temps réel pour chaque interaction LLM. Cela garantit que vos applications d'IA restent pertinentes, précises et à jour, même sur plusieurs sessions.
Lire la suite
Le système de xMem est conçu pour prévenir les écueils courants de la perte de mémoire des LLM. Il combine un magasin de mémoire persistant pour les connaissances à long terme, les documents et les notes, accessible via la recherche vectorielle, avec un composant de mémoire de session qui suit les conversations récentes, les instructions et le contexte pour un rappel immédiat. Cette double approche permet aux LLM d'accéder à une compréhension complète des interactions passées et des informations stockées.
Le cœur de la fonctionnalité de xMem réside dans son orchestration RAG (Retrieval-Augmented Generation). Il assemble automatiquement le contexte le plus pertinent pour chaque appel LLM, éliminant ainsi le besoin de réglages manuels. Le flux de données implique que les invites utilisateur soient traitées via des magasins de session et des bases de données vectorielles (telles que Qdrant, ChromaDB, Pinecone), avant d'être transmises aux fournisseurs LLM (tels que Llama.cpp, Ollama, OpenAI) avec le contexte assemblé de manière optimale.
De plus, xMem dispose d'un graphe de connaissances dynamique et évolutif qui relie les concepts, les faits et le contexte utilisateur en temps réel. Ce graphe permet aux LLM de raisonner, de se souvenir et de connecter des informations, un peu comme un cerveau humain, conduisant à des réponses plus intelligentes et plus pertinentes. Cette capacité est particulièrement bénéfique pour des applications telles que RAG, les agents et les copilotes.
xMem est construit selon une philosophie open-source, garantissant la compatibilité avec un large éventail de LLM open-source et de bases de données vectorielles. Son intégration sans effort est facilitée par une API facile à utiliser et un tableau de bord de surveillance. Le système offre une gestion intelligente de la mémoire, une recherche et une récupération sémantiques via l'intégration de bases de données vectorielles, et un assemblage de contexte en temps réel pour le traitement de tailles de contexte allant jusqu'à 8,2 Ko avec une faible latence.
- CatégorieBases de données vectorielles et récupération
- Modèle tarifaireNiveau gratuit
- DéploiementAuto-hébergé / Cloud
- PlateformesWeb
Fonctionnalités principales de xMem
Système de mémoire hybride combinant contexte à long terme et de session
Mémoire persistante pour les connaissances et le contexte utilisateur
Mémoire de session pour le suivi des interactions récentes
Orchestration RAG pour l'assemblage automatique du contexte
Graphe de connaissances en temps réel pour la liaison des concepts
Recherche vectorielle pour la récupération des connaissances
Prise en charge des LLM open-source (Llama, Mistral, etc.)
Intégration avec diverses bases de données vectorielles (Qdrant, ChromaDB, Pinecone)
API facile pour une intégration transparente
Tableau de bord de surveillance pour la supervision
Gestion intelligente de la mémoire
Capacités de recherche et de récupération sémantiques
Structure de connaissances dynamique et évolutive
Comment utiliser xMem ?
Configurer : Configurez votre magasin vectoriel, votre magasin de session et votre fournisseur LLM.
Intégrer : Utilisez l'API xMem pour connecter votre application LLM.
Interroger : Envoyez des invites à l'orchestrateur pour des réponses contextuellement pertinentes.
Surveiller : Utilisez le tableau de bord pour suivre l'utilisation de la mémoire et les performances.
Optimiser : Affinez l'assemblage du contexte et le graphe de connaissances pour améliorer la précision de l'IA.
Cas d'utilisation de xMem
- Chatbots Contextuels
- Assistants Personnalisés
- Systèmes RAG
- Agents IA
- Copilotes
- Gestion des Connaissances
- IA de Support Client