Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

Throttle

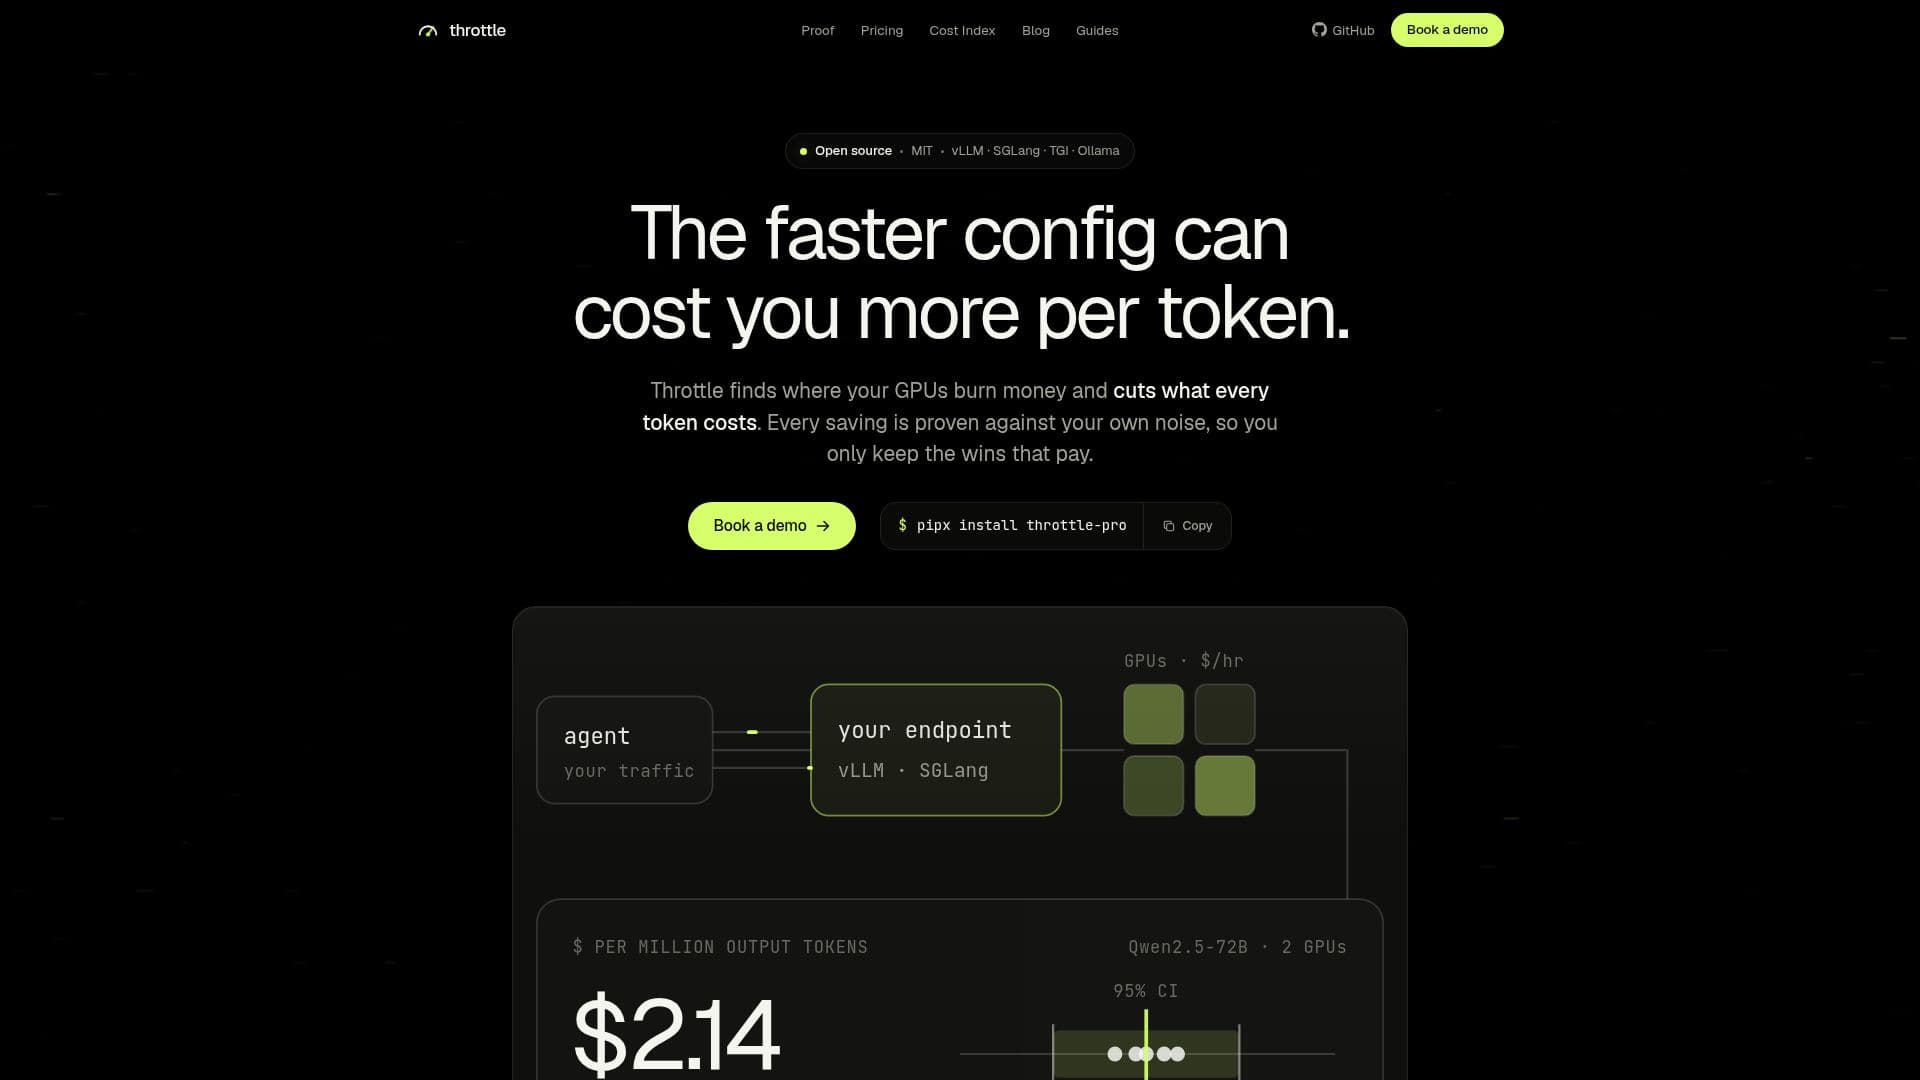
Throttle optimise les coûts d'inférence AI sur les GPU en identifiant les configurations de service inefficaces. Il offre des économies en dollars par million de tokens, garantissant des opérations AI rentables. Compatible avec divers serveurs AI, il propose une interface en ligne de commande open-source et un pilote gratuit de 2 mois.

Visiter l'URL
Partager
Capture d’écran de Throttle

Throttle est un outil conçu pour réduire les coûts associés à l'inférence AI sur les GPU, qu'ils soient possédés ou loués. Il y parvient en identifiant les configurations de service inefficaces et en prouvant les économies en termes de dollars par million de tokens. Cela garantit que les utilisateurs ne conservent que les configurations qui offrent de réels avantages en termes de coûts. Throttle est compatible avec une large gamme de serveurs AI, y compris vLLM, SGLang, TGI, Ollama, LMDeploy, llama.cpp, TensorRT-LLM et NIM, entre autres.

Lire la suite

L'outil est open-source et disponible sous la licence MIT, permettant aux utilisateurs d'inspecter et de modifier le code selon leurs besoins. Il fonctionne localement, ce qui signifie que toutes les invites, réponses et clés restent dans l'environnement de l'utilisateur, garantissant la confidentialité et la sécurité des données. Throttle fournit une interface en ligne de commande (CLI) gratuite à utiliser, et propose également un pilote gratuit de 2 mois pour les utilisateurs d'entreprise.

Le modèle de tarification de Throttle est flexible, commençant par 10 $ de crédits gratuits pour Throttle Cloud, sans nécessiter de carte de crédit. Le plan Starter est au prix de 30 $ par mois, le plan Pro à 50 $ par mois, et le plan Team à 100 $ par mois, chacun incluant des crédits d'utilisation équivalents. Les plans d'entreprise sont tarifés sur mesure et impliquent un pilote pratique où les utilisateurs ne paient que sur des économies vérifiées.

La fonctionnalité principale de l'outil inclut des vérifications pour déterminer le coût par million de tokens, avec un intervalle de confiance de 95 % pour tenir compte du bruit. Il signale tout changement dans la longueur de sortie ou les limites de tokens, garantissant que seules les économies réelles sont prises en compte. Throttle fournit également une interface utilisateur (UI) pour visualiser les économies et les coûts, qui peut être accessible localement sur la machine de l'utilisateur.

  • CatégorieMLOps et déploiement de modèles
  • Modèle tarifaireFreemium
  • DéploiementLocal
  • PlateformesCompatible OpenAI

  • CLI open-source

  • Optimisation des coûts pour l'inférence AI

  • Compatibilité avec plusieurs serveurs AI

  • Traitement des données local

  • Pilote d'entreprise gratuit de 2 mois

  • Intervalle de confiance de 95 % pour les économies

  • Verdicts calibrés au bruit

  • Throttle Cloud avec crédits d'utilisation

  1. Installer : pipx install throttle-pro

  2. Exécuter : Exécutez throttle check sur votre configuration

  3. Analyser : Examinez les économies de coûts et les configurations

  4. Optimiser : Mettez en œuvre des configurations rentables

  • Réduction des coûts
  • Analyse de configuration
  • Confidentialité des données
  • Économies d'entreprise
  • Développement open source

Avis sur Throttle

Chargement...

Outils IA populaires comme Throttle

Hopscotch

Applications IA

Hopscotch offre un accès à plus de 500 modèles d'IA provenant de fournisseurs tels qu'Anthropic, OpenAI et Google via une API unique. Il permet aux utilisateurs de définir des…

MLOps et déploiement de modèles

N°72 pour Ajustement fin des modèles AI

Voir l'outil

Applications IA

Offre un accès à plus de 500 modèles d'IA provenant de fournisseurs tels qu'Anthropic, OpenAI et Google via une API unique. Il permet aux utilisateurs de définir des…Hopscotch offre un accès à plus de 500 modèles d'IA provenant de fournisseurs tels qu'Anthropic, OpenAI et Google via une API unique. Il permet aux utilisateurs de définir des…

MLOps et déploiement de modèles
N°72 pour Ajustement fin des modèles AI

Calcul Général

Applications IA

Un fournisseur d'inférence AI à haute vitesse qui sert des modèles sur une infrastructure ASIC conçue sur mesure via une API compatible OpenAI, offrant un faible temps jusqu'au…

MLOps et déploiement de modèles
Voir l'outil

Applications IA

Un fournisseur d'inférence AI à haute vitesse qui sert des modèles sur une infrastructure ASIC conçue sur mesure via une API compatible OpenAI, offrant un faible temps jusqu'au…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

ZETIC Melange

Applications IA

ZETIC Melange automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…

MLOps et déploiement de modèles

N°149 en MLOps et déploiement de modèles

Voir l'outil

Applications IA

Automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…ZETIC Melange automatise le déploiement d'IA sur appareil pour tout modèle sur tout appareil. Conçu par d'anciens ingénieurs Qualcomm, il optimise l'accélération NPU, effectue des…

MLOps et déploiement de modèles
N°149 en MLOps et déploiement de modèles

Navige

Applications IA

Navige optimise les coûts des agents IA en dirigeant les appels vers les bons modèles, en bloquant les appels inutiles et en réutilisant le travail déjà effectué. Cela garantit…

MLOps et déploiement de modèles

N°174 en MLOps et déploiement de modèles

Voir l'outil

Applications IA

Optimise les coûts des agents IA en dirigeant les appels vers les bons modèles, en bloquant les appels inutiles et en réutilisant le travail déjà effectué. Cela garantit…Navige optimise les coûts des agents IA en dirigeant les appels vers les bons modèles, en bloquant les appels inutiles et en réutilisant le travail déjà effectué. Cela garantit…

MLOps et déploiement de modèles
N°174 en MLOps et déploiement de modèles

Inference.net

Applications IA

Inference.net fournit une infrastructure pour les équipes natives de l'IA afin d'exécuter, de surveiller et d'optimiser les charges de travail de l'IA. Il offre une inférence…

MLOps et déploiement de modèles

N°78 pour Ajustement fin des modèles AI

Voir l'outil

Applications IA

Fournit une infrastructure pour les équipes natives de l'IA afin d'exécuter, de surveiller et d'optimiser les charges de travail de l'IA. Il offre une inférence…Inference.net fournit une infrastructure pour les équipes natives de l'IA afin d'exécuter, de surveiller et d'optimiser les charges de travail de l'IA. Il offre une inférence…

MLOps et déploiement de modèles
N°78 pour Ajustement fin des modèles AI

GPUX

Applications IA

GPUX offre une inférence GPU serverless pour les modèles d'IA, permettant un déploiement et une exécution rapides des charges de travail d'apprentissage automatique. Il offre des…

MLOps et déploiement de modèles
Voir l'outil

Applications IA

Offre une inférence GPU serverless pour les modèles d'IA, permettant un déploiement et une exécution rapides des charges de travail d'apprentissage automatique. Il offre des…GPUX offre une inférence GPU serverless pour les modèles d'IA, permettant un déploiement et une exécution rapides des charges de travail d'apprentissage automatique. Il offre des…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

Chutes est une plateforme de calcul AI sans serveur qui permet aux utilisateurs de déployer, exécuter et mettre à l'échelle n'importe quel modèle AI en quelques secondes. Avec un…

MLOps et déploiement de modèles
Voir l'outil

Plateforme de calcul AI sans serveur qui permet aux utilisateurs de déployer, exécuter et mettre à l'échelle n'importe quel modèle AI en quelques secondes. Avec un…Chutes est une plateforme de calcul AI sans serveur qui permet aux utilisateurs de déployer, exécuter et mettre à l'échelle n'importe quel modèle AI en quelques secondes. Avec un…

MLOps et déploiement de modèles
Voir le Top 250 Applications IA

GMI Cloud

Applications IA

GMI Cloud offre une infrastructure cloud GPU haute performance pour les charges de travail d'IA. Il prend en charge l'inférence sans serveur, les clusters GPU dédiés et…

MLOps et déploiement de modèles

N°76 en Outils DevOps et cloud IA

Voir l'outil

Applications IA

Offre une infrastructure cloud GPU haute performance pour les charges de travail d'IA. Il prend en charge l'inférence sans serveur, les clusters GPU dédiés et…GMI Cloud offre une infrastructure cloud GPU haute performance pour les charges de travail d'IA. Il prend en charge l'inférence sans serveur, les clusters GPU dédiés et…

MLOps et déploiement de modèles
N°76 en Outils DevOps et cloud IA
1 sur 8