Description
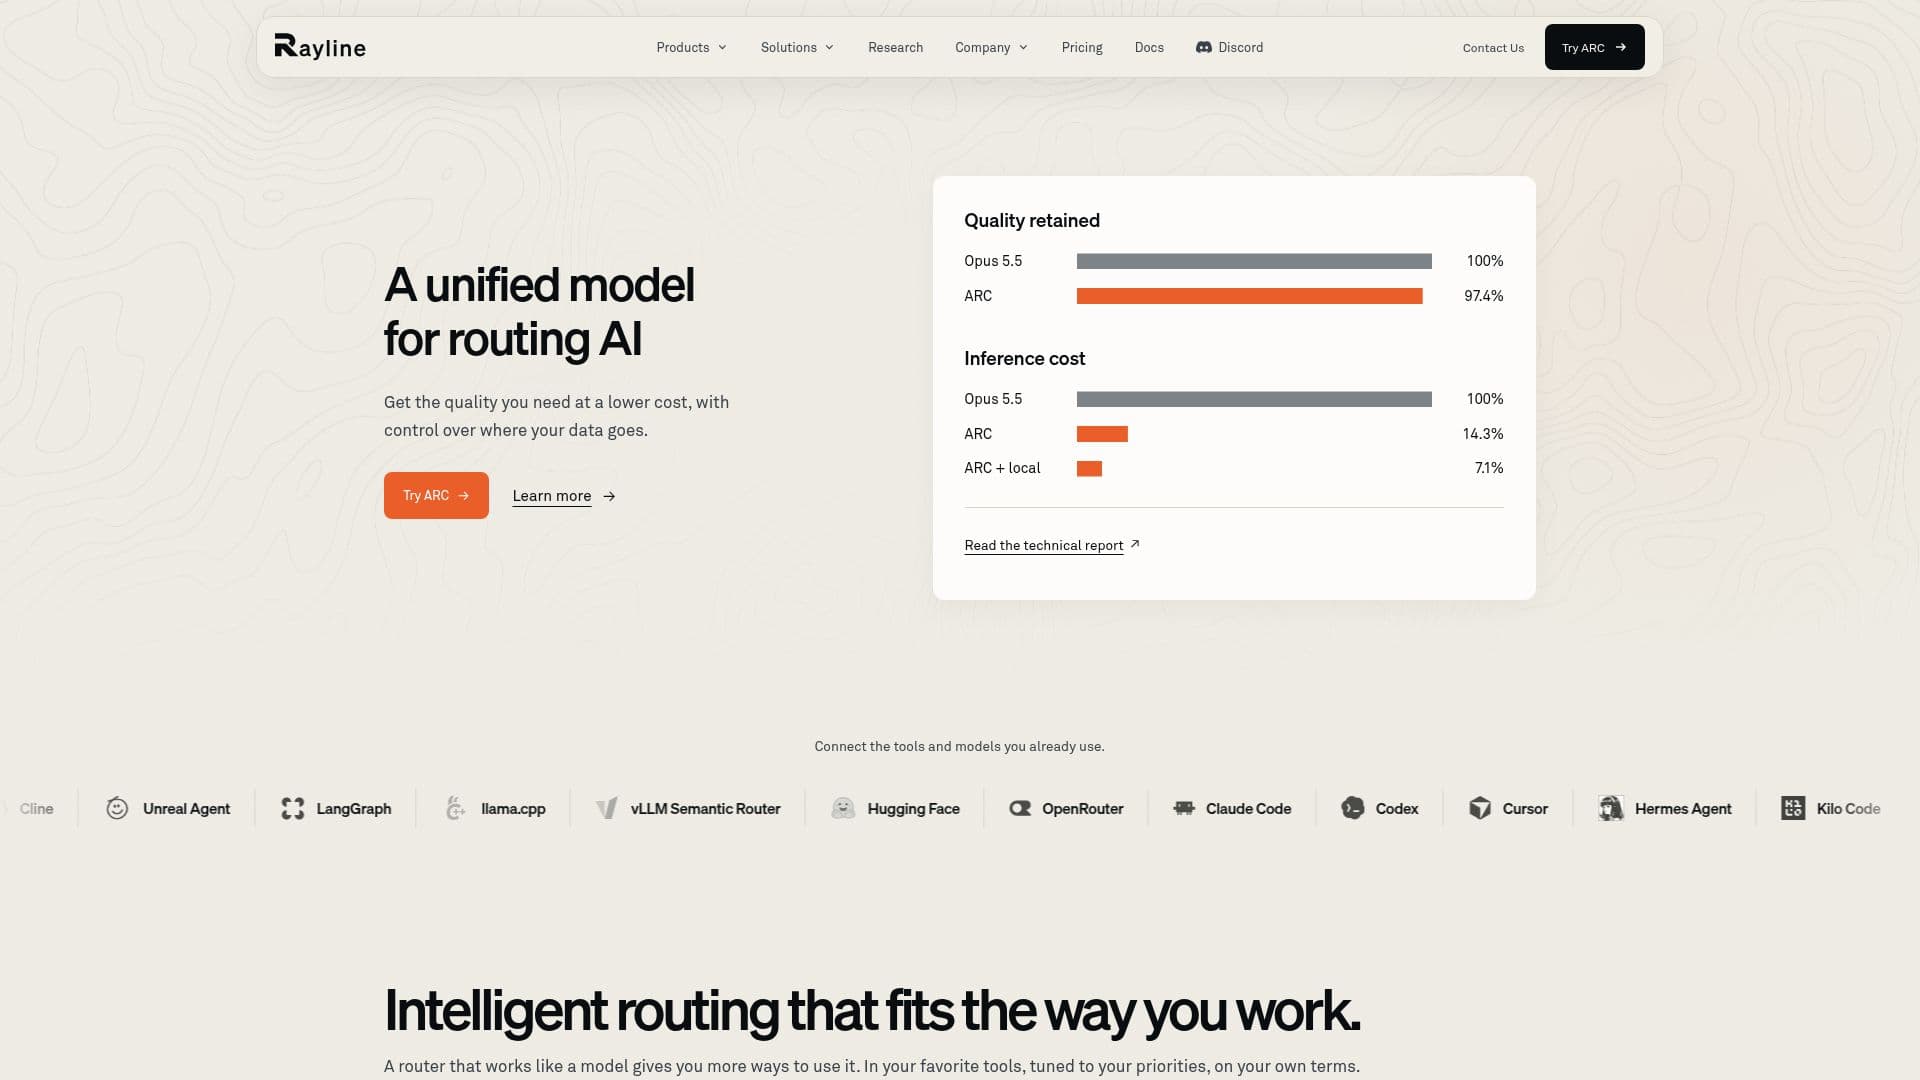
Rayline fournit un modèle unifié pour le routage de l'IA, conçu pour offrir une qualité optimale à un coût réduit tout en garantissant aux utilisateurs le contrôle de leurs données. Au cœur de ce système se trouve ARC, le système de routage adaptatif de Rayline qui choisit intelligemment le modèle d'IA et le niveau de raisonnement les plus adaptés pour chaque tour de conversation, en fonction de facteurs tels que le contexte de la conversation, la qualité souhaitée et le coût.
Lire la suite
La plateforme s'intègre parfaitement à un large éventail d'outils et de modèles existants, y compris llama.cpp, vLLM, Semantic Router, Hugging Face, OpenRouter, Claude, OpenAI, DeepSeek, GLM, Kimi, Qwen, Gemini, Gemma et Mistral. Cette flexibilité permet aux équipes de continuer à travailler dans leurs environnements familiers tout en bénéficiant des capacités de routage intelligentes de Rayline. Les utilisateurs peuvent façonner les décisions d'ARC en fonction de leurs priorités de charge de travail spécifiques et des coûts réels des modèles, y compris les remises négociées.
Rayline offre une flexibilité de déploiement, permettant aux utilisateurs de laisser Rayline exécuter l'inférence ou de prendre la recommandation de modèle vers leur propre passerelle, fournisseur de cloud ou modèles locaux. L'API Decisions fournit des réponses structurées, des choix, des probabilités et des scores à partir de n'importe quelle entrée, formée spécifiquement pour le routage de modèles mais utile pour des applications plus larges. Pour la génération hébergée, les utilisateurs peuvent commencer avec ARC Swift ou Sage, ou utiliser l'API Routes pour une inférence autogérée.
Pour les développeurs, Rayline propose Workshop Cloud et Workshop Desktop, permettant de construire des logiciels prêts pour la production avec des agents adaptatifs. Le CLI Rayline connecte les modèles locaux et les services cloud, les intégrant dans les outils existants. La plateforme offre également des économies de coûts significatives, avec des économies annuelles potentielles allant jusqu'à 108 000 $ en atteignant jusqu'à 90 % de réduction des coûts d'inférence. L'approche de Rayline est soutenue par des recherches approfondies, détaillées dans le rapport technique ARC, qui explique la méthodologie et les résultats de référence derrière son équilibre qualité-coût.
Rayline propose divers modèles de tarification, y compris des présélections à tarif fixe comme ARC Swift pour un travail API quotidien efficace et ARC Sage pour des tâches d'agent axées sur la qualité. ARC Dynamic fournit une sélection de modèles adaptative avec une tarification au passage basée sur le modèle sélectionné, sans commission. L'API Routes permet aux utilisateurs de payer pour la sélection de modèles et le niveau de raisonnement, gérant leurs propres coûts d'inférence. L'API Decisions est tarifée en fonction des tokens d'entrée pour des réponses structurées. Le CLI Rayline est open source sans frais logiciels, avec des frais d'inférence matériel et cloud facturés séparément. Les modèles contributeurs offrent des tarifs de tokens réduits en échange de la possibilité pour Rayline d'utiliser les données de demande éligibles pour l'entraînement de ses modèles.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireFreemium
- DéploiementCloud, Local
- PlateformesWeb
Fonctionnalités principales de Rayline
Routage Unifié des Modèles d'IA (ARC)
Sélection de Modèles Optimisée pour le Coût
Contrôle des Données et Confidentialité
Intégration avec les Outils et Modèles d'IA Existants
Routage Adaptatif basé sur les Priorités
Déploiement Flexible de l'Inférence (Hébergé ou Autogéré)
API Decisions pour des Réponses Structurées
API Routes pour la Sélection de Modèles
Workshop Cloud et Desktop pour le Développement
CLI Rayline pour l'Intégration de Modèles Locaux
Économies Significatives sur les Coûts d'Inférence
Rapport Technique et Soutien à la Recherche
Modèles de Tarification à Taux Fixe et Dynamique
Options de Tarification pour Modèles Contributeurs
Plateforme de Suivi de l'Utilisation et des Dépenses
Comment utiliser Rayline ?
Connecter les Outils : Intégrer les modèles et outils d'IA existants comme Claude, OpenAI et Hugging Face avec Rayline.
Configurer le Routage : Définir vos priorités pour la qualité et le coût afin de façonner les décisions de sélection de modèle d'ARC.
Déployer l'Inférence : Choisir d'exécuter l'inférence via les services hébergés de Rayline (Swift, Sage) ou de la gérer sur votre propre infrastructure en utilisant l'API Routes.
Développer des Applications : Utiliser Workshop Cloud ou Desktop pour construire des logiciels prêts pour la production avec des agents adaptatifs.
Surveiller et Optimiser : Suivre l'utilisation et les dépenses sur la plateforme Rayline et ajuster les politiques de routage pour une amélioration continue.
Cas d'utilisation de Rayline
- Optimisation de la Sélection de Modèles d'IA
- Réduction des Coûts d'Inférence
- Intégration d'Outils d'IA Diversifiés
- Développement d'Agents d'IA Adaptatifs
- Assurer le Contrôle des Données
- Prise de Décision Structurée
- Personnalisation de l'Économie de Routage
- Évaluation des Politiques de Routage