Description
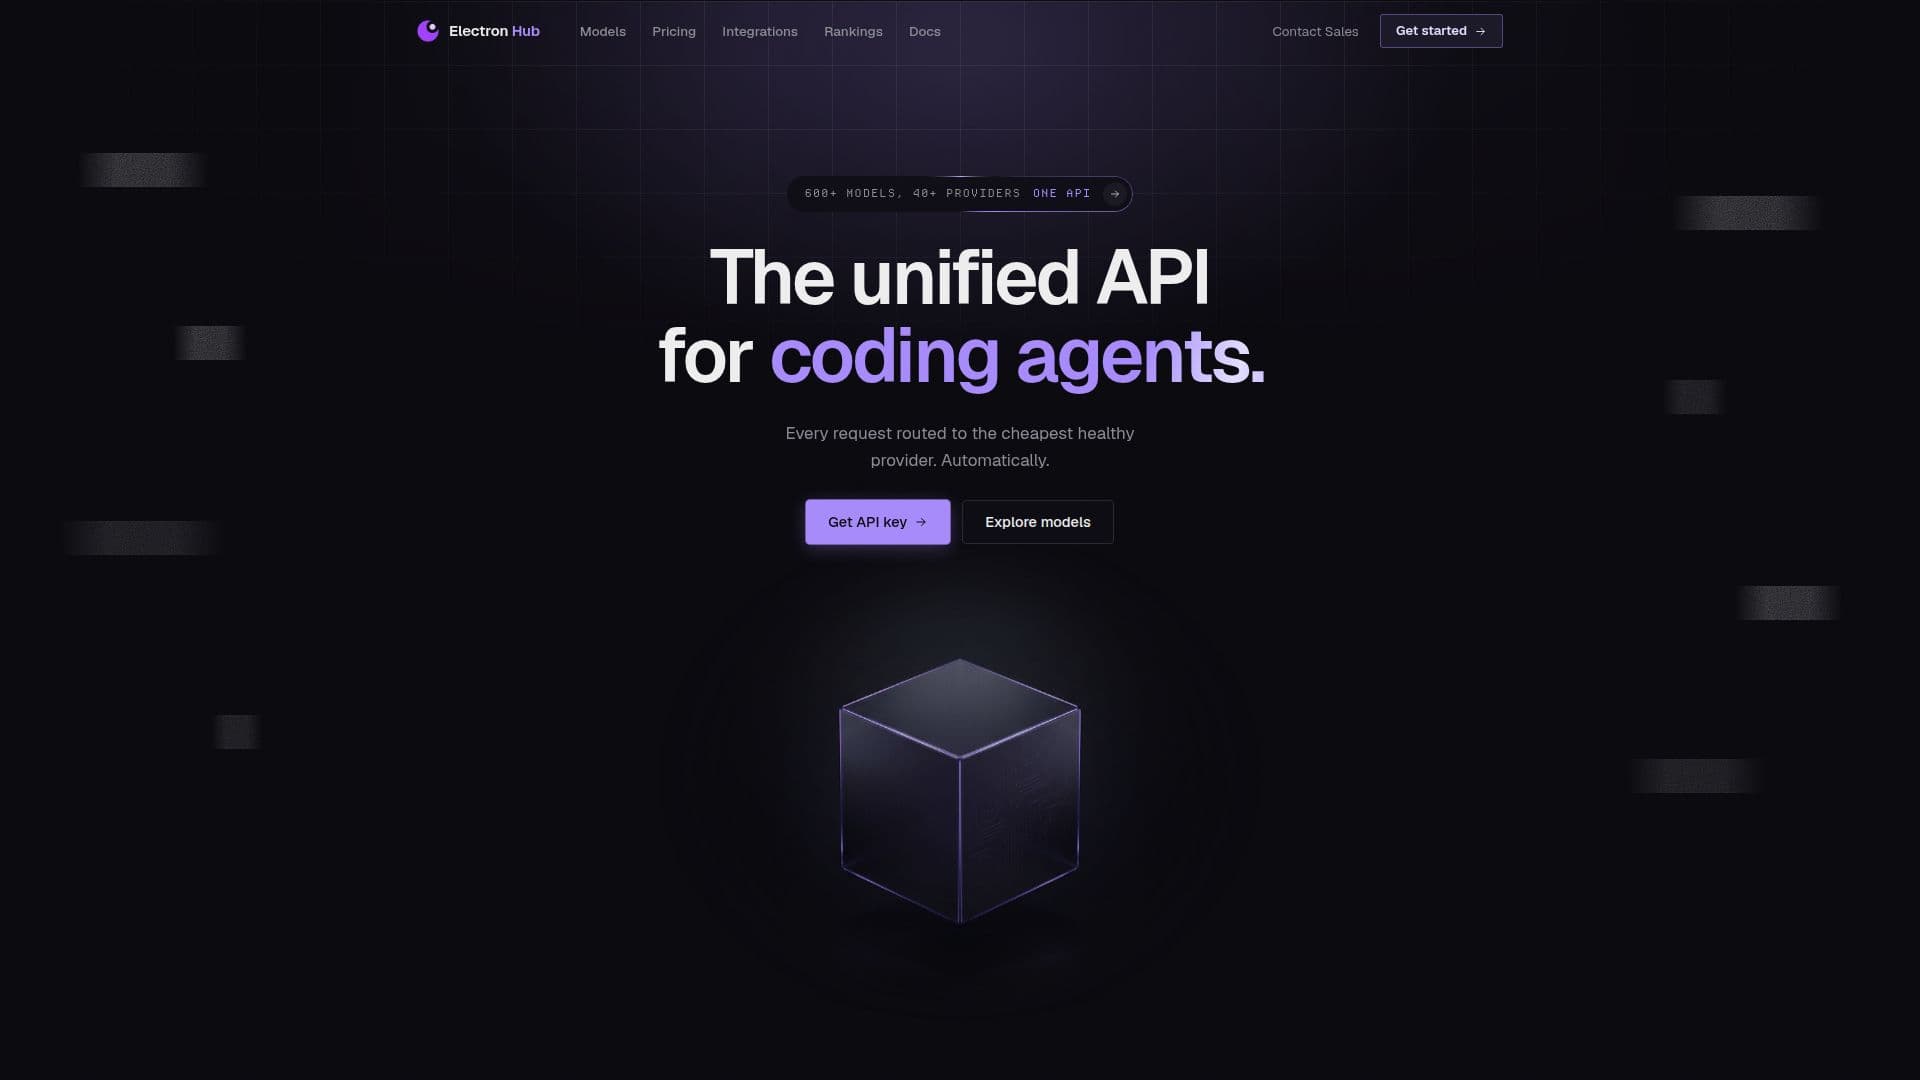
Electron Hub propose une passerelle API complète conçue pour rationaliser l'inférence des modèles de langage de grande taille (LLM) pour les développeurs et les entreprises. Il consolide l'accès à plus de 600 modèles provenant de plus de 40 fournisseurs différents via un seul point de terminaison compatible OpenAI. Cette approche unifiée élimine le verrouillage des fournisseurs et simplifie le processus d'intégration, permettant aux utilisateurs de changer de modèles en modifiant simplement une chaîne dans leur code.
Lire la suite
La fonctionnalité principale de la plateforme repose sur son routeur intelligent, qui dirige automatiquement chaque demande vers le fournisseur sain le moins cher en fonction d'une évaluation en temps réel du prix, de la latence et de la santé. Cela garantit des performances optimales et une efficacité économique sans nécessiter que les utilisateurs gèrent une logique de basculement complexe ou une infrastructure GPU. Electron Hub gère l'ensemble de la pile d'inférence, y compris l'API, l'exécution pour le traitement par lots et la mise en cache, ainsi que la flotte GPU sous-jacente, libérant ainsi les utilisateurs de la surcharge opérationnelle.
Au-delà du routage de base, Electron Hub intègre des fonctionnalités avancées de niveau production. Il comprend des garde-fous de sécurité en ligne tels que la suppression de PII, le scan d'injection et des filtres de politique qui traitent les demandes avant qu'elles n'atteignent le modèle, garantissant la sécurité des données. Le système dispose également d'une haute disponibilité avec plusieurs sources en amont par modèle et des mécanismes de réessai automatiques, transformant les pannes potentielles en petites interruptions. Les utilisateurs bénéficient d'un suivi détaillé des coûts par demande, montrant les jetons, la latence et les dépenses par clé, modèle et jour.
Electron Hub prend en charge jusqu'à 100 clés API spécifiques, chacune avec des limites de dépenses mensuelles individuelles, empêchant les frais inattendus. Il garantit un accès rapide aux nouveaux modèles, souvent dans les minutes suivant leur publication, sans nécessiter d'efforts de migration. La plateforme est compatible avec tout agent ou client qui parle OpenAI, permettant une intégration transparente en pointant simplement vers `api.electronhub.ai` et en sélectionnant un modèle dans le catalogue. Une console centrale fournit des informations en temps réel sur l'utilisation, les dépenses, la gestion des clés et la surveillance de la santé des fournisseurs, avec des capacités d'exportation complètes.
La sécurité et la confidentialité sont primordiales, avec une inférence fonctionnant éventuellement à l'intérieur d'environnements d'exécution de confiance (TEE) soutenus par du matériel. Cela garantit que les secrets restent en mémoire chiffrée et que chaque exécution est accompagnée d'une preuve de signature d'exécution. Le service est distribué à l'échelle mondiale, avec une capacité GPU à travers les Amériques, l'Europe et l'Asie, acheminant automatiquement les demandes vers la région saine la plus proche pour une faible latence. Le système est conçu pour un haut débit, rééquilibrant continuellement des millions de demandes par jour entre les fournisseurs. Les utilisateurs peuvent commencer rapidement avec des crédits hebdomadaires gratuits et sans carte de crédit requise.
- CatégorieMLOps et déploiement de modèles
- Modèle tarifaireFreemium
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de Electron Hub
Passerelle API unifiée pour plus de 600 modèles LLM
Prend en charge plus de 40 fournisseurs LLM
Point de terminaison unique compatible OpenAI
Basculement automatique des fournisseurs et équilibrage de charge
Routage basé sur le coût, la latence et la santé en temps réel
Facturation unifiée pour tous les fournisseurs
Gestion des pools GPU et évolutivité
Suppression de PII en ligne et scan d'injection
Filtres de politique pour la modération de contenu
Réessai automatique en cas de pannes
Suivi détaillé des coûts par clé, modèle et jour
Clés API spécifiques avec limites de dépenses mensuelles
Intégration rapide de nouveaux modèles
Compatibilité avec les agents/clients compatibles OpenAI
Console d'utilisation et de dépenses en temps réel
TEEs soutenus par du matériel pour une inférence sécurisée
Capacité GPU mondiale pour une faible latence
Comment utiliser Electron Hub ?
Commencez avec des crédits gratuits : Accédez à des crédits hebdomadaires sans carte de crédit pour commencer à utiliser la plateforme.
Configurer le point de terminaison API : Pointez votre client ou agent compatible OpenAI vers `api.electronhub.ai` comme URL de base.
Sélectionner des modèles : Choisissez parmi plus de 600 modèles provenant de plus de 40 fournisseurs en modifiant une seule chaîne dans votre configuration.
Intégrer avec des outils : Intégrez Electron Hub dans des outils comme Cursor, Cline, Zed ou Aider en modifiant la configuration OpenCode.
Surveiller l'utilisation : Utilisez la console centrale pour suivre l'utilisation, les dépenses, gérer les clés et visualiser la santé des fournisseurs en temps réel.
Cas d'utilisation de Electron Hub
- Routage d'inférence LLM
- Accès API unifié
- Optimisation des coûts
- Sécurité améliorée
- Haute disponibilité
- Productivité des développeurs
- Exécution d'agent
- Expérimentation de modèles
- Surveillance de l'utilisation
- Gestion des clés API