Description
Flide est une infrastructure d'inférence avancée spécifiquement conçue pour accélérer les modèles de décision de style Jev. Son innovation principale réside dans sa capacité à effectuer un forkage d'état exact, permettant à un seul état d'entrée d'être traité pour plusieurs questions en un seul passage en avant. Cela signifie que l'état est lu une seule fois, puis forké de manière efficace, garantissant que chaque question reçoit la réponse précise qu'elle obtiendrait si elle était posée isolément.
Lire la suite
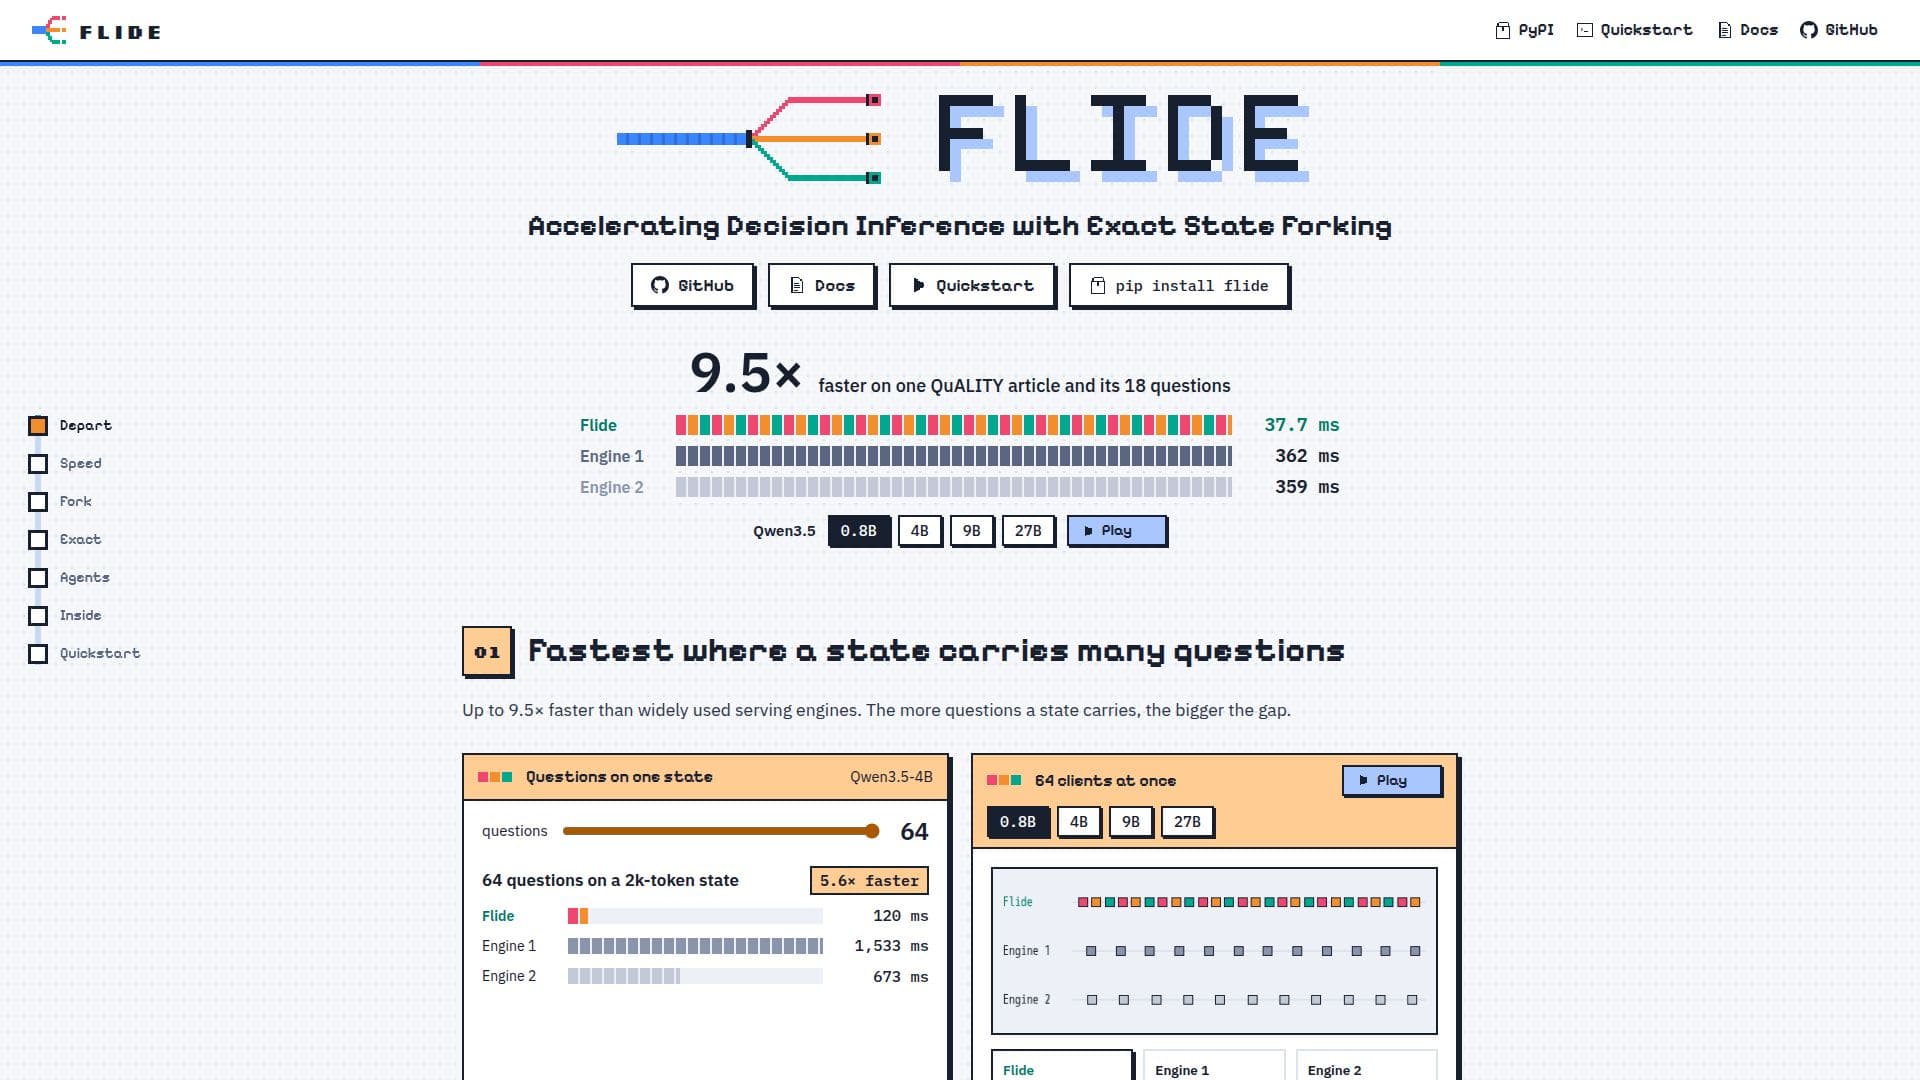
Cette architecture unique offre des gains de performance substantiels, Flide démontrant jusqu'à 9,5 fois une inférence plus rapide par rapport à des moteurs de service largement utilisés comme vLLM et SGLang. L'avantage de performance devient encore plus prononcé à mesure que le nombre de questions associées à un état donné augmente. Par exemple, avec 64 questions sur un état de 2k tokens, Flide atteint un gain de vitesse de 9,5x et un débit 2,2x plus élevé avec 64 clients.
Au-delà de la vitesse, Flide priorise la précision, restant dans une marge de 1,1 point par rapport à une référence float32, ce qui en fait l'un des moteurs les plus proches d'une référence de vérité de terrain. Il prend en charge une variété de modèles, y compris des modèles de chat basés sur Qwen3.5 et Gemma 4, ainsi que des modèles OneJev. Flide gère également des modèles hybrides, où les couches Gated DeltaNet garantissent que chaque question commence à partir de l'état exact du contexte partagé. Le système propose une option `--batch-invariant`, garantissant qu'une requête produit les mêmes bits indépendamment de la façon dont elle est batchée.
L'installation est simple via pip, et elle prend en charge le service avec des noyaux préconstruits pour divers GPU NVIDIA, y compris A40, A10, RTX 30, H100 et H200. Flide expose la même API `/v1/systemone` que vLLM et SGLang, fournissant des probabilités pour chaque option dans la réponse. Il prend en charge des entrées multimodales, y compris du texte, des images et de la vidéo, selon le modèle de base. Des fonctionnalités telles que la quantification FP8 pour Qwen3.5 sur les GPU Ada, Hopper et Blackwell, ainsi qu'un cache de session pour reprendre les états des agents, améliorent encore ses capacités.
- CatégorieMLOps et déploiement de modèles
- DéploiementAuto-hébergé
- PlateformesWeb
Fonctionnalités principales de Flide
Forkage d'État Exact : Traite un état pour toutes les questions en un seul passage en avant.
Inférence Accélérée : Jusqu'à 9,5 fois plus rapide que d'autres moteurs de service.
Débit Élevé : Atteint un débit 2,2x avec 64 clients sur des benchmarks spécifiques.
Proximité de Référence Float32 : Reste dans 1,1 point d'une référence float32 pour la précision.
Invariance de Batch : Garantit des résultats cohérents indépendamment du batching avec `--batch-invariant`.
Mécanisme ForkAttention : Chaque question lit son état sur place, comme si elle était posée seule.
Exact sur les Modèles Hybrides : Prend en charge les couches Gated DeltaNet pour un traitement précis du contexte.
Traitement de Flux Plat Unique : Exécute les requêtes comme un seul flux de tokens rejoué par des graphes CUDA.
API Compatible vLLM/SGLang : Utilise la norme API `/v1/systemone`.
Noyaux Préconstruits : Optimisés pour les GPU NVIDIA A40, A10, RTX 30, H100 et H200.
Modèles de Base : Prend en charge Qwen3.5 (0,8B, 2B, 4B, 9B, 27B) et Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).
Entrées Multimodales : Gère les entrées de texte, d'images et de vidéos.
Quantification FP8 : Exécute Qwen3.5 en FP8 sur les GPU Ada, Hopper et Blackwell.
Cache de Session : Conserve les états antérieurs pour que les agents puissent reprendre (par exemple, `--session-cache-gb 40`).
Processus Frontend : Prend en charge l'exécution de HTTP, le rendu et la tokenisation dans des processus séparés pour de nombreux clients.
Comment utiliser Flide ?
Installer Flide : Utilisez pip pour installer le package Flide.
Démarrer un Serveur : Exécutez `flide serve` pour démarrer le serveur d'inférence, en spécifiant éventuellement `--host`.
Configurer les Modèles : Servez des modèles de chat comme Qwen3.5 ou Gemma 4 directement, ou fusionnez des adaptateurs Open-Jev.
Envoyer des Requêtes : Interagissez avec le serveur en utilisant l'API `/v1/systemone` pour envoyer des états et des questions.
Traiter des Entrées Multimodales : Incluez des chemins d'images dans l'état et envoyez des médias pour les modèles prenant en charge les images.
Cas d'utilisation de Flide
- Modèles de Décision Accélérés
- Inférence Multimodale
- Traitement de Batch Cohérent
- Gestion de l'État des Agents
- Service LLM Haute Performance
- Recherche et Développement