Description
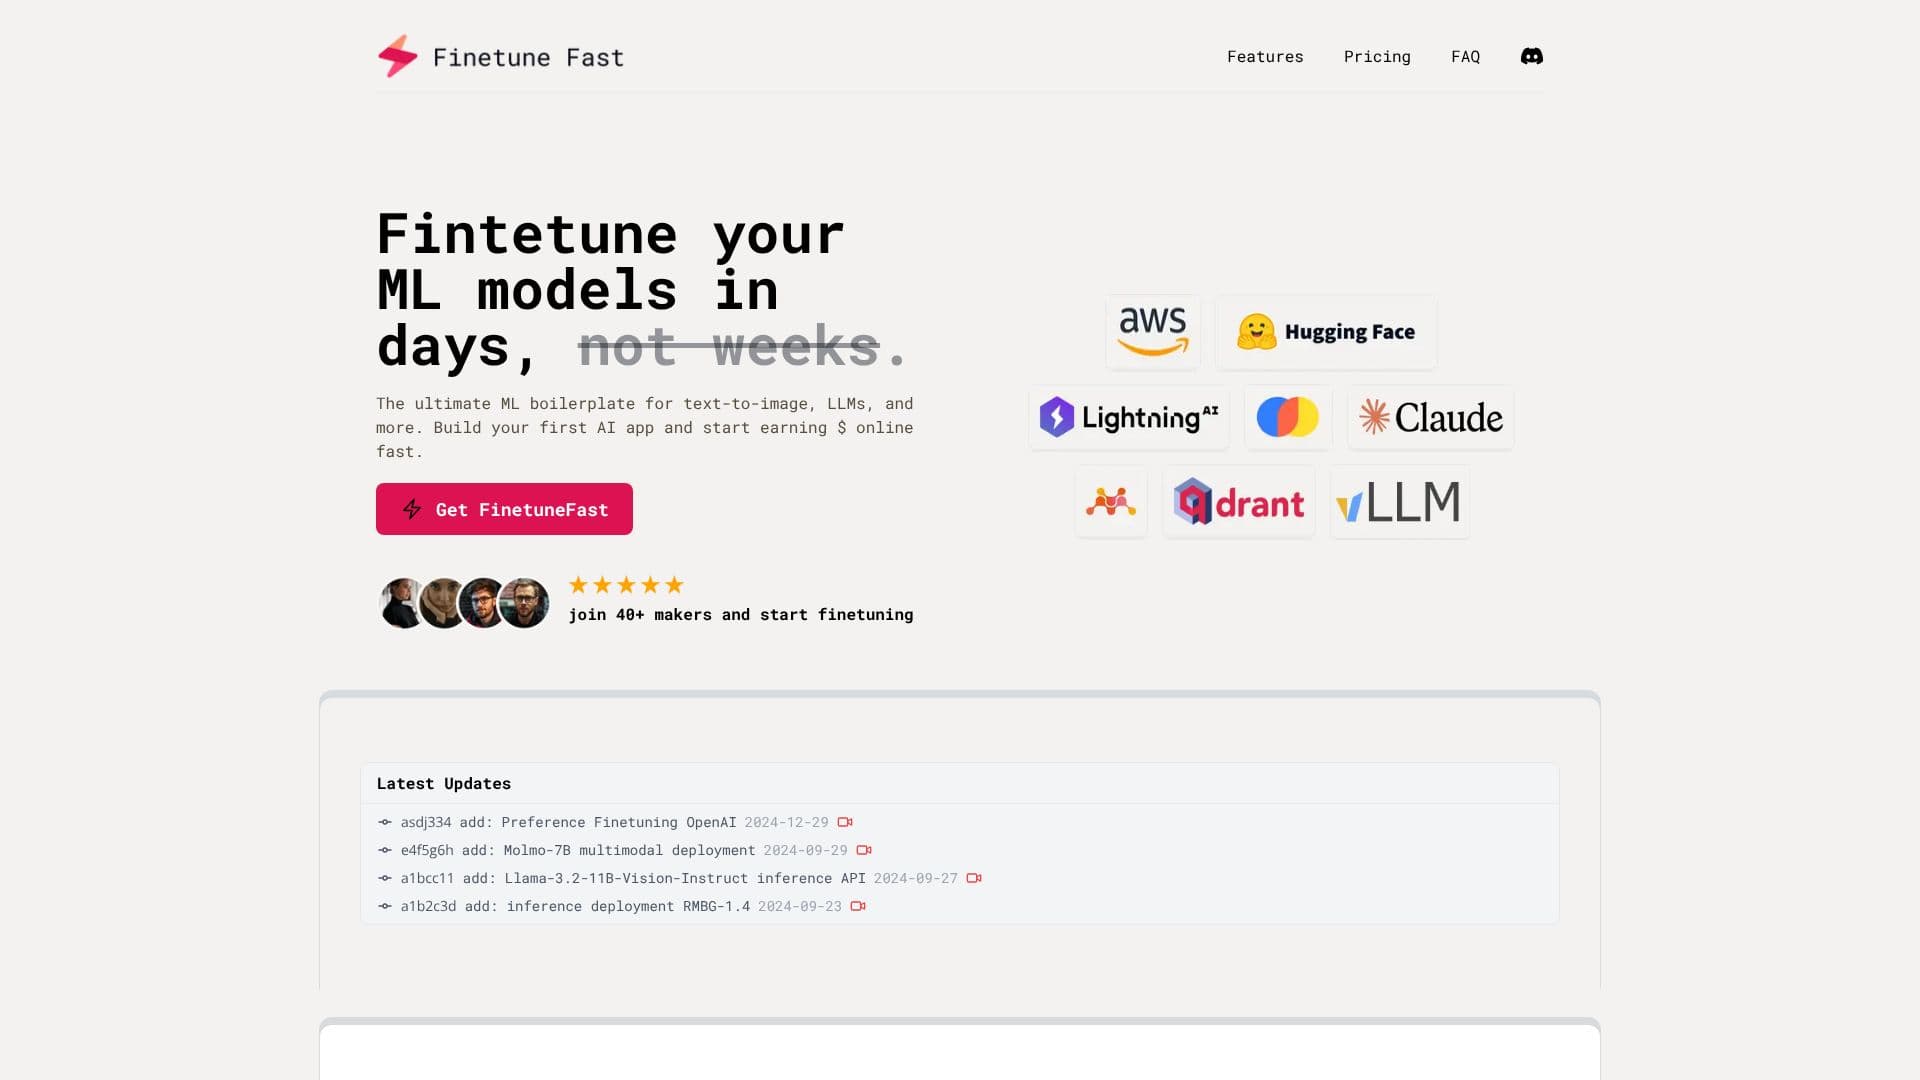
FinetuneFast est conçu pour rationaliser le processus de lancement de modèles d'IA, permettant aux développeurs et aux créateurs d'affiner les modèles d'apprentissage automatique en quelques jours plutôt qu'en quelques semaines. Il s'attaque aux principaux goulets d'étranglement du développement ML, tels que la configuration des environnements, l'installation des dépendances, la préparation des données d'entraînement, l'intégration des API, l'évaluation des modèles et leur déploiement en production.
Lire la suite
La plateforme propose des scripts d'entraînement préconfigurés, des pipelines de chargement de données efficaces, des outils d'optimisation des hyperparamètres et un support multi-GPU, tous conçus pour accélérer l'entraînement des modèles. Pour le déploiement et la mise à l'échelle, FinetuneFast fournit un déploiement de modèle en un clic, une infrastructure d'auto-mise à l'échelle, la génération de points d'accès API et la configuration de la surveillance/journalisation. Cette approche complète vise à faire économiser aux utilisateurs plus de 10 heures sur l'entraînement des modèles et 10 heures supplémentaires sur le déploiement et la mise à l'échelle.
Créé par un ingénieur ML expérimenté dans le fine-tuning, l'optimisation et le déploiement en production, FinetuneFast vise à aider les individus et les entreprises à se concentrer sur l'innovation plutôt que sur l'infrastructure. L'outil convient à diverses applications d'IA, y compris les modèles texte-vers-image, les LLM et les applications RAG, prenant en charge des modèles tels que FLUX.1-schnell, Mistral7B, GPT4o-mini et Pixtral.
FinetuneFast propose deux niveaux de prix : Starter, pour les particuliers et les petites équipes, et All In, pour les entreprises et les utilisateurs avancés. Les deux plans donnent accès à des boilerplates de fine-tuning et d'inférence, des exemples RAG et des modèles pour expédier rapidement des produits AI-SaaS. Le plan All In inclut également l'accès à la communauté Discord, les mises à jour à vie et les meilleures pratiques pour un fine-tuning de haute qualité.
La proposition de valeur est centrée sur la vitesse et l'efficacité, permettant aux utilisateurs de construire et de déployer des solutions d'IA plus rapidement et de manière plus fiable. Il s'adresse à un large éventail d'utilisateurs, des débutants en ML qui peuvent bénéficier d'une documentation claire et d'un support communautaire aux ingénieurs ML expérimentés cherchant à optimiser leur flux de travail. La plateforme met l'accent sur un modèle de paiement unique pour des projets illimités, offrant une solution rentable pour le développement rapide d'IA.
- CatégoriePlateformes de machine learning
- Modèle tarifairePayer une fois
- DéploiementEn un clic
- PlateformesWeb
Fonctionnalités principales de FinetuneFast
Scripts d'entraînement préconfigurés pour un entraînement de modèle plus rapide
Pipelines de chargement de données efficaces pour un traitement des données rationalisé
Outils d'optimisation des hyperparamètres pour améliorer les performances du modèle
Support multi-GPU pour un entraînement accéléré sur du matériel puissant
Capacités de fine-tuning de modèles d'IA sans code
Déploiement de modèle en un clic pour une préparation simplifiée à la production
Infrastructure d'auto-mise à l'échelle pour gérer une charge accrue
Génération de points d'accès API pour une intégration facile
Configuration de la surveillance et de la journalisation pour les environnements de production
Exemples et modèles RAG (Retrieval-Augmented Generation)
Boilerplates d'inférence prêts pour la production
Meilleures pratiques pour le fine-tuning de modèles de haute qualité
Mises à jour à vie pour le plan 'All In'
Accès à la communauté Discord pour le support et le réseautage
Comment utiliser FinetuneFast ?
Configurer : Sélectionner et adapter les boilerplates de fine-tuning et les exemples RAG.
Préparer les données : Utiliser des pipelines de chargement de données efficaces et les meilleures pratiques.
Entraîner le modèle : Tirer parti des scripts préconfigurés, de l'optimisation des hyperparamètres et du support multi-GPU.
Évaluer le modèle : Mettre en œuvre les procédures et métriques d'évaluation fournies.
Déployer le modèle : Utiliser le déploiement en un clic et l'infrastructure d'auto-mise à l'échelle.
Intégrer : Se connecter aux API à l'aide des points d'accès générés.
Surveiller : Utiliser la surveillance et la journalisation intégrées.
Cas d'utilisation de FinetuneFast
- Entraînement de modèles accéléré
- Déploiement rapide de modèles d'IA
- Création de produits SaaS d'IA
- Fine-tuning de LLM
- Génération de texte-vers-image
- Développement d'applications RAG
- Optimisation du flux de travail ML