Description
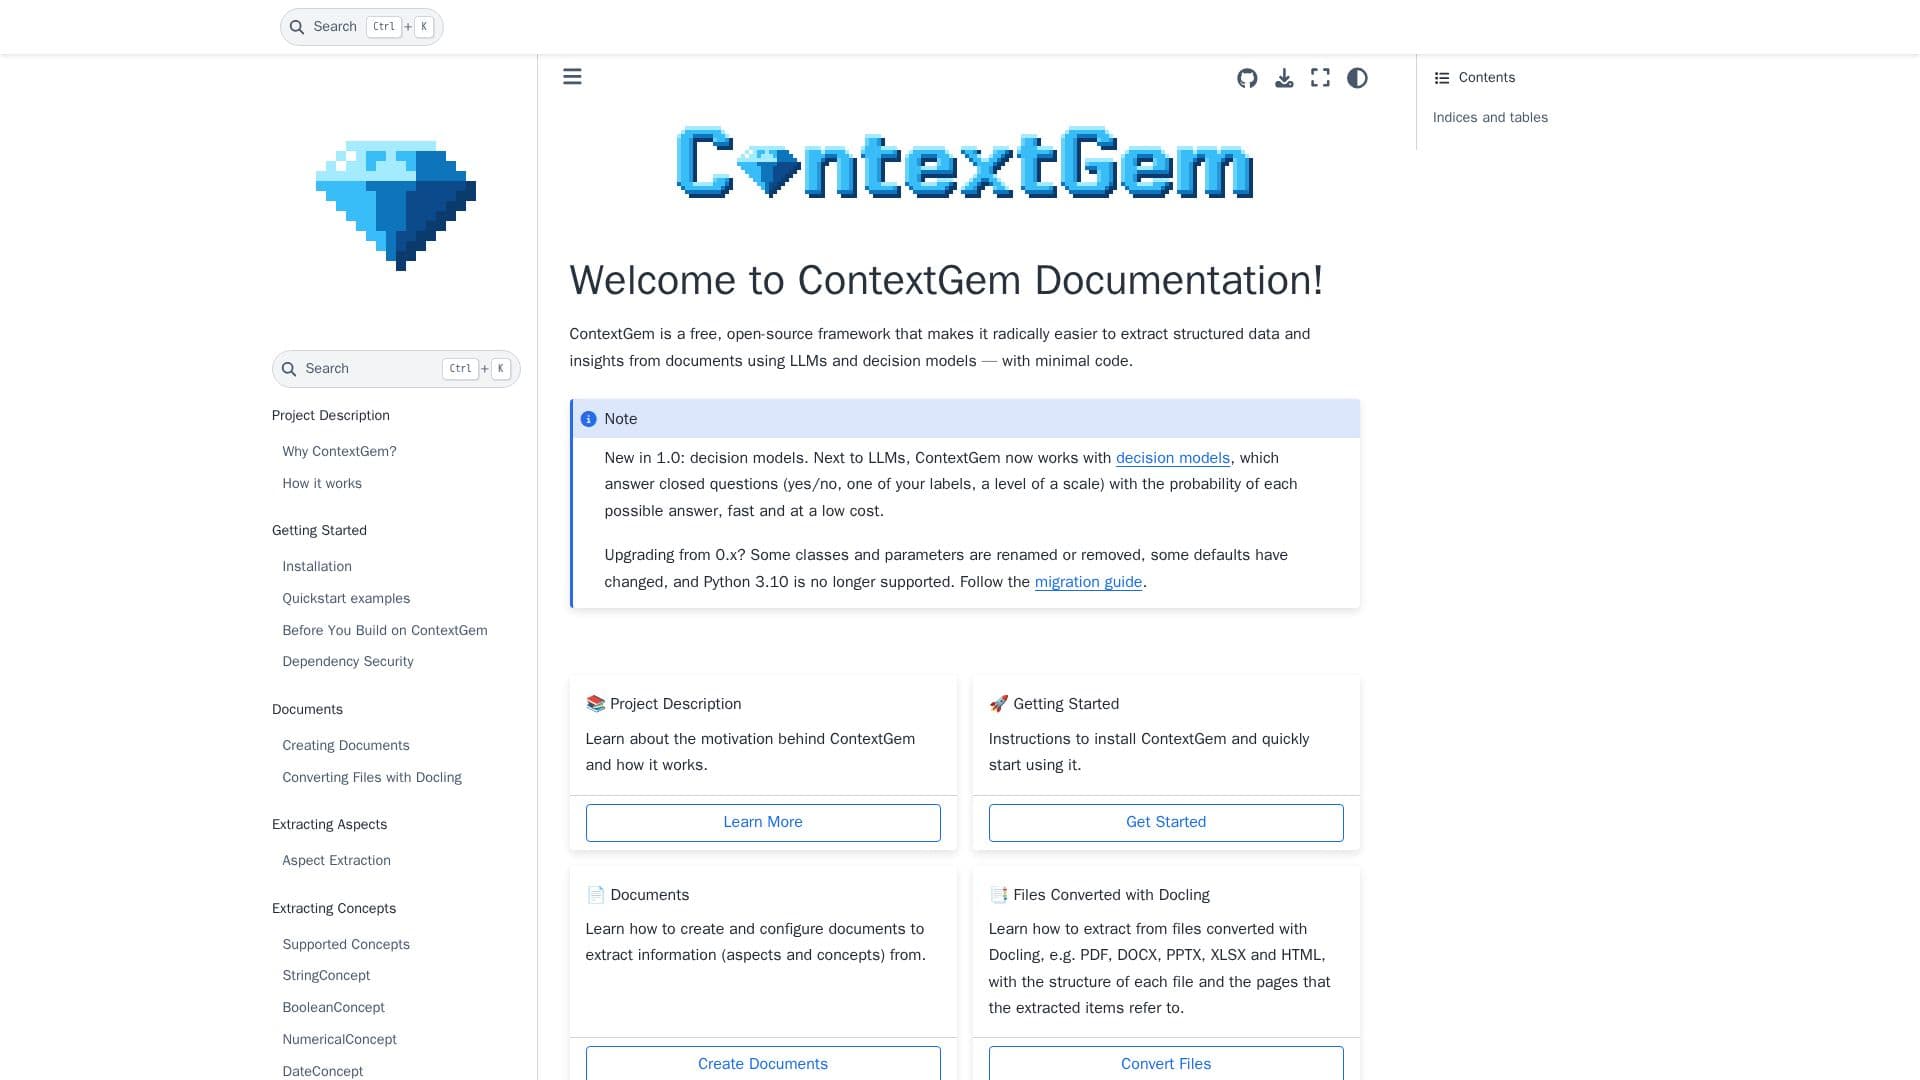
ContextGem est un cadre gratuit et open-source qui simplifie l'extraction de données structurées et d'informations à partir de documents en utilisant des modèles de langage de grande taille (LLMs) et des modèles de décision. Il est conçu pour une analyse approfondie des documents individuels, garantissant que chaque paragraphe est lu pour éviter de manquer des faits, contrairement aux approches de génération augmentée par récupération (RAG) qui peuvent avoir des difficultés avec des concepts complexes en raison d'incohérences de récupération.
Lire la suite
Les composants principaux du cadre incluent les Documents, les Aspects et les Concepts. Un Document peut contenir du texte et/ou du contenu visuel provenant de diverses sources telles que des contrats, des factures, des CV ou des documents généraux. Les Aspects représentent des domaines ou des sujets définis au sein d'un document, permettant une extraction granulaire avec des sous-aspects hiérarchiques. Les Concepts sont des unités d'information ou des entités dérivées des aspects ou du contexte plus large du document, allant des extractions factuelles comme les clauses pénales aux insights analytiques, conclusions raisonnées et jugements interprétatifs. ContextGem prend en charge plusieurs types de concepts, y compris StringConcept, BooleanConcept, NumericalConcept, DateConcept, JsonObjectConcept, RatingConcept et LabelConcept.
ContextGem offre des flux de travail d'extraction flexibles utilisant différents types de modèles. Le DocumentLLM permet à un LLM configurable unique d'extraire tous les aspects et concepts, y compris le contenu multimodal si le modèle prend en charge la vision. Il prend également en charge des modèles de secours pour plus de robustesse. Le DocumentDecisionModel est conçu pour des questions fermées (oui/non, choisir une option, évaluer sur une échelle), fournissant des probabilités pour chaque réponse possible sans générer de texte, ce qui le rend rapide et rentable pour des types de concepts spécifiques. Pour des scénarios plus complexes, le DocumentModelGroup permet l'utilisation de plusieurs modèles avec des rôles uniques, permettant à différents LLM ou modèles de décision de traiter des aspects ou des concepts spécifiques en fonction de leur complexité ou de leur type.
Le cadre est conçu pour s'intégrer dans des flux de travail agentiques à trois points clés : lors de l'ingestion de documents pour l'extraction de métadonnées, comme un outil d'extraction à la demande par un agent, et aux points de décision où un modèle de décision peut répondre à des questions fermées pour guider le flux de travail. ContextGem met l'accent sur l'optimisation des coûts grâce à des stratégies telles que la sélection de modèles rentables, l'utilisation de modèles de décision pour des questions fermées, l'exploitation de paramètres par défaut, l'activation des justifications uniquement lorsque cela est nécessaire, et la surveillance de l'utilisation et des coûts. Il fournit également des pratiques de sécurité robustes, y compris le verrouillage des dépendances, l'adoption différée de nouvelles versions et des vérifications contre des avis connus pour atténuer les risques de chaîne d'approvisionnement.
- CatégorieOutils de traitement du langage naturel
- Modèle tarifaireGratuit
- DéploiementAuto-hébergé
- PlateformesWeb
Fonctionnalités principales de ContextGem
Extraction de données structurées à partir de documents
Exploite les LLM pour une extraction ouverte
Utilise des modèles de décision pour des questions fermées (oui/non, étiquettes, évaluations)
Prend en charge divers types de documents (PDF, DOCX, PPTX, XLSX, HTML)
Extrait des sections spécifiques de documents à l'aide de l'API Aspects
Infère des données structurées comme JSON, chaînes, nombres, dates, booléens avec l'API Concepts
Construit des pipelines d'extraction réutilisables
Fournisseurs de LLM configurables et modèles locaux
Optimise l'extraction pour la précision, le coût et la performance
Sérialisation et désérialisation des objets ContextGem
Intégration avec des flux de travail agentiques
Documentation API détaillée
Cadre open-source
Stratégies d'optimisation des coûts
Pratiques de sécurité des dépendances
Comment utiliser ContextGem ?
Installer ContextGem : Suivez les instructions pour configurer le cadre.
Créer des Documents : Configurez des documents pour l'extraction d'informations.
Convertir des Fichiers : Traitez des fichiers comme PDF, DOCX, PPTX, XLSX et HTML.
Extraire des Aspects : Identifiez et extrayez des sections spécifiques de documents.
Extraire des Concepts : Inférez des données structurées comme JSON, chaînes, nombres et dates.
Construire des Pipelines : Créez des pipelines d'extraction réutilisables pour une analyse cohérente.
Explorer les Modèles : Configurez et utilisez des fournisseurs de LLM cloud pris en charge et des modèles locaux.
Optimiser l'Extraction : Mettez en œuvre des stratégies pour l'efficacité des coûts et des performances.
Cas d'utilisation de ContextGem
- Analyse de Contrat
- Traitement de Factures
- Analyse de CV
- Extraction de Données de Recherche Médicale
- Analyse de Rapports Financiers
- Revue de Documents Techniques
- Extraction de Politiques RH
- Extraction de Métadonnées de Document
- Intégration d'Outils d'Agent
- Prise de Décision dans les Flux de Travail