Description
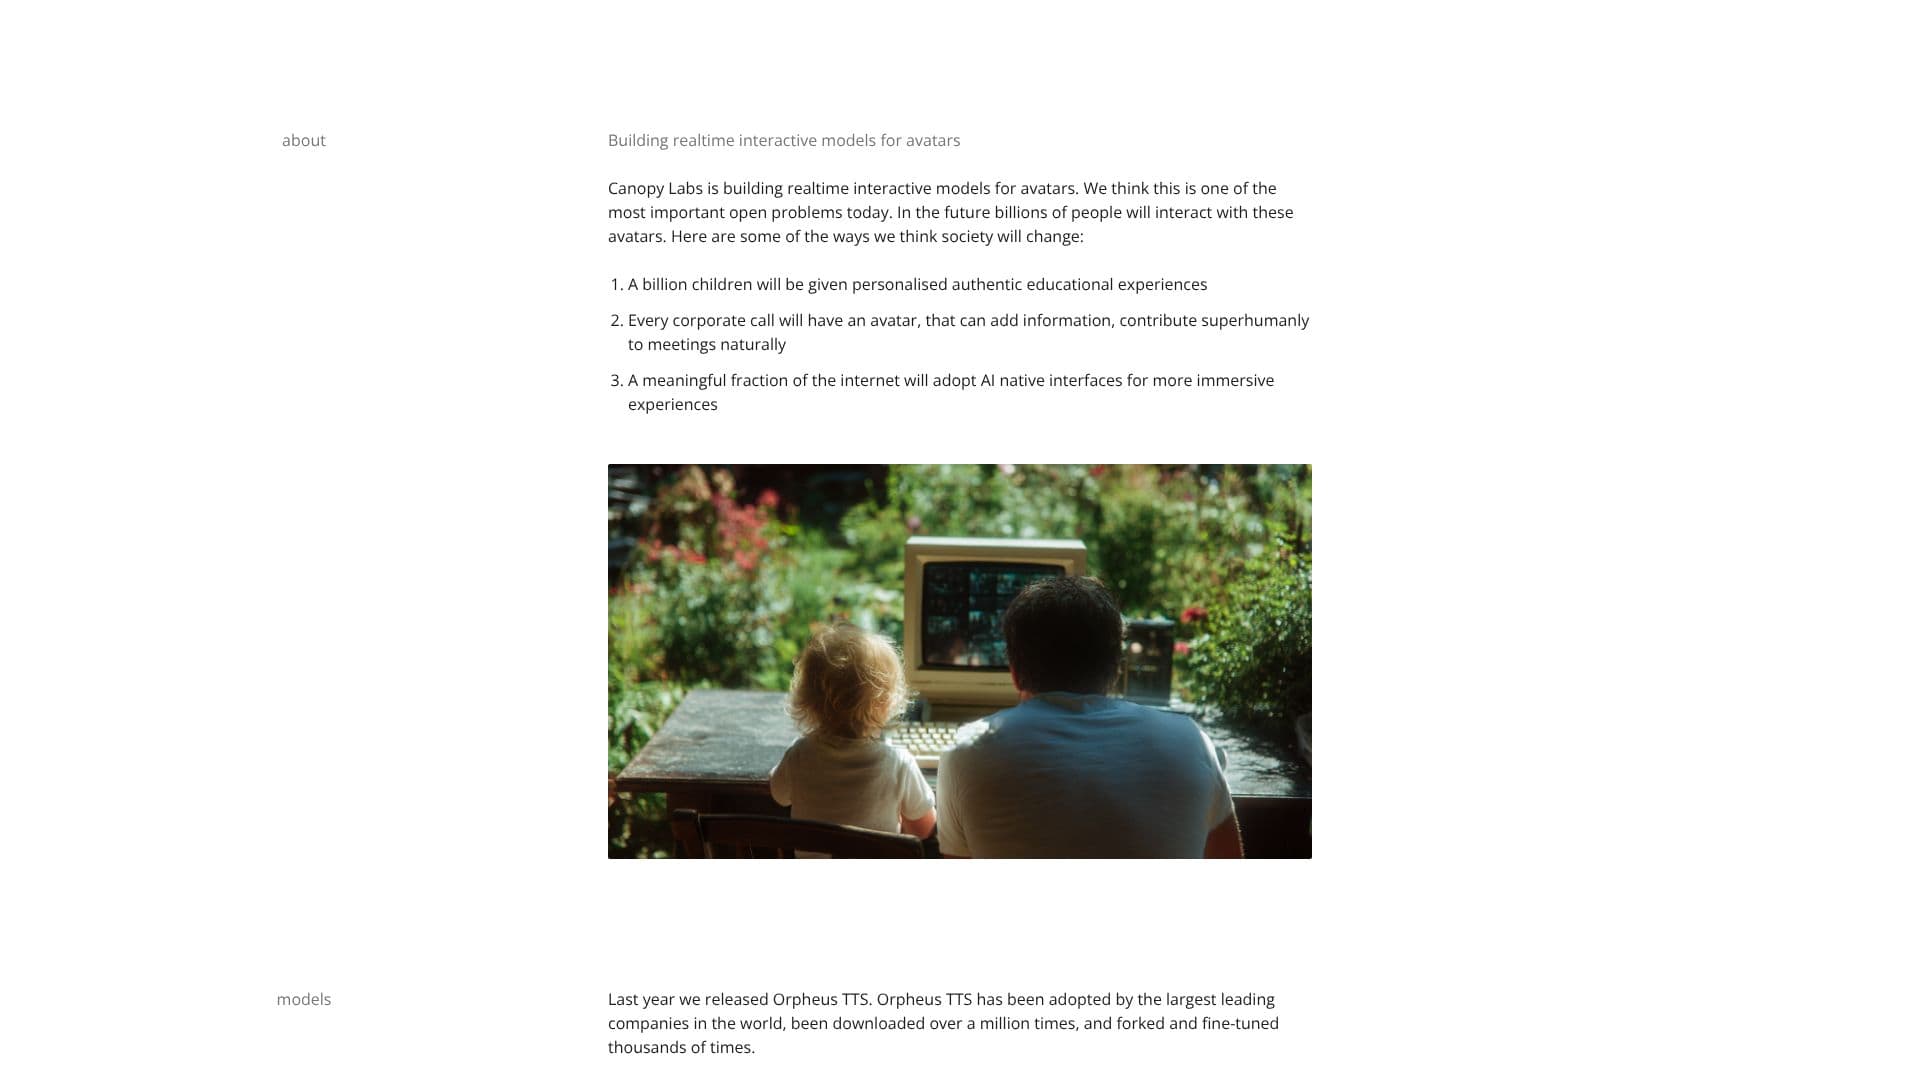
Canopy Labs décrit son travail comme la construction de modèles interactifs en temps réel pour des avatars, avec l'objectif déclaré de développer des humains numériques indiscernables des réels. L'entreprise présente cela comme un problème de recherche ouvert qu'elle s'attend à redéfinir la manière dont les gens interagissent avec les logiciels, énumérant des scénarios tels que des expériences éducatives personnalisées et des avatars participant à des réunions d'entreprise comme des directions qu'elle s'attend à ce que la technologie permette ; ce sont la vision déclarée de l'entreprise plutôt que des fonctionnalités commercialisées.
Lire la suite
Canopy Labs a précédemment lancé Orpheus TTS, qu'elle dit avoir été adopté par des entreprises, téléchargé plus d'un million de fois, et forké ou affiné des milliers de fois (selon les chiffres de l'entreprise). Depuis lors, Canopy Labs déclare avoir levé 17 millions de dollars et développe d'autres modèles de parole et d'avatar qui ne sont pas encore publics.
Le produit disponible aujourd'hui est Orpheus v1, un modèle de synthèse vocale proposé en deux niveaux, Base et Flash. Il est nativement multilingue, prenant en charge l'anglais, l'hindi, le mandarin, l'allemand, le japonais, le français, l'italien, le portugais, le russe, l'espagnol et le coréen, et prend en charge des indications scéniques en ligne dans un script, telles que marquer une ligne comme énoncée de manière indistincte ou émotionnelle, pour façonner la manière dont elle est livrée. Canopy Labs déclare que le modèle a une latence ultra-faible, avec un temps de réponse p99 dans les 30 millisecondes de sa référence. Une bibliothèque vocale est fournie avec plus de 30 voix prédéfinies, et le clonage vocal professionnel ou en une seule prise peut créer une voix de marque personnalisée à partir de quelques heures d'audio.
Pour les clients d'entreprise, Orpheus peut être déployé sur site ou dans un cloud privé avec un support prioritaire et un SLA, plutôt que seulement via une API hébergée. Sur son site, Canopy Labs démontre le modèle à travers plusieurs styles de livraison prédéfinis, y compris une voix de support client, un ton auto-réflexif, une lecture théâtrale, une narration pour l'apprentissage des langues, et une voix de coach de méditation, pour montrer le même modèle gérant différents registres. Canopy Labs ne publie pas de prix public pour Orpheus sur son site.
- CatégorieGénérateurs d'avatars IA
- DéploiementCloud
- PlateformesWeb
Fonctionnalités principales de Canopy Labs
Modèle de synthèse vocale (Orpheus v1) disponible en niveaux Base et Flash
Nativement multilingue dans onze langues, y compris l'anglais, l'hindi et le mandarin
Prend en charge des indications scéniques en ligne pour contrôler la livraison émotionnelle d'une ligne
Propose un clonage vocal professionnel et en une seule prise à partir de quelques heures d'audio
Fournit une bibliothèque de plus de 30 voix prédéfinies
Affirme une latence ultra-faible, avec p99 dans les 30 millisecondes de référence
Prend en charge le déploiement sur site ou dans le cloud privé pour les entreprises avec support SLA
Recherche des modèles d'avatar interactifs en temps réel au-delà de son produit de parole commercialisé
Comment utiliser Canopy Labs ?
Choisir un niveau de modèle : Choisissez Orpheus v1 Base ou Flash en fonction des besoins en latence et en qualité.
Sélectionner ou cloner une voix : Utilisez une voix de la bibliothèque ou clonez-en une personnalisée à partir d'un audio d'exemple.
Écrire le script : Ajoutez des indications scéniques pour façonner la livraison, comme le ton ou l'émotion.
Choisir un déploiement : Utilisez le modèle hébergé ou organisez un déploiement sur site ou dans le cloud privé.
Intégrer la sortie : Alimentez la parole générée dans un produit, un avatar ou un flux de travail de support.
Cas d'utilisation de Canopy Labs
- Prototypage de produit vocal
- Voix de support client
- Narration pour l'apprentissage des langues
- Déploiement sur site pour les entreprises