Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

WeVisOne-VL

WeVisOne-VL es un modelo unificado de visión-lenguaje desarrollado por WeChat Vision de Tencent. Integra la percepción a nivel de objeto y píxel para tareas como la detección de objetos y el enmascaramiento de imágenes, utilizando un decodificador de píxeles ligero.

Visitar URL
Compartir
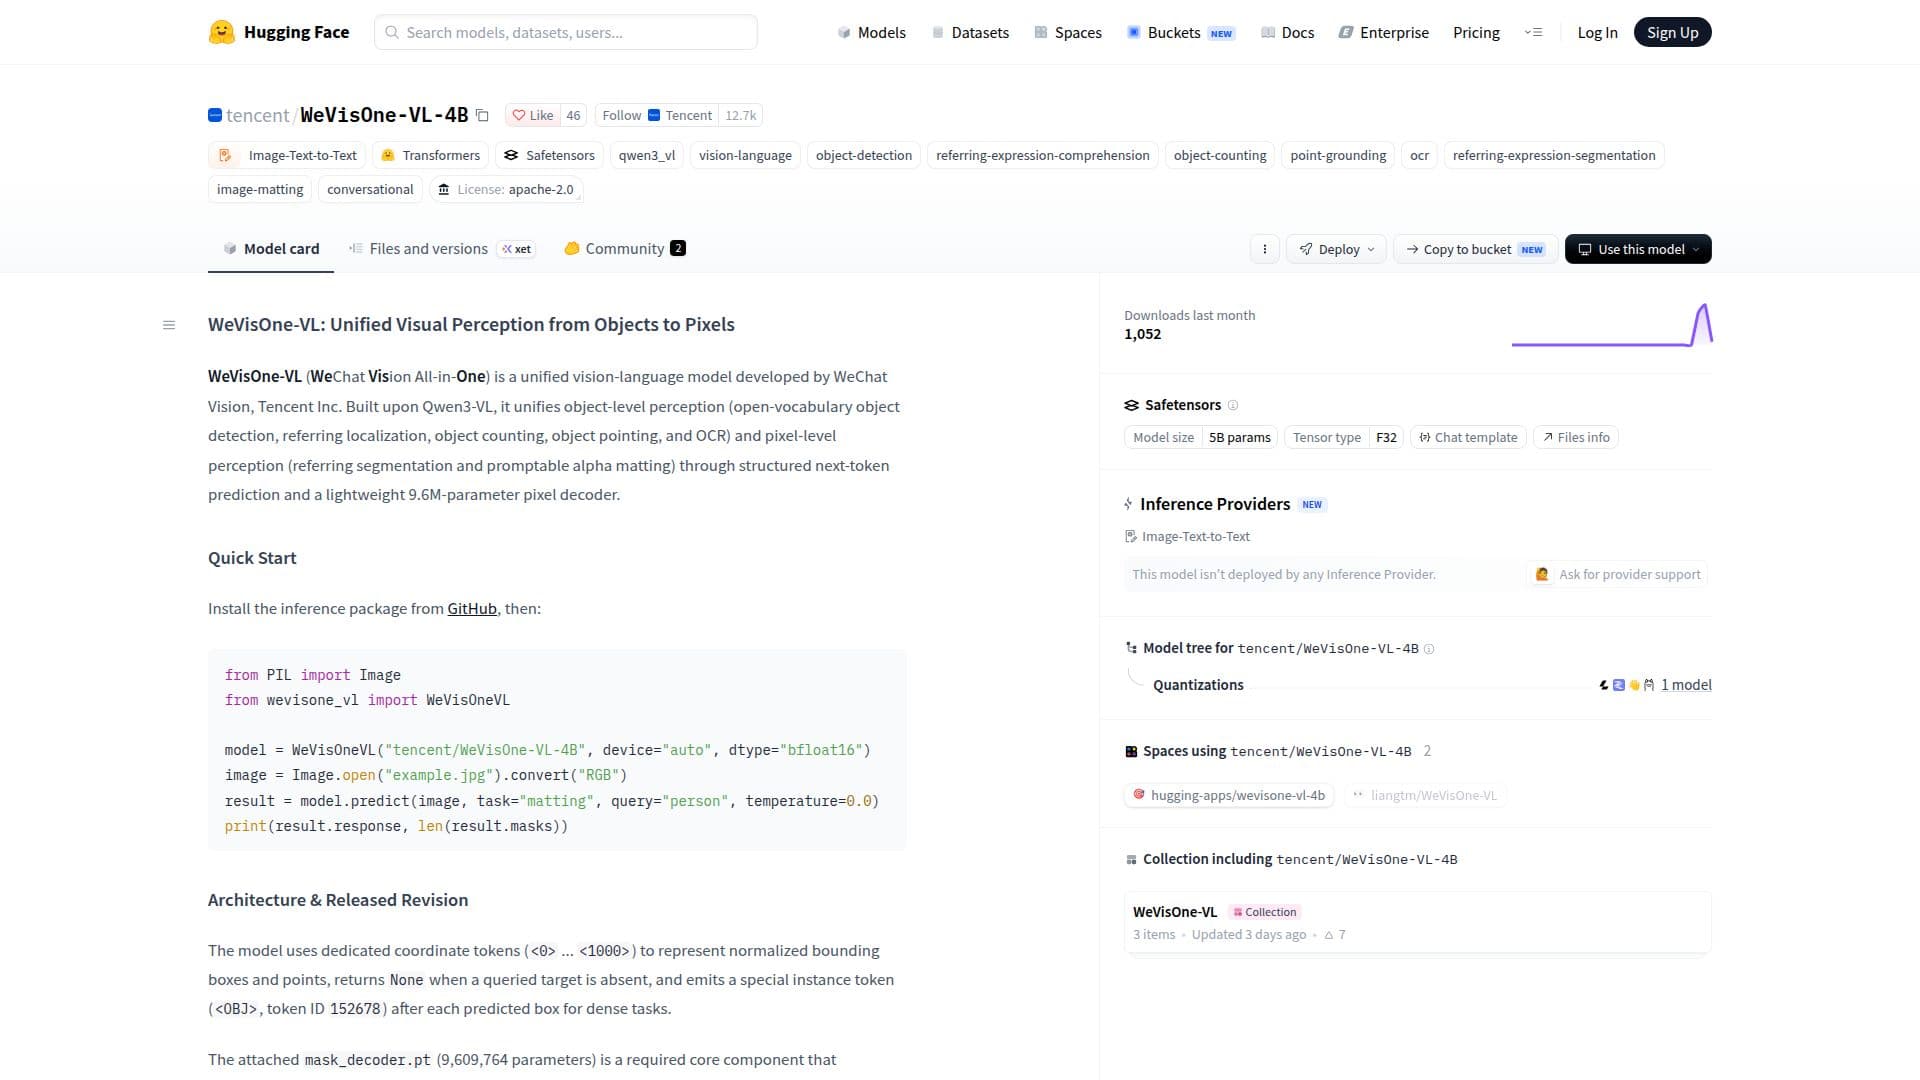
Captura de pantalla de WeVisOne-VL

WeVisOne-VL es un modelo de visión-lenguaje desarrollado por WeChat Vision, una parte de Tencent Inc. Está diseñado para unificar tareas de percepción a nivel de objeto y a nivel de píxel. Basado en el marco Qwen3-VL, WeVisOne-VL admite una variedad de tareas visuales, incluyendo detección de objetos de vocabulario abierto, localización referida, conteo de objetos, señalización de objetos y reconocimiento óptico de caracteres (OCR).

Leer más

Además, maneja tareas a nivel de píxel como la segmentación referida y el enmascaramiento alfa programable. El modelo emplea una predicción estructurada del siguiente token y cuenta con un decodificador de píxeles ligero de 9.6 millones de parámetros.

La arquitectura de WeVisOne-VL incluye tokens de coordenadas dedicados para representar cajas delimitadoras normalizadas y puntos. Utiliza un token de instancia especial para tareas densas e integra un decodificador de máscaras como componente central. Este decodificador combina un Adaptador de Características Visuales, un Decodificador de Consultas Guiadas por Cajas y una Cabeza de Predicción Densa Condicionada por Instancias para refinar las predicciones y generar máscaras alfa a resolución completa.

WeVisOne-VL está destinado a fines de investigación en anclaje visual, localización referida, señalización, conteo, localización OCR, segmentación referida y enmascaramiento de imágenes. No está diseñado para la toma de decisiones autónomas de alto impacto o identificación individual. El modelo es eficiente en la generación de salidas estructuradas, pero no admite razonamiento explícito en cadena y actualmente está limitado a la percepción de imágenes en una sola interacción.

El modelo se publica bajo la Licencia Apache 2.0, con componentes de terceros que mantienen sus licencias originales. Ha sido descargado más de 1,000 veces en el último mes, lo que indica su creciente popularidad en la comunidad de investigación.

  • CategoríaModelos de IA y LLM
  • Modelo de preciosGratis
  • ImplementaciónNube
  • PlataformasWeb

  • Modelo unificado de visión-lenguaje

  • Percepción a nivel de objeto

  • Percepción a nivel de píxel

  • Decodificador de píxeles de 9.6 millones de parámetros

  • Predicción estructurada del siguiente token

  • Tokens de coordenadas dedicados

  • Token de instancia especial para tareas densas

  • Licencia Apache 2.0

  1. Acceder a la página del modelo: Visita la página de Hugging Face para WeVisOne-VL

  2. Autenticarse: Asegúrate de tener los permisos necesarios para acceder al modelo

  3. Configurar: Establece los parámetros del modelo según tus necesidades de investigación

  4. Enviar solicitudes: Introduce tus tareas visuales para su procesamiento

  5. Ajustar: Modifica el modelo para tareas específicas si es necesario

  • Detección de Objetos
  • Localización Referida
  • Conteo de Objetos
  • Localización OCR
  • Enmascaramiento de Imágenes
Herramientas de IA populares como WeVisOne-VL

WeVisOne-VL es un modelo unificado de visión-lenguaje desarrollado por WeChat Vision, Tencent Inc. Integra la percepción a nivel de objeto y a nivel de píxel para tareas como la…

Herramientas de visión artificial
Ver herramienta

Modelo unificado de visión-lenguaje desarrollado por WeChat Vision, Tencent Inc. Integra la percepción a nivel de objeto y a nivel de píxel para tareas como la…WeVisOne-VL es un modelo unificado de visión-lenguaje desarrollado por WeChat Vision, Tencent Inc. Integra la percepción a nivel de objeto y a nivel de píxel para tareas como la…

Herramientas de visión artificial
Ver el Top 50 de LLM

Qwen2-VL-7B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…

Herramientas de visión artificial
Ver herramienta

Modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…Qwen2-VL-7B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…

Herramientas de visión artificial
Ver el Top 5 de Modelos de IA

Qwen-VL

Repositorios de IA en GitHub

Qwen-VL es un modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…Qwen-VL es un modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub

Qwen2-VL-72B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…

Modelos de IA y LLM
Ver herramienta

Modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…Qwen2-VL-72B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Ultralytics YOLO

Repositorios de IA en GitHub

Ultralytics YOLO incluye YOLO26, YOLO11 y YOLOv8, proporcionando capacidades para detección de objetos, segmentación de instancias, segmentación semántica, clasificación de…

Herramientas de visión artificial

N.º 19 en Repositorios de IA en GitHub

Ver herramienta

Repositorios de IA en GitHub

Ultralytics YOLO incluye YOLO26, YOLO11 y YOLOv8, proporcionando capacidades para detección de objetos, segmentación de instancias, segmentación semántica, clasificación de…

DestacadaHerramientas de visión artificial
N.º 19 en Repositorios de IA en GitHub

CLIP ViT-B/32

Modelos de IA

El modelo clip-vit-base-patch32 de OpenAI está diseñado para tareas de clasificación de imágenes en cero disparos. Utiliza una arquitectura de Vision Transformer para mejorar la…

Herramientas de visión artificial
Ver herramienta

Modelos de IA

El modelo clip-vit-base-patch32 de OpenAI está diseñado para tareas de clasificación de imágenes en cero disparos. Utiliza una arquitectura de Vision Transformer para mejorar la…

DestacadaHerramientas de visión artificial
Ver el Top 5 de Modelos de IA

Ultralytics

Apps de IA

Una plataforma de visión por computadora de extremo a extremo para anotar datos, entrenar modelos YOLO y desplegarlos globalmente, construida en torno al ampliamente adoptado…

Herramientas de visión artificialFabricación e industria

N.º 5 en Fabricación e industria

Ver herramienta

Apps de IA

Una plataforma de visión por computadora de extremo a extremo para anotar datos, entrenar modelos YOLO y desplegarlos globalmente, construida en torno al ampliamente adoptado…

DestacadaHerramientas de visión artificialFabricación e industria
N.º 5 en Fabricación e industria
1 de 8