Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

WeVisOne-VL

WeVisOne-VL es un modelo unificado de visión-lenguaje desarrollado por WeChat Vision, Tencent Inc. Integra la percepción a nivel de objeto y a nivel de píxel para tareas como la detección de objetos y el enmascaramiento de imágenes, diseñado para fines de investigación.

Visitar URL
Compartir
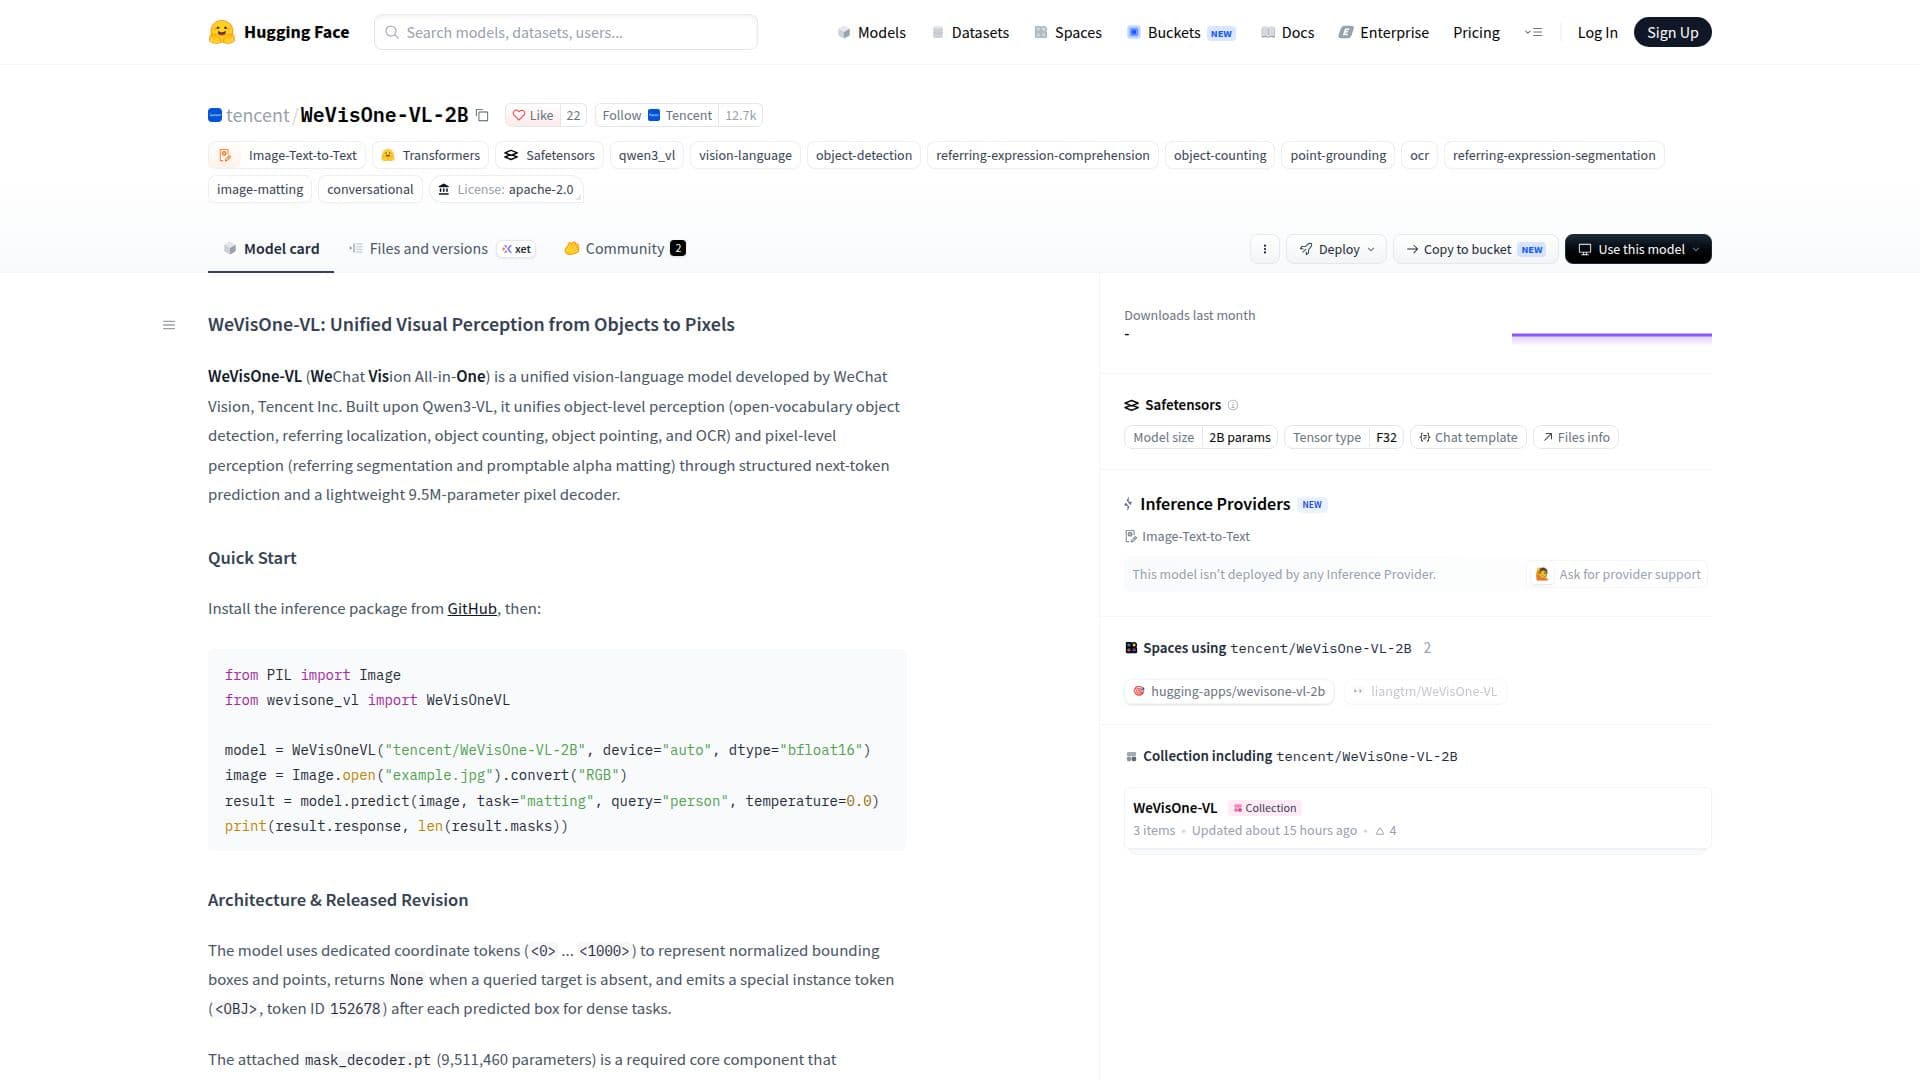
Captura de pantalla de WeVisOne-VL

WeVisOne-VL es un sofisticado modelo de visión-lenguaje desarrollado por WeChat Vision, una división de Tencent Inc. Este modelo se basa en el marco Qwen3-VL y está diseñado para unificar tareas de percepción a nivel de objeto y a nivel de píxel. Es capaz de manejar la detección de objetos con vocabulario abierto, localización referida, conteo de objetos, señalización de objetos y reconocimiento óptico de caracteres (OCR).

Leer más

Además, admite tareas a nivel de píxel como la segmentación referida y el enmascaramiento alfa programable.

El modelo emplea una predicción estructurada del siguiente token y cuenta con un decodificador de píxeles ligero con 9.5 millones de parámetros. Un componente clave de WeVisOne-VL es el mask_decoder.pt, que integra un Adaptador de Características Visuales, un Decodificador de Consultas Guiadas por Caja y una Cabeza de Predicción Densa Condicionada por Instancia. Estos componentes trabajan juntos para refinar las predicciones y generar máscaras alfa de alta resolución.

WeVisOne-VL está destinado a aplicaciones de investigación en anclaje visual, localización, señalización, conteo, OCR, segmentación y enmascaramiento de imágenes. No está diseñado para la toma de decisiones autónomas o identificación individual. El modelo está optimizado para la percepción de imágenes en una sola interacción y no admite cuadrículas de video.

El modelo se publica bajo la Licencia Apache 2.0, con componentes de terceros que mantienen sus licencias originales. Se alienta a los usuarios a revisar los archivos fuente para obtener detalles específicos sobre la licencia.

  • CategoríaHerramientas de visión artificial
  • Modelo de preciosCódigo abierto
  • ImplementaciónNube
  • PlataformasWeb

  • Modelo unificado de visión-lenguaje

  • Percepción a nivel de objeto

  • Percepción a nivel de píxel

  • Detección de objetos con vocabulario abierto

  • Segmentación referida

  • Enmascaramiento alfa programable

  • Predicción estructurada del siguiente token

  • Decodificador de píxeles ligero

  1. Acceder a la página del modelo: Visita la página del modelo en Hugging Face

  2. Autenticarse: Inicia sesión en tu cuenta de Hugging Face

  3. Configurar: Configura el modelo con los parámetros necesarios

  4. Enviar solicitudes: Introduce tus datos visuales para su procesamiento

  5. Ajustar: Modifica la configuración del modelo para tareas específicas

  • Anclaje Visual
  • Detección de Objetos
  • Enmascaramiento de Imágenes
  • Localización OCR
  • Segmentación Referida

Herramientas de IA populares como WeVisOne-VL

Qwen2-VL-7B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…

Herramientas de visión artificial
Ver herramienta

Modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…Qwen2-VL-7B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual y el soporte multilingüe. Destaca en el procesamiento de imágenes y videos, ofreciendo un…

Herramientas de visión artificial
Ver el Top 5 de Modelos de IA

CLIP ViT-B/32

Modelos de IA

El modelo clip-vit-base-patch32 de OpenAI está diseñado para tareas de clasificación de imágenes en cero disparos. Utiliza una arquitectura de Vision Transformer para mejorar la…

Herramientas de visión artificial
Ver herramienta

Modelos de IA

El modelo clip-vit-base-patch32 de OpenAI está diseñado para tareas de clasificación de imágenes en cero disparos. Utiliza una arquitectura de Vision Transformer para mejorar la…

DestacadaHerramientas de visión artificial
Ver el Top 5 de Modelos de IA

Modelo Florence-2

Modelos de IA

Florence-2 es un modelo de fundación de visión avanzada de Microsoft, diseñado para manejar una variedad de tareas de visión y visión-lenguaje. Utiliza un enfoque basado en…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Florence-2 es un modelo de fundación de visión avanzada de Microsoft, diseñado para manejar una variedad de tareas de visión y visión-lenguaje. Utiliza un enfoque basado en…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Qwen-VL

Repositorios de IA en GitHub

Qwen-VL es un modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…Qwen-VL es un modelo de lenguaje visual grande desarrollado por Alibaba Cloud. Ofrece capacidades avanzadas para tareas de chat y visión, proporcionando una plataforma robusta…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub

Ultralytics YOLO

Repositorios de IA en GitHub

Ultralytics YOLO incluye YOLO26, YOLO11 y YOLOv8, proporcionando capacidades para detección de objetos, segmentación de instancias, segmentación semántica, clasificación de…

Herramientas de visión artificial

N.º 18 en Repositorios de IA en GitHub

Ver herramienta

Repositorios de IA en GitHub

Ultralytics YOLO incluye YOLO26, YOLO11 y YOLOv8, proporcionando capacidades para detección de objetos, segmentación de instancias, segmentación semántica, clasificación de…

DestacadaHerramientas de visión artificial
N.º 18 en Repositorios de IA en GitHub

Qwen2-VL-72B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…

Modelos de IA y LLM
Ver herramienta

Modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…Qwen2-VL-72B-Instruct es un modelo de IA avanzado diseñado para la comprensión visual de vanguardia y el soporte multilingüe. Destaca en el procesamiento de imágenes, videos y…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Ultralytics

Apps de IA

Una plataforma de visión por computadora de extremo a extremo para anotar datos, entrenar modelos YOLO y desplegarlos globalmente, construida en torno al ampliamente adoptado…

Herramientas de visión artificialFabricación e industria

N.º 6 en Fabricación e industria

Ver herramienta

Apps de IA

Una plataforma de visión por computadora de extremo a extremo para anotar datos, entrenar modelos YOLO y desplegarlos globalmente, construida en torno al ampliamente adoptado…

DestacadaHerramientas de visión artificialFabricación e industria
N.º 6 en Fabricación e industria
1 de 8