Descripción
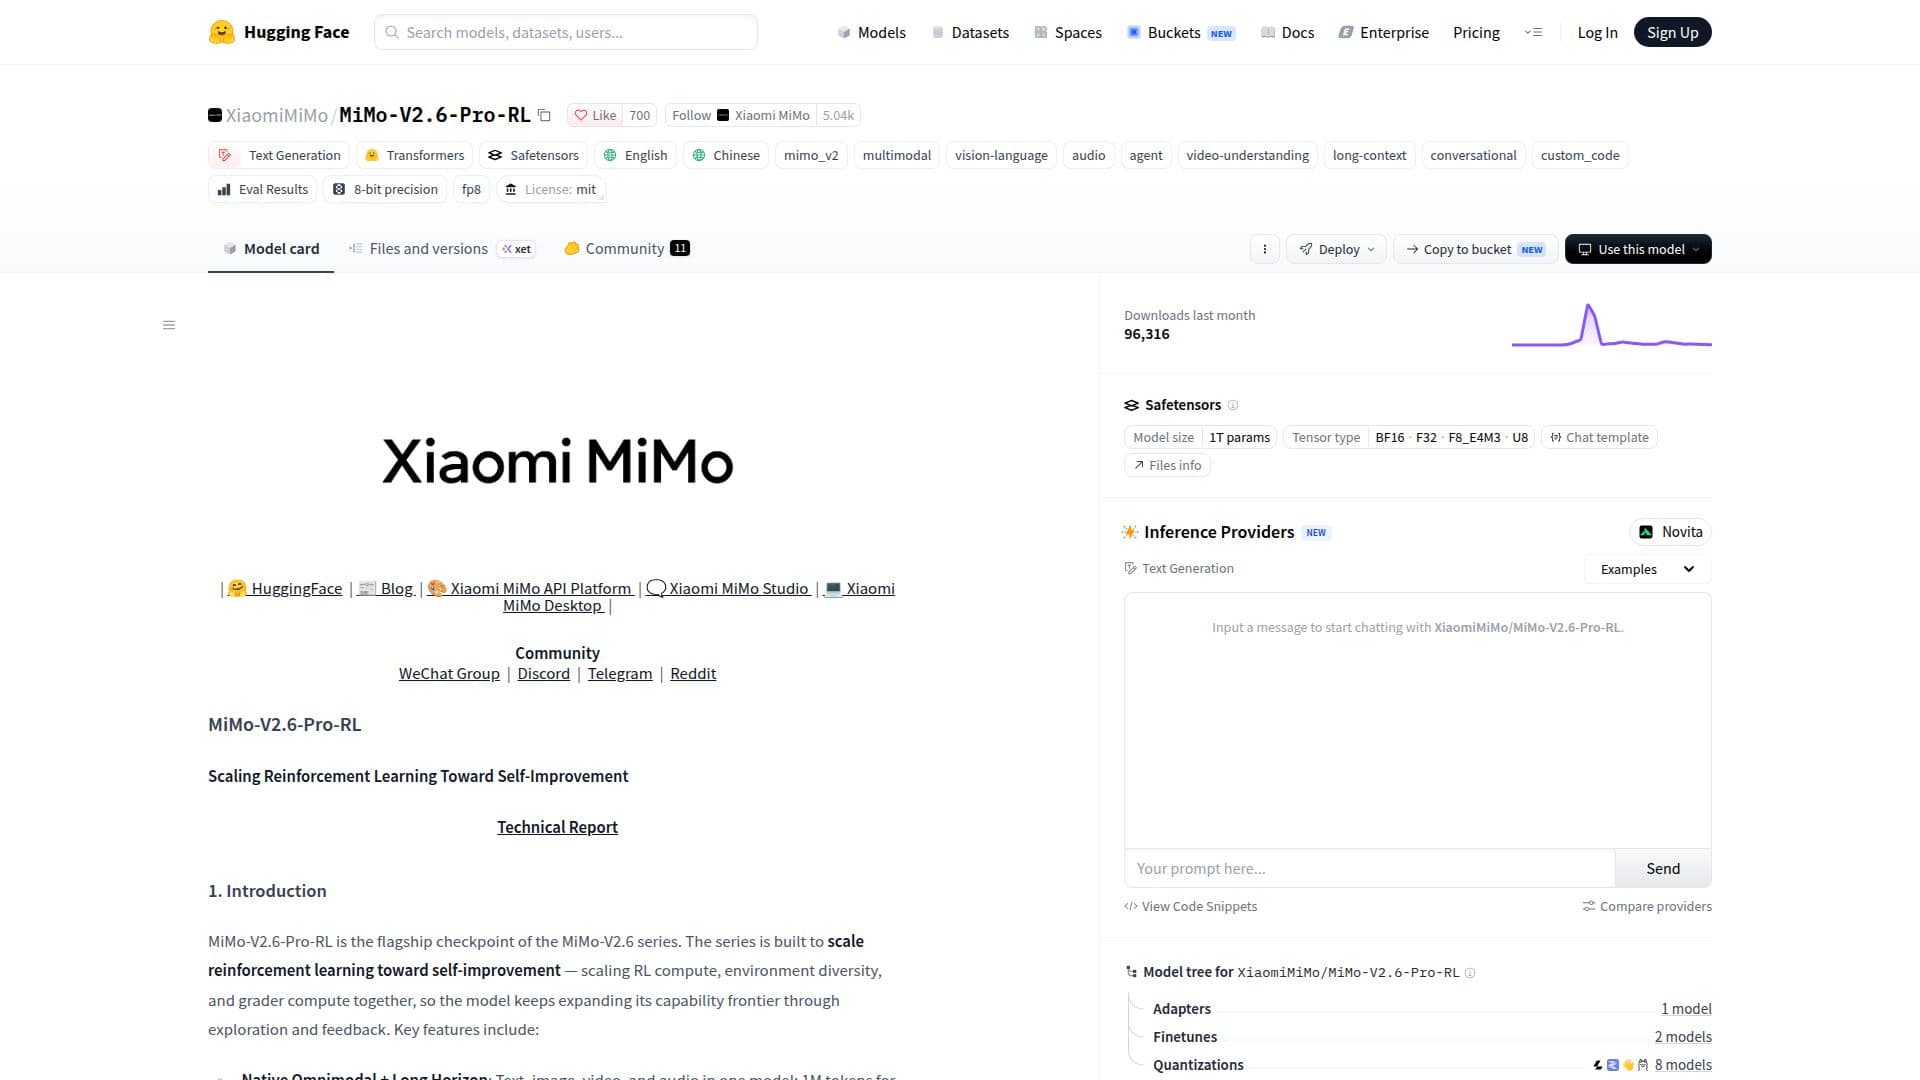
MiMo-V2.6-Pro-RL es el modelo líder en la serie MiMo, desarrollado para avanzar el aprendizaje por refuerzo hacia la auto-mejora. Este modelo está construido para escalar el cálculo de RL, la diversidad del entorno y el cálculo del evaluador juntos, permitiéndole expandir sus capacidades a través de la exploración y la retroalimentación.
Leer más
Las características clave incluyen un enfoque omnimodal nativo, integrando texto, imagen, video y audio en un solo modelo, y una longitud de contexto larga de 1 millón de tokens para manejar repositorios extensos y ejecuciones de agentes en múltiples sesiones.
El modelo emplea una estrategia única de 'You Only RL Once', combinando tareas y aprovechamientos en un solo lote para reforzar capacidades y transferir estrategias entre dominios. Utiliza una Optimización de Política Relativa de Grupo (GRPO) completamente asíncrona en grandes lotes, procesando miles de millones de tokens por actualización. El sistema de Calificación Agente Grupal mejora el ciclo de auto-mejora al clasificar soluciones y dirigir hacia caminos eficientes.
MiMo-V2.6-Pro-RL también cuenta con Destilación On-Policy Multi-Prefijo Multi-Maestro (MOPD2), que combina despliegues autónomos de estudiantes con despliegues condicionados por prefijos, extendiendo capacidades a tareas complejas. La arquitectura del modelo incluye una Mezcla Escasa de Expertos con 1.02 billones de parámetros totales y un codificador de visión con 681 millones de parámetros.
Este modelo está disponible para implementación a través de varias plataformas, incluyendo AI Studio, MiMo Code y Xiaomi MiMo Desktop. Soporta implementación en Docker para un rendimiento óptimo y es accesible a través de la API de la Plataforma Abierta Xiaomi MiMo y OpenRouter.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de MiMo-V2.6-Pro-RL
Integración Omnimodal Nativa
Longitud de Contexto de 1M Tokens
Estrategia You Only RL Once
Optimización de Política Relativa de Grupo
Calificación Agente Grupal
Destilación Multi-Prefijo Multi-Maestro
Arquitectura de Mezcla Escasa de Expertos
Disponible en Múltiples Plataformas
Primeros pasos con MiMo-V2.6-Pro-RL
Acceder a la página del modelo: Visita la página oficial de Hugging Face para MiMo-V2.6-Pro-RL.
Autenticarse: Asegúrate de tener las credenciales necesarias para acceder al modelo.
Configurar: Establece los parámetros del modelo de acuerdo a tus requisitos.
Enviar solicitudes: Introduce tus datos para interactuar con el modelo y recibir salidas.
Casos de uso de MiMo-V2.6-Pro-RL
- Procesamiento Multimodal
- Aprendizaje por Refuerzo
- Manejo de Datos a Gran Escala
- Transferencia de Estrategias entre Dominios
- Sistemas de Calificación Avanzados