Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

Mage-VL

LLM#20Modelos de IA y LLMCódigo abierto · Web

Mage-VL es un modelo de base multimodal nativo de códec y de transmisión proactiva diseñado para una comprensión eficiente de imágenes y videos. Aprovecha un codificador visual único y un decodificador causal para mejorar la percepción de transmisión en tiempo real mientras reduce las demandas computacionales.

Visitar URL
Compartir
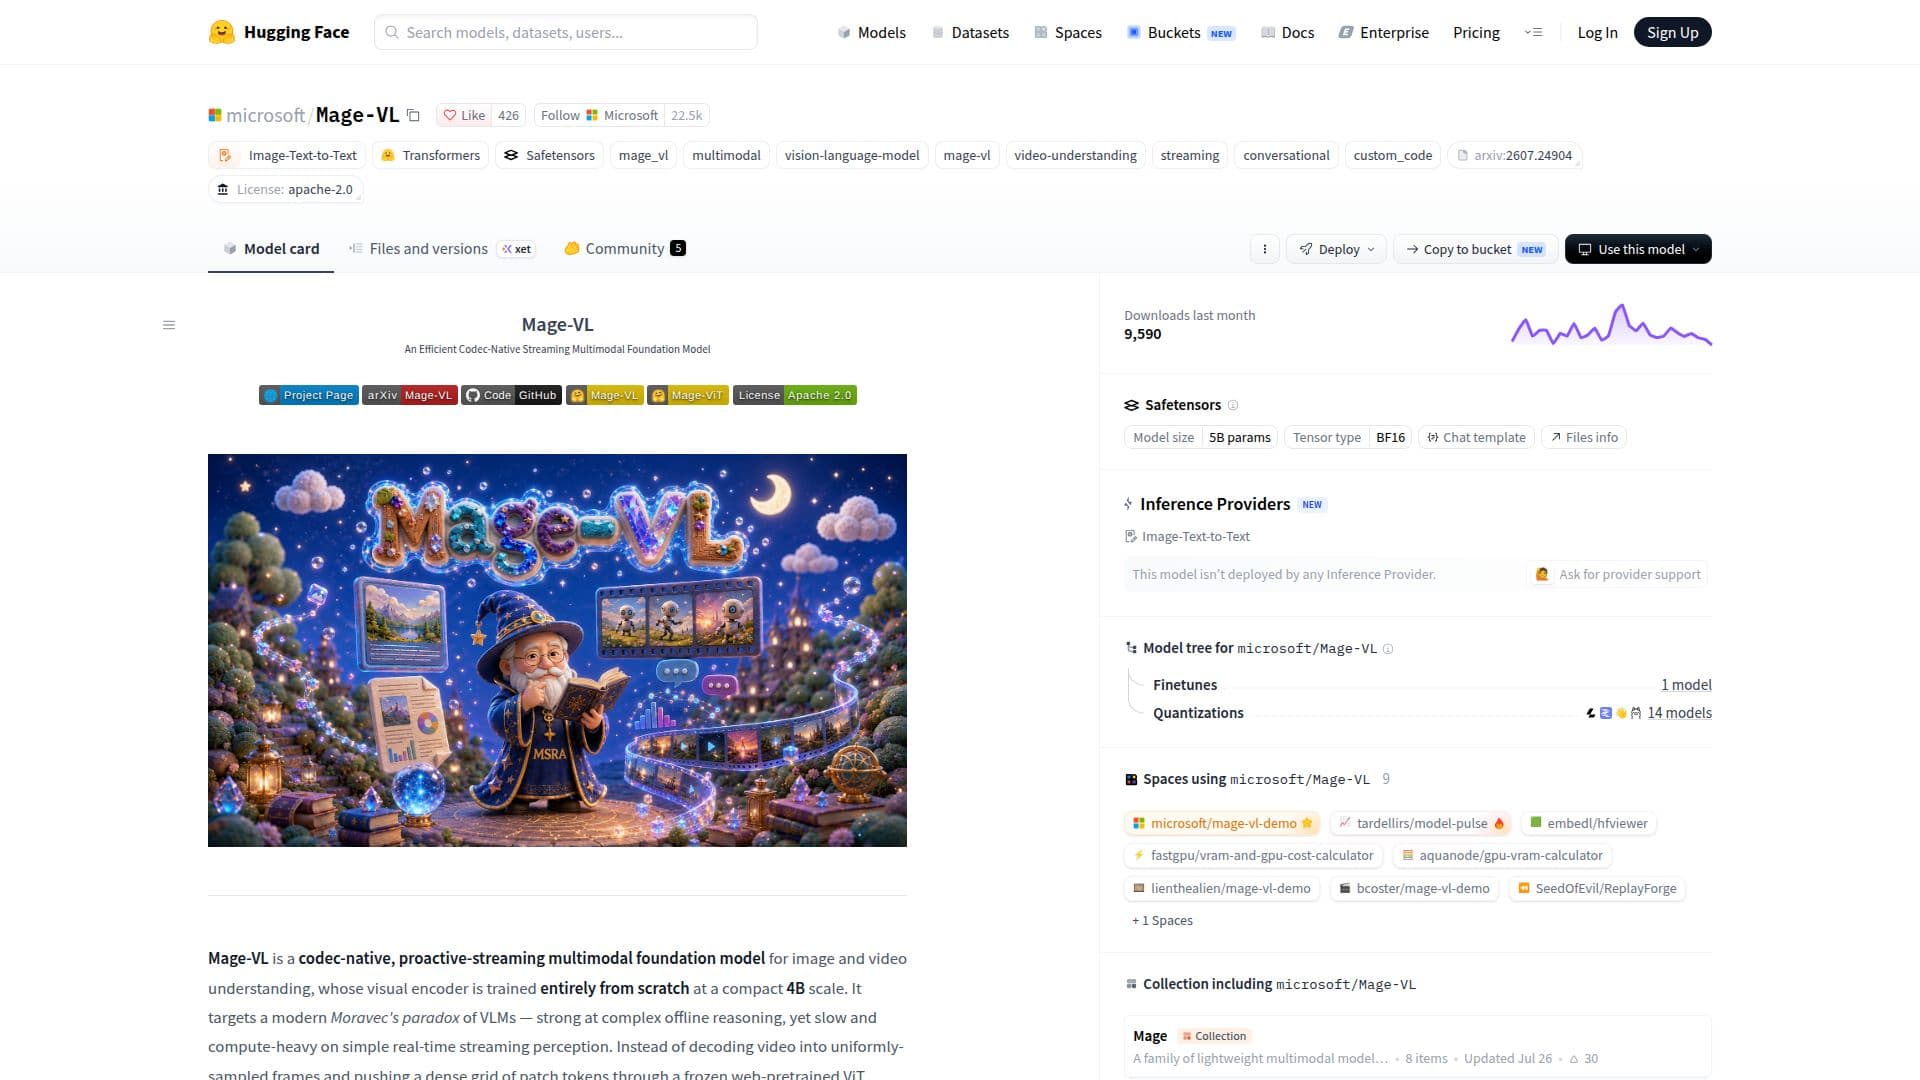
Captura de pantalla de Mage-VL

Mage-VL es un modelo de base multimodal innovador desarrollado para abordar los desafíos de la comprensión de imágenes y videos. Está diseñado como un modelo nativo de códec y de transmisión proactiva que procesa datos visuales de manera eficiente. El codificador visual del modelo, Mage-ViT, se entrena desde cero y opera a una escala compacta de 4B. Este codificador es único en su capacidad para asignar tokens en función de la importancia espaciotemporal derivada del códec, lo que le permite procesar videos hasta ocho veces más largos bajo el mismo presupuesto computacional.

Leer más

La arquitectura de Mage-VL incluye un decodificador causal Qwen3-4B, que es el único componente preentrenado. Este decodificador trabaja en conjunto con Mage-ViT para manejar flujos de tokens de longitud variable, apoyando una interfaz unificada para imágenes y videos de diferentes longitudes. El diseño de doble proceso del modelo incorpora una puerta de cognición que permite la transmisión proactiva al monitorear el contenido y activar el modelo completo de lenguaje visual solo cuando es necesario.

El enfoque nativo de códec del modelo reduce significativamente el consumo de tokens visuales en más del 75%, lo que resulta en una aceleración de 3.5× en la inferencia en tiempo real en comparación con métodos tradicionales. Esta eficiencia se logra sin comprometer la precisión, lo que convierte a Mage-VL en una herramienta poderosa para el análisis y la comprensión de videos en tiempo real.

Mage-VL es particularmente fuerte en la comprensión de videos e inteligencia espacial, superando a modelos comparables en varios benchmarks. Sus capacidades de transmisión proactiva se demuestran a través de su rendimiento en tareas de transmisión de SoccerNet, donde ofrece comentarios de eventos con baja latencia.

En general, Mage-VL representa un avance significativo en los modelos de IA multimodal, ofreciendo una solución eficiente en datos para tareas visuales complejas. Su naturaleza de código abierto y sus capacidades integrales lo convierten en un recurso valioso para desarrolladores e investigadores en el campo de la inteligencia artificial.

  • CategoríaModelos de IA y LLM
  • Modelo de preciosCódigo abierto
  • ImplementaciónNube
  • PlataformasWeb

  • Codificador visual nativo de códec

  • Puerta de transmisión proactiva

  • Decodificador causal Qwen3-4B

  • Aceleración de inferencia de 3.5×

  • Tokenizador eficiente en datos

  • Preentrenamiento de resolución variable

  • Modelo unificado para imágenes y videos

  • Comentarios basados en eventos

  1. Acceder a la página del modelo: Visita el repositorio de Hugging Face

  2. Autenticarse: Usa las credenciales de tu cuenta de Hugging Face

  3. Configurar: Establece los parámetros y el entorno del modelo

  4. Enviar solicitudes: Ingresa tus datos de imagen o video para su procesamiento

  5. Ajustar: Modifica la configuración del modelo para tareas específicas

  • Análisis de Video en Tiempo Real
  • Inteligencia Espacial
  • Comentarios Basados en Eventos
  • Comprensión de Imágenes
  • Transmisión Proactiva

Herramientas de IA populares como Mage-VL

Modelo Qwen3.5-4B

Modelos de IA

Qwen3.5-4B es un modelo de lenguaje causal con un codificador de visión, diseñado para un aprendizaje multimodal de alto rendimiento. Soporta 201 idiomas y ofrece una arquitectura…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Qwen3.5-4B es un modelo de lenguaje causal con un codificador de visión, diseñado para un aprendizaje multimodal de alto rendimiento. Soporta 201 idiomas y ofrece una arquitectura…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

DeepSeek-V4-Flash-Vision-Exp es un modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…

Modelos de IA y LLM
Ver herramienta

Modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…DeepSeek-V4-Flash-Vision-Exp es un modelo multimodal experimental de la familia DeepSeek-V4, que mejora las capacidades de comprensión visual. Se basa en la arquitectura…

Modelos de IA y LLM
Ver el Top 50 de LLM

Modelo de IA avanzado que sobresale en tareas de codificación y agente. Cuenta con una ventana de contexto de 1M y comprensión multimodal nativa, impulsada por la…MiniMax M3 es un modelo de IA avanzado que sobresale en tareas de codificación y agente. Cuenta con una ventana de contexto de 1M y comprensión multimodal nativa, impulsada por la…

Modelos de IA y LLM
N.º 48 en LLM

Ideogram 4

Modelos de IA

Ideogram 4 es un modelo de vanguardia de texto a imagen que ofrece un control sin precedentes sobre la composición, el estilo y el diseño de la imagen. Soporta resolución nativa…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Modelo de vanguardia de texto a imagen que ofrece un control sin precedentes sobre la composición, el estilo y el diseño de la imagen. Soporta resolución nativa…Ideogram 4 es un modelo de vanguardia de texto a imagen que ofrece un control sin precedentes sobre la composición, el estilo y el diseño de la imagen. Soporta resolución nativa…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Modelo avanzado de comprensión de video diseñado para funcionar de manera eficiente en varios dispositivos. Ofrece capacidades mejoradas de análisis de video y…SmolVLM2 es un modelo avanzado de comprensión de video diseñado para funcionar de manera eficiente en varios dispositivos. Ofrece capacidades mejoradas de análisis de video y…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

Pixtral-12B-2409 es un modelo de IA multimodal con 12 mil millones de parámetros y un codificador de visión de 400 millones de parámetros, diseñado para tareas avanzadas de…

Modelos de IA y LLM
Ver herramienta

Pixtral-12B-2409 es un modelo de IA multimodal con 12 mil millones de parámetros y un codificador de visión de 400 millones de parámetros, diseñado para tareas avanzadas de…

Modelos de IA y LLM
Ver el Top 5 de Modelos de IA

V-JEPA

Repositorios de IA en GitHub

V-JEPA es una implementación en PyTorch para el aprendizaje autosupervisado a partir de video. Utiliza una arquitectura predictiva de incrustación conjunta (joint-embedding…

Modelos de IA y LLM
Ver herramienta

Repositorios de IA en GitHub

Implementación en PyTorch para el aprendizaje autosupervisado a partir de video. Utiliza una arquitectura predictiva de incrustación conjunta (joint-embedding…V-JEPA es una implementación en PyTorch para el aprendizaje autosupervisado a partir de video. Utiliza una arquitectura predictiva de incrustación conjunta (joint-embedding…

Modelos de IA y LLM
Ver el Top 250 de Repositorios de IA en GitHub

LTX-2

Modelos de IA

LTX-2 es un modelo de base audio-video basado en DiT diseñado para generar video y audio sincronizados. Combina técnicas modernas de generación de video con pesos abiertos, lo que…

Modelos de IA y LLM
Ver herramienta

Modelos de IA

Modelo de base audio-video basado en DiT diseñado para generar video y audio sincronizados. Combina técnicas modernas de generación de video con pesos abiertos, lo que…LTX-2 es un modelo de base audio-video basado en DiT diseñado para generar video y audio sincronizados. Combina técnicas modernas de generación de video con pesos abiertos, lo que…

DestacadaModelos de IA y LLM
Ver el Top 5 de Modelos de IA
1 de 8