

Las demandas de copyright contra la IA siguen sin resolverse en su mayoría en 2026, pero el mapa está más claro que hace un año. Anthropic pagó $1.5 billion para llegar a un acuerdo con los autores, las discográficas están firmando acuerdos de licencia con Suno y Udio, y el mayor caso del sector de la prensa, The New York Times contra OpenAI y Microsoft, está en fase de juicio sumario. Ningún tribunal de EE. UU. ha dictaminado que entrenar un modelo de IA con obras protegidas sea siempre legal, y ninguno ha dictaminado que sea siempre ilegal.
Un rastreador independiente contabiliza 148 demandas de copyright en EE. UU. contra empresas de IA (ChatGPT Is Eating the World). No necesitas conocerlas todas. Esta guía cubre los casos que mueven el derecho, en qué punto está cada uno ahora mismo y qué implica si usas ChatGPT, Claude o Midjourney para trabajo real. Todo lo que se describe abajo como reclamación es una alegación: los tribunales no han resuelto la mayoría.
Esto es un informe de situación, no asesoramiento jurídico. Está elaborado a partir de la cobertura de los tribunales, de rastreadores y de los propios términos de los proveedores, y parte de ello quedará desfasado pronto. Si hay dinero de verdad en juego, consulta a un abogado.
En resumen: quién está ganando los casos de copyright de IA
Nadie está ganando con claridad. Así encajan las piezas.
Los acuerdos y las licencias se acumulan más rápido que las sentencias, lo que sugiere que ambas partes prefieren comprar certeza antes que arriesgarse a un fallo. El único tribunal de apelación que se ha pronunciado hasta ahora, en el caso Ross, falló contra la empresa de IA, pero se trataba de una herramienta no generativa. Los tribunales de Alemania interpretan la misma cuestión con más rigor que los de EE. UU. Y en la pregunta que más interesa a los usuarios, quién es dueño de lo que crea la IA, la respuesta en EE. UU. es estable: tiene que haber un humano que aporte la expresión.
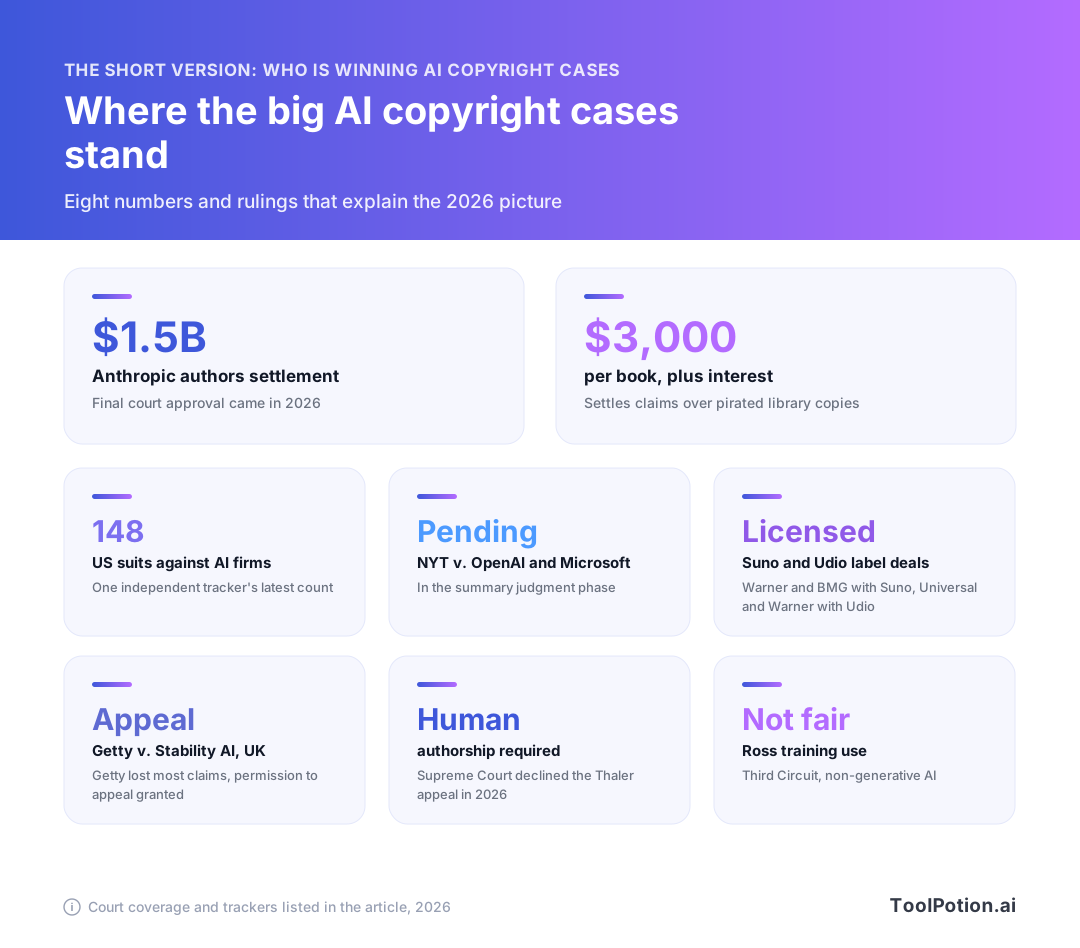
El gráfico de arriba es todo el artículo en ocho recuadros. El resto explica lo que hay detrás de cada uno.
Cómo hemos llegado hasta aquí, en cuatro años
La primera oleada llegó en 2023. Los artistas demandaron a Stability AI, Midjourney y DeviantArt, Getty demandó a Stability AI en el Reino Unido y The New York Times demandó a OpenAI y Microsoft a finales de año. Las discográficas siguieron en 2024 con demandas contra Suno y Udio. En 2025 llegaron las primeras sentencias de verdad y los estudios se sumaron: Disney y Universal demandaron a Midjourney, y después lo hizo también Warner Bros. Discovery.
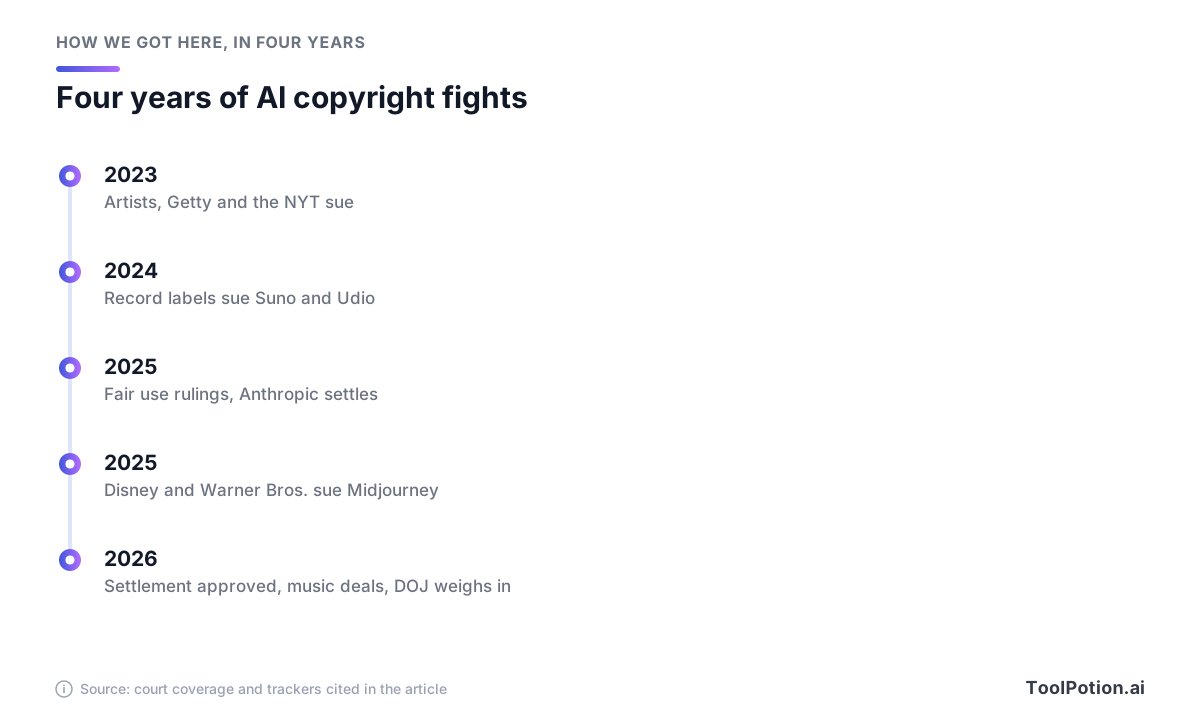
Lo que cambió en 2026 es que los casos pendientes empezaron a madurar. Un gran acuerdo recibió la aprobación final, los tribunales de apelación empezaron a pronunciarse y el Gobierno de EE. UU. tomó partido por una de las partes. Las siguientes secciones los recorren por orden de importancia.
The New York Times v. OpenAI y Microsoft
Este es el caso al que se refiere la mayoría cuando habla de "la demanda de copyright contra la IA". El Times demandó a finales de 2023, alegando que OpenAI entrenó con sus artículos sin permiso y que ChatGPT y Copilot de Microsoft pueden reproducirlos. OpenAI sostiene que el entrenamiento es uso legítimo (fair use). Los casos de otros medios y autores se acumularon en un único procedimiento en Nueva York, y el rastreador lo describe como "ya en fase de juicio sumario" (ChatGPT Is Eating the World).
El movimiento reciente más importante vino de Washington. La administración Trump presentó un escrito ante el tribunal federal de Manhattan en apoyo de OpenAI, en el que sostiene que el entrenamiento de IA generalmente constituye un uso legítimo de material protegido. Reuters informó de que parece ser la primera vez que el Gobierno de EE. UU. se pronuncia sobre la oleada de casos de entrenamiento de IA, y apuntó que un escrito así tiene valor consultivo, no jurídico. La respuesta del Times fue que la administración se ponía del lado de las empresas de IA a costa de los creadores cuyas obras usaron (Reuters).
No lo leas como un veredicto. Un escrito del Gobierno es un argumento, no una sentencia, y las decisiones de juicio sumario pueden apelarse. USA Today ha presentado desde entonces su propia demanda contra OpenAI, que sigue las reclamaciones del Times, según el rastreador, así que la pila sigue creciendo aunque el caso principal avance hacia una decisión.
Authors v. Anthropic: el acuerdo de $1.5 billion
El caso de Anthropic es el mayor pago hasta ahora. Los autores acusaron a Anthropic de descargar libros pirateados de los sitios Library Genesis y Pirate Library Mirror mientras construía sus modelos Claude. Anthropic llegó a un acuerdo por $1.5 billion, unos $3,000 por obra más intereses, y la jueza Araceli Martinez-Olguin concedió la aprobación final en 2026, según la Authors Guild (Authors Guild). Anthropic no admitió responsabilidad.
La renuncia de derechos es limitada. Los autores renuncian a reclamar por la adquisición y copia pasadas de sus libros por parte de Anthropic. No se liberan las reclamaciones sobre los resultados de la IA ni sobre conductas futuras, ni las relativas a obras que no figuran en la lista de obras del acuerdo (misma fuente). Los editores musicales también han demandado a Anthropic por letras de canciones. Siguen siendo alegaciones.
La lección para el resto de la industria: importa de dónde proceden los datos de entrenamiento. Aquí el dinero se pagó por copias pirata de bibliotecas, no por el acto de entrenar en sí.
Thomson Reuters v. Ross y las sentencias de uso legítimo
Los dos primeros jueces de EE. UU. que se pronunciaron sobre entrenamiento de IA y uso legítimo, en 2025, dictaron fallos divergentes, señaló Reuters. El hito más reciente viene de un tribunal de apelación. Ross Intelligence, una startup ya desaparecida, entrenó una herramienta de investigación jurídica con las headnotes de Westlaw. En 2026 el Tercer Circuito confirmó que las headnotes están protegidas por copyright y que el uso de Ross no fue uso legítimo (Courthouse News).
El panel calificó el uso de Ross de "mínimamente transformador, en el mejor de los casos" y subrayó que Ross quería competir directamente con Westlaw. Es una salvedad enorme para todos los demás. Ross no era un modelo generativo, así que demandados como OpenAI argumentarán que la sentencia no les alcanza. Aun así, es la primera palabra a nivel de apelación sobre entrenamiento y uso legítimo, y fue contraria a la empresa de IA.
Música, imágenes y vídeo: licencias antes que sentencias
Suno y Udio
La música es donde los acuerdos han avanzado más rápido. Udio afirma tener acuerdos de licencia con Universal Music Group y Warner Music Group para entrenar nuevos modelos con sus catálogos, y que el acuerdo con Warner también pone fin a su litigio de copyright (Udio). Suno ha anunciado alianzas con Warner Music Group y BMG, y dice que sus modelos v6 se desarrollaron con socios de la industria como Warner, BMG y Believe. Los anuncios de Suno hablan de alianzas, no de acuerdos de resolución, así que aquí no los llamamos acuerdos extrajudiciales. No hemos podido confirmar con fuentes primarias qué discográficas, si alguna, siguen demandando a Suno, así que comprueba antes de dar por hecho que un catálogo concreto tiene licencia.
Udio y Suno parecen ahora menos demandados puros y más licenciatarios de algunas discográficas. Para ti, eso significa que la respuesta a "¿es seguro este tema para mi anuncio?" depende de qué catálogo haya alimentado un resultado concreto, algo que no puedes ver. Volvemos a ello en la sección práctica.
GEMA en Alemania
Fuera de EE. UU., un tribunal de Múnich ha sido menos amable con las empresas de IA. La sociedad de gestión alemana GEMA se impuso a OpenAI por letras de canciones en 2025. En 2026 el Tribunal Regional de Múnich falló a favor de GEMA contra Suno. Teosto, la sociedad de gestión finlandesa, resume la sentencia así: el tribunal consideró que el modelo memoriza las obras protegidas y conserva copias, por lo que tanto entrenar con ellas como reproducirlas en los resultados constituye infracción. Suno puede recurrir (Teosto).
El uso legítimo (fair use) es una doctrina estadounidense, así que los tribunales alemanes razonan de otra manera, pero quien venda en Europa debería tomar nota de la dirección.
Midjourney, Getty y Stability AI
Disney y Universal demandaron a Midjourney en 2025, y Warner Bros. Discovery se sumó después. Midjourney ha aceptado por estipulación entregar a los demandantes sus conjuntos de datos de entrenamiento de vídeo (ChatGPT Is Eating the World). Es una fase de descubrimiento (discovery), no una conclusión, pero significa que los estudios podrán mirar dentro de los datos de entrenamiento.
El caso de Getty contra Stability AI en el Reino Unido fue en sentido contrario. El juez desestimó las reclamaciones de Getty por infracción de copyright y luego le concedió permiso para apelar, algo que, según Chambers, es raro en un juez de primera instancia (Chambers). Getty también tiene un caso aparte en EE. UU. contra Stability AI, que esta guía no cubre. Si usas el modelo de pesos abiertos Stable Diffusion Web UI, la apelación en el Reino Unido es la que debes vigilar.
Este es el estado de los principales casos de un vistazo.
| Caso | Qué se alega | Situación actual |
|---|---|---|
| NYT, autores v. OpenAI y Microsoft | Entrenar con artículos y libros sin permiso | Fase de juicio sumario en Nueva York. Un escrito del Gobierno de EE. UU. respalda a OpenAI |
| Autores v. Anthropic | Entrenar con libros pirateados | Acuerdo de $1.5B, aprobación final en 2026 |
| Thomson Reuters v. Ross | Entrenar con headnotes de Westlaw | El Tercer Circuito confirmó: no es uso legítimo |
| Discográficas v. Suno | Entrenar con grabaciones sonoras | Alianzas anunciadas con Warner y BMG; situación de otras discográficas sin confirmar |
| Discográficas v. Udio | Entrenar con grabaciones sonoras | Acuerdos de licencia con Universal y Warner (según Udio) |
| Disney, Universal, Warner Bros. v. Midjourney | Entrenar con personajes y reproducirlos | En discovery; se compartirán los datos de vídeo de entrenamiento |
| Getty v. Stability AI (Reino Unido) | Entrenar con fotos, uso de marcas de agua | Reclamaciones de copyright desestimadas, permiso de apelación concedido |
Dónde está el riesgo legal cuando usas herramientas de IA
La mayoría de los casos anteriores son disputas entre titulares de derechos y empresas de IA. Tratan de cómo se construyeron los modelos. Como usuario, estás al otro extremo de la cadena, y tu exposición viene sobre todo de lo que publicas.
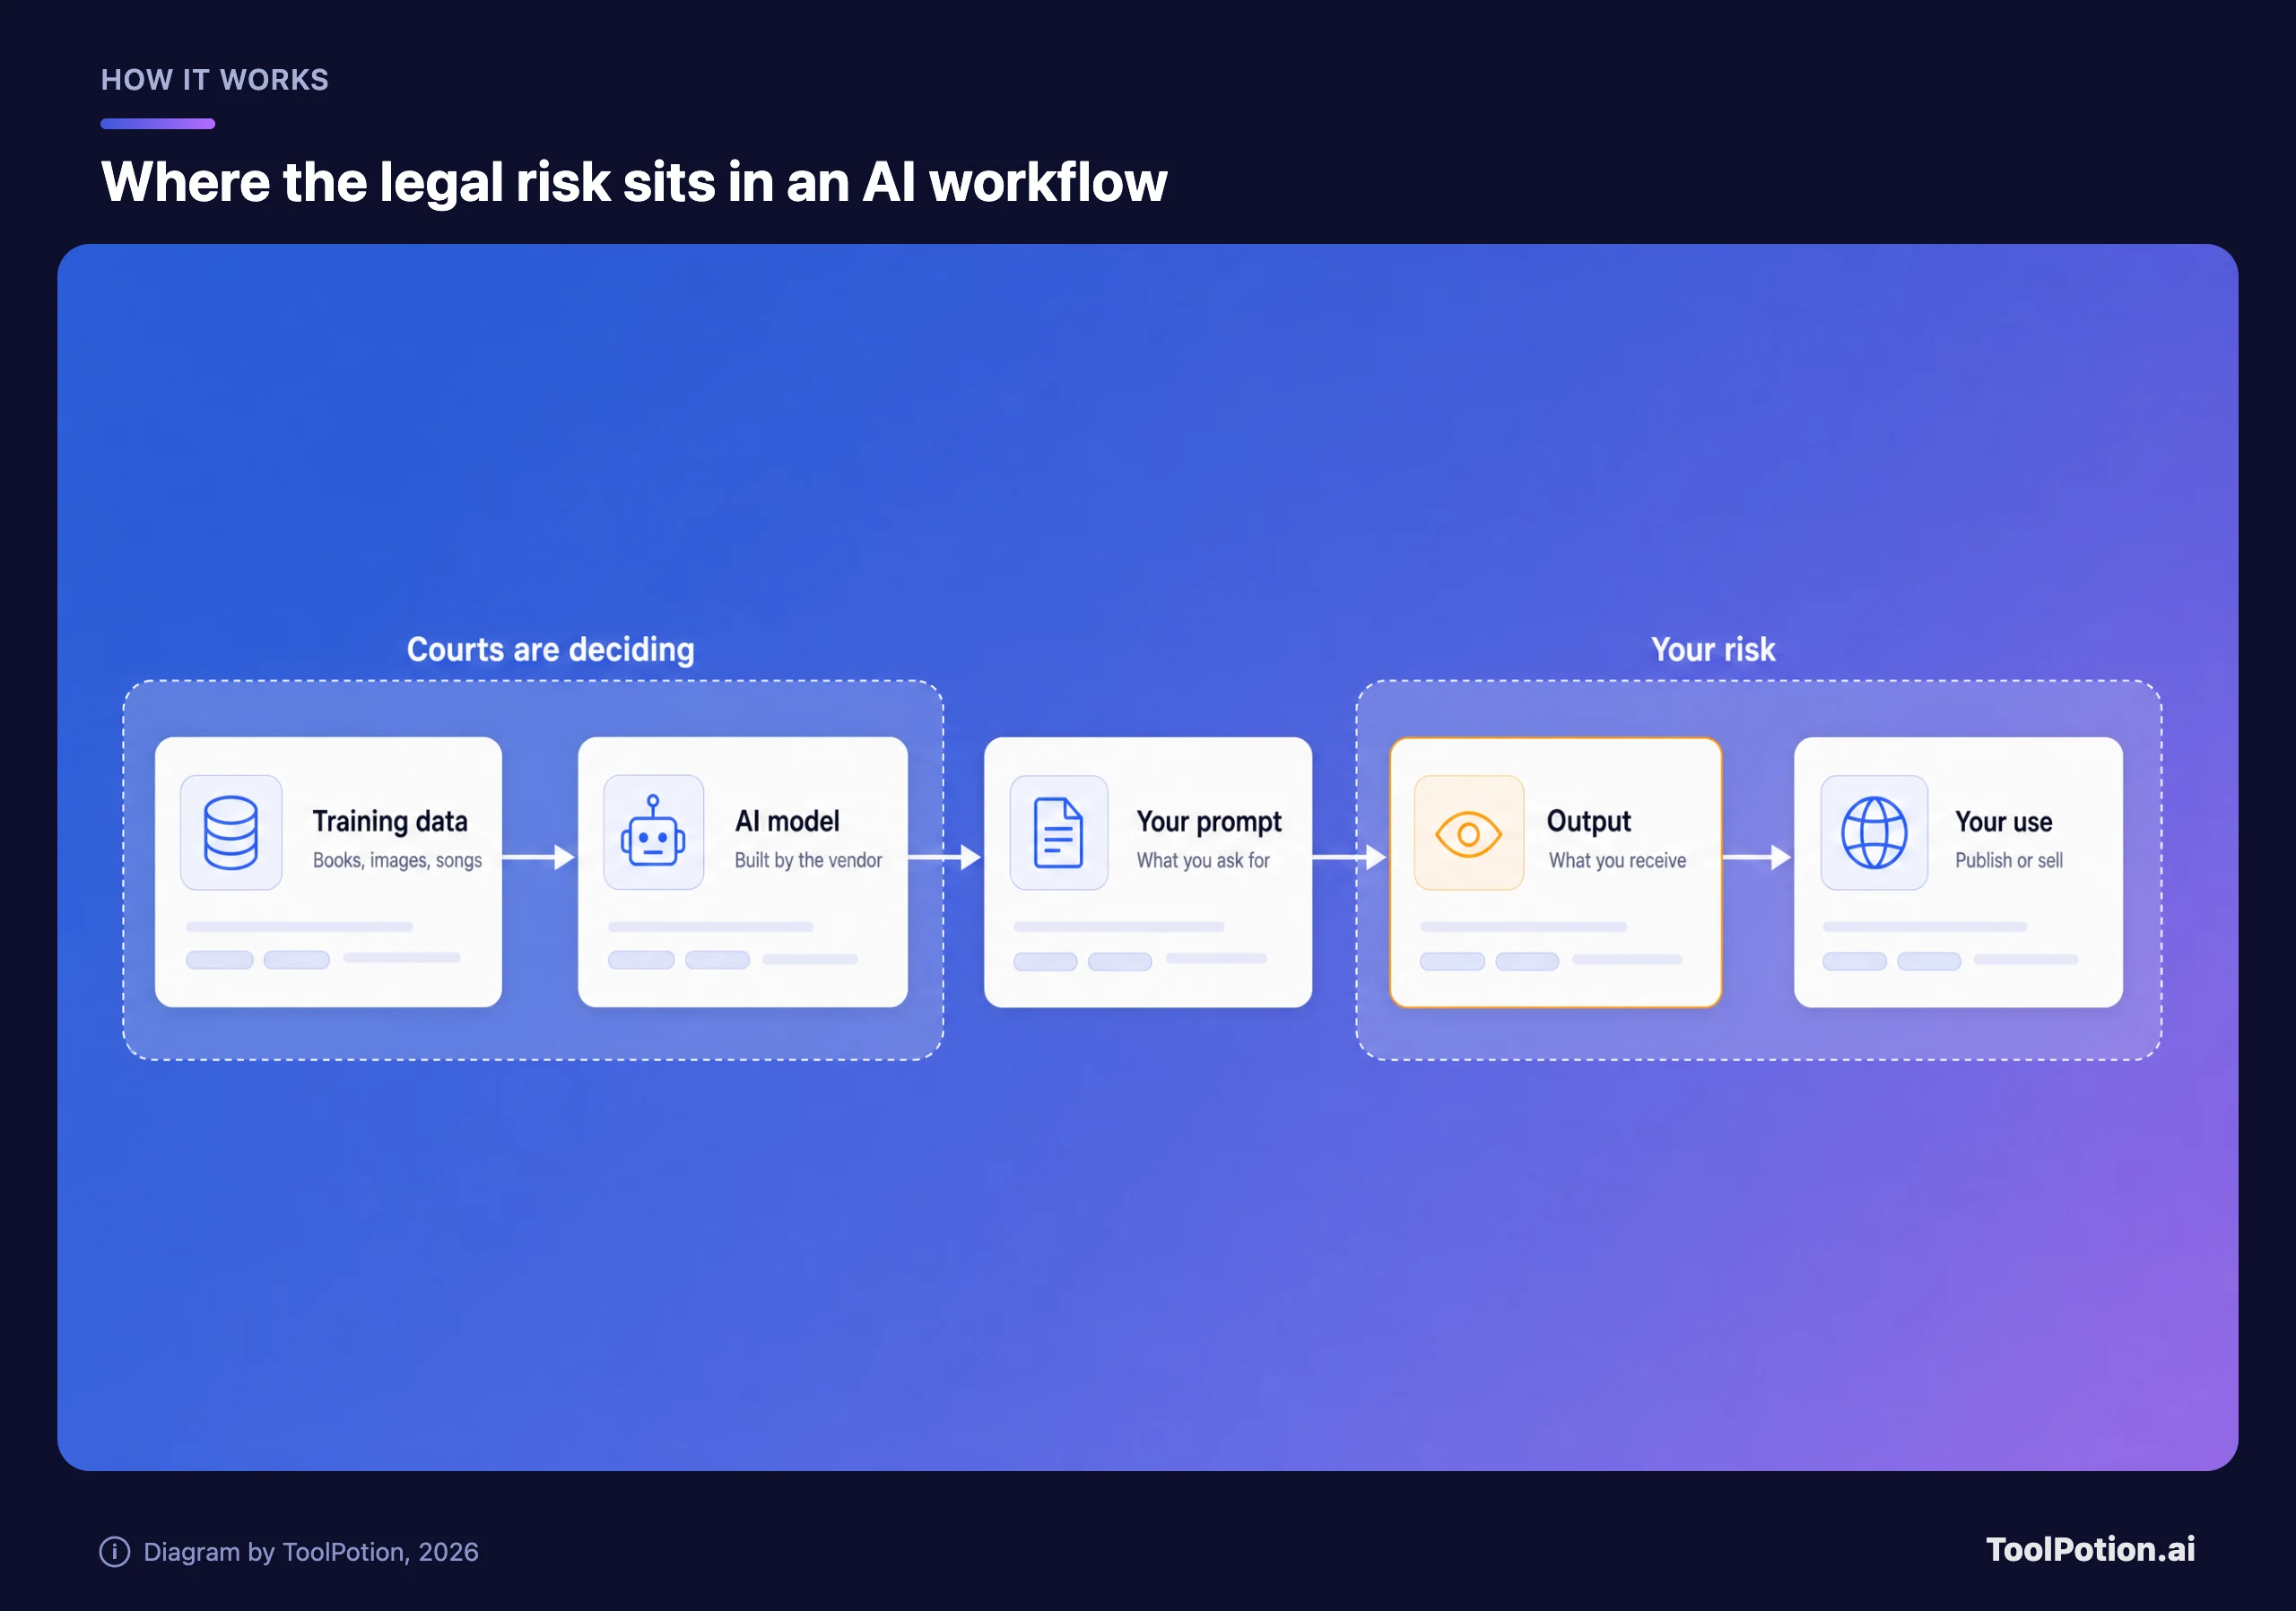
La zona de la izquierda es problema de los proveedores, al menos hasta que un tribunal diga lo contrario. La de la derecha es tuya. Las demandas que señalan a usuarios finales son raras, y las dirigidas contra empresas de IA se apoyan sobre todo en resultados que reproducen un personaje, una canción o un texto concretos, que es la parte que controlas con tus prompts y tu revisión. Una imagen de paisaje genérica o un primer borrador de un post es un riesgo muy distinto al de un tema que suena como un artista con contrato.
Qué cubren las indemnizaciones de los proveedores y qué no
Varios proveedores prometen defender a sus clientes de empresa si alguien demanda por un resultado. Son cláusulas contractuales reales, y todas vienen con condiciones. Esto dicen los documentos de cada uno.
| Proveedor | Qué dice | La trampa |
|---|---|---|
| Anthropic | Defiende a los clientes frente a reclamaciones de propiedad intelectual de terceros por el uso de pago de sus servicios o sus resultados (términos) | Excluye resultados modificados, combinaciones con otro contenido, tus entradas, el mal uso consciente y el uso de un resultado como marca en el comercio |
| Microsoft | Customer Copyright Commitment: defiende a los clientes frente a ciertas reclamaciones de propiedad intelectual sobre los resultados (Microsoft) | Los clientes de Azure OpenAI deben mantener las mitigaciones exigidas, como un metaprompt, pruebas y filtros de material protegido |
| Google Cloud | Anunciado en 2023 como indemnizaciones separadas para datos de entrenamiento y resultados generados. Google publica ahora una lista de servicios cubiertos (Google) | Cubre solo los servicios de IA generativa de la lista (la página de Google se modificó por última vez en 2026), y los términos tienen condiciones. Consulta los términos vigentes |
| OpenAI | Términos de empresa: defiende a los clientes frente a reclamaciones de que los servicios infringen derechos (términos) | Excluye combinaciones, modificaciones y contenido del cliente; además remite a una indemnización aparte específica de cada servicio |
El patrón es que la cobertura suele corresponder al uso de pago, de nivel empresarial, de Claude, Microsoft Copilot, Google Gemini, los planes de empresa de ChatGPT y GitHub Copilot. La página de Microsoft dice que las ofertas de GitHub no requieren mitigaciones adicionales desde principios de este año, mientras que su Copilot Studio no cubre los resultados de modelos externos salvo que se ejecuten en Azure OpenAI con los ajustes exigidos. Una cuenta gratuita de consumidor normalmente no está cubierta por nada de esto.
Las herramientas de imagen venden la seguridad de otra manera. Adobe Firefly presenta sus propios modelos como "comercialmente seguros", y Generative AI by Getty Images es un producto del propio titular de los derechos. Afirmaciones de marketing como estas hablan de los datos de entrenamiento. Que un contrato te proteja además es otra cuestión, así que pide el texto de la indemnización, no el marketing.
Quién es dueño de lo que crea la IA
La Oficina de Copyright de EE. UU. resolvió la cuestión de política en 2025. Su informe sobre la protección por copyright dice que los resultados de la IA solo pueden protegerse cuando un humano determina los elementos expresivos. Usar IA como herramienta no descalifica una obra, pero los prompts por sí solos no bastan (US Copyright Office).
Los tribunales coinciden. El Circuito de D.C. sostuvo que la Oficina de Copyright actuó correctamente al denegar el registro de una imagen que el sistema de IA de Stephen Thaler creó por sí solo, y el Tribunal Supremo se negó a ver su recurso en 2026 (Supreme Court docket, Chambers). Que se rechace un recurso no es un fallo sobre el fondo, pero deja en pie la decisión del tribunal inferior.
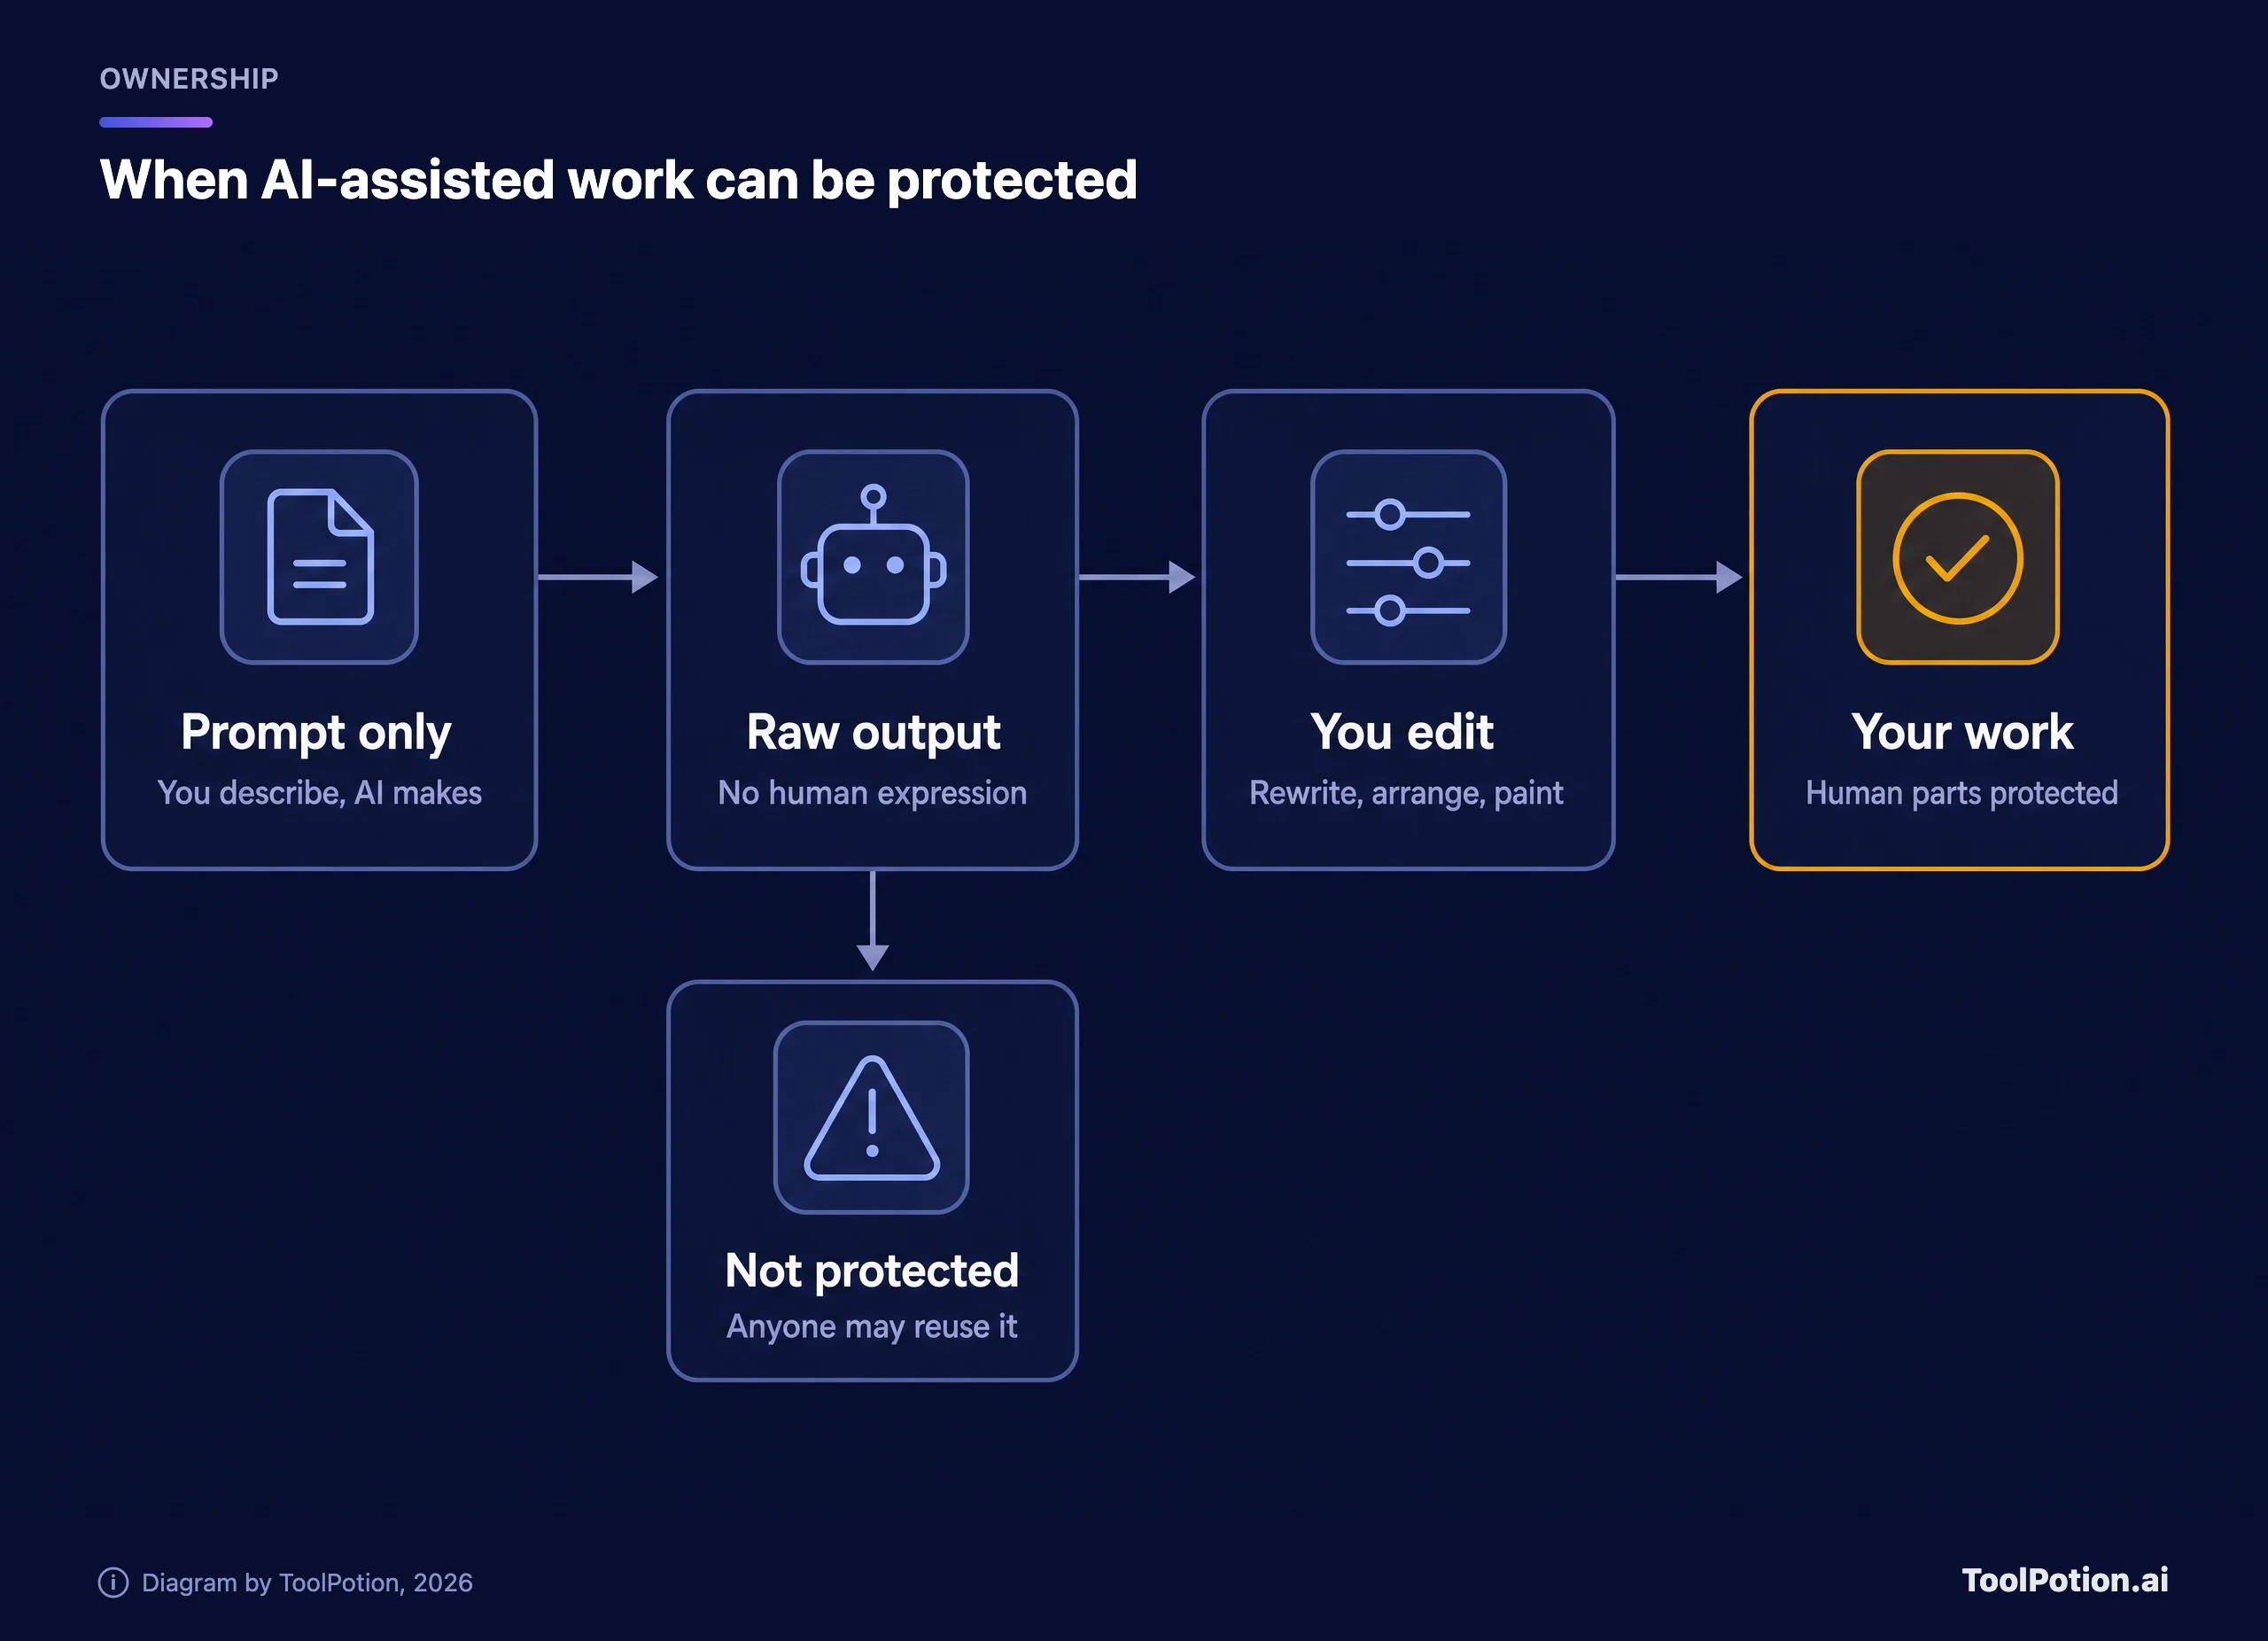
En la práctica, el resultado en bruto de un solo prompt te da algo que cualquiera puede copiar. Si reescribes el texto, pintas sobre la imagen o seleccionas y organizas muchos resultados para crear algo nuevo, puedes reivindicar tu aportación humana, no la de la máquina. Guarda los borradores y el historial de ediciones, porque esa es tu prueba si alguien te la pide.
Qué hacer hoy si usas herramientas de IA para trabajar
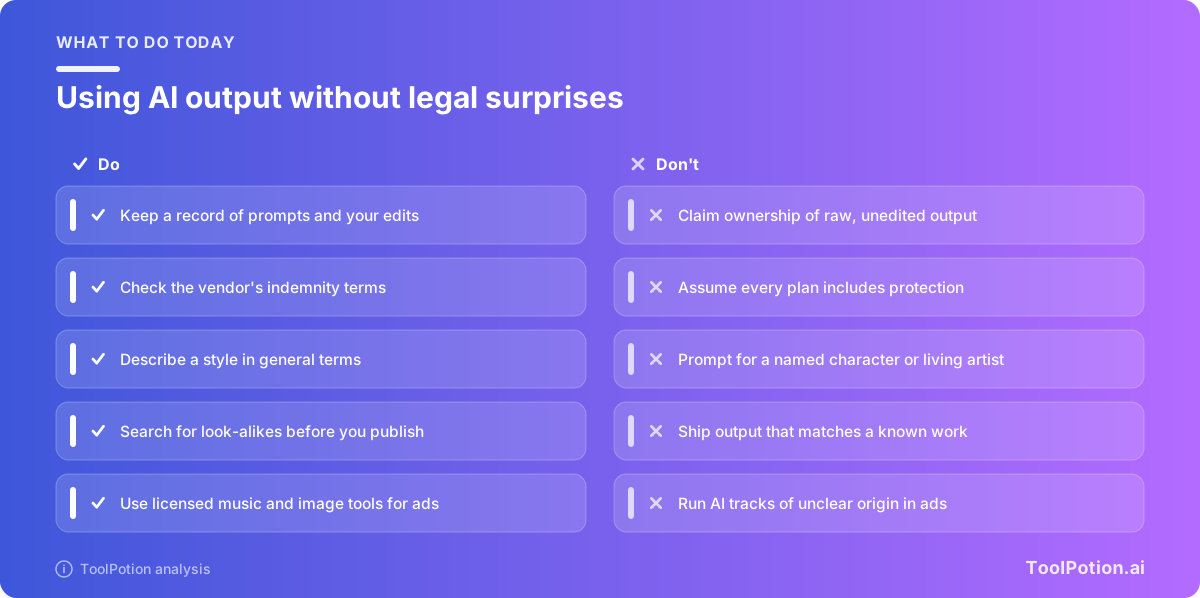
Nada de esto requiere un equipo jurídico. Casi toda la reducción de riesgo es cuestión de hábitos.
- Lee los términos de indemnización de tu proveedor y anota las exclusiones, sobre todo las de resultados editados y las de herramientas que hayas conectado tú.
- Nunca uses en un prompt un personaje, una marca o un artista vivo con nombre para nada que vaya a ser público. Ahí es donde se centran las demandas de los estudios.
- Edita lo que importa. Los cambios humanos refuerzan tu derecho a ser dueño del resultado y reducen la probabilidad de publicar algo que copie.
- Antes de una publicación amplia, haz una comprobación de parecidos: búsqueda inversa de imágenes para las fotos, una búsqueda rápida de frases distintivas para los textos y una escucha atenta para la música.
- Para campañas de pago, prefiere herramientas con datos de entrenamiento con licencia o términos comerciales claros, y guarda la página de términos en la que te basaste.
- Guarda los prompts y los borradores del trabajo importante.
Usa el árbol de abajo para situar un resultado concreto en la escala de riesgo.
Después, puntúa los hábitos de tu equipo. La lista de comprobación no te dará garantías legales, pero te muestra qué hueco arreglar primero.
Qué sigue sin resolverse
Mucho. Ningún tribunal de apelación ha decidido si entrenar un modelo generativo con libros o noticias protegidos es uso legítimo. El caso del Times podría dar la primera gran sentencia, seguida de una apelación que tardará años. El informe de la Oficina de Copyright sobre el entrenamiento está publicado en versión previa, y falta la versión final. Los tribunales del Reino Unido, Alemania y EE. UU. razonan de forma distinta, así que una herramienta puede estar bien en un mercado y expuesta en otro.
Los acuerdos también ocultan información. El acuerdo de Anthropic dio dinero a los autores, pero no produjo ninguna sentencia sobre si el entrenamiento en sí era legal. Y los acuerdos musicales hacen que algunos catálogos tengan licencia y otros no, sin ninguna etiqueta en el resultado que te diga cuál es cuál.
Si construyes productos sobre modelos de IA, o vendes contenido hecho con ellos, lo sensato es asumir que las reglas seguirán cambiando. Si quieres comparar herramientas por calidad y no por su postura legal, los rankings de ToolPotion de audio, voz y música y de editores de audio con IA son un buen punto de partida, y la guía de alternativas a ChatGPT cubre el lado de los asistentes.
Preguntas frecuentes
¿Es legal que las empresas de IA entrenen con obras protegidas?
Todavía no hay respuesta. El Tercer Circuito sostuvo que el entrenamiento de Ross con las headnotes de Westlaw no fue uso legítimo, pero Ross no era un modelo generativo. Anthropic pagó $1.5 billion por libros pirateados sin que hubiera sentencia sobre el entrenamiento en sí. Los tribunales fuera de EE. UU., como el de Múnich en el caso Suno, aplican reglas distintas.
¿Me pueden demandar por usar imágenes o textos generados con IA?
Es posible, pero las demandas contra usuarios corrientes son raras. El riesgo aumenta si el resultado copia una obra, un personaje o una voz reconocibles, o si lo usas en publicidad. Los clientes de empresa de algunos proveedores tienen una indemnización, así que comprueba en qué plan estás.
¿Quién es dueño del contenido generado con IA en EE. UU.?
Puedes ser dueño de las partes que creó un humano, como tus ediciones, tu selección y tu organización. El material puramente generado por máquina no está protegido, y el Tribunal Supremo rechazó revisar esa cuestión en 2026. Los términos de los proveedores suelen cederte los derechos que existan, pero no pueden crear derechos que la ley no concede.
¿Es seguro usar Suno para música comercial?
Lee los términos actuales y los detalles del plan de Suno antes de usar resultados en trabajo de pago. Suno dice tener alianzas con Warner Music Group y BMG, y un tribunal de Múnich falló contra Suno en el caso GEMA en 2026 (Suno puede recurrir). Los resultados que proceden de un catálogo con licencia no vienen etiquetados como tales.
¿Cuándo se resolverá el caso del New York Times?
Nadie puede decirlo todavía. El caso está en juicio sumario, y la parte que pierda puede apelar, lo que suele tardar mucho. Considera cualquier sentencia como una etapa, no como el final.