Descripción
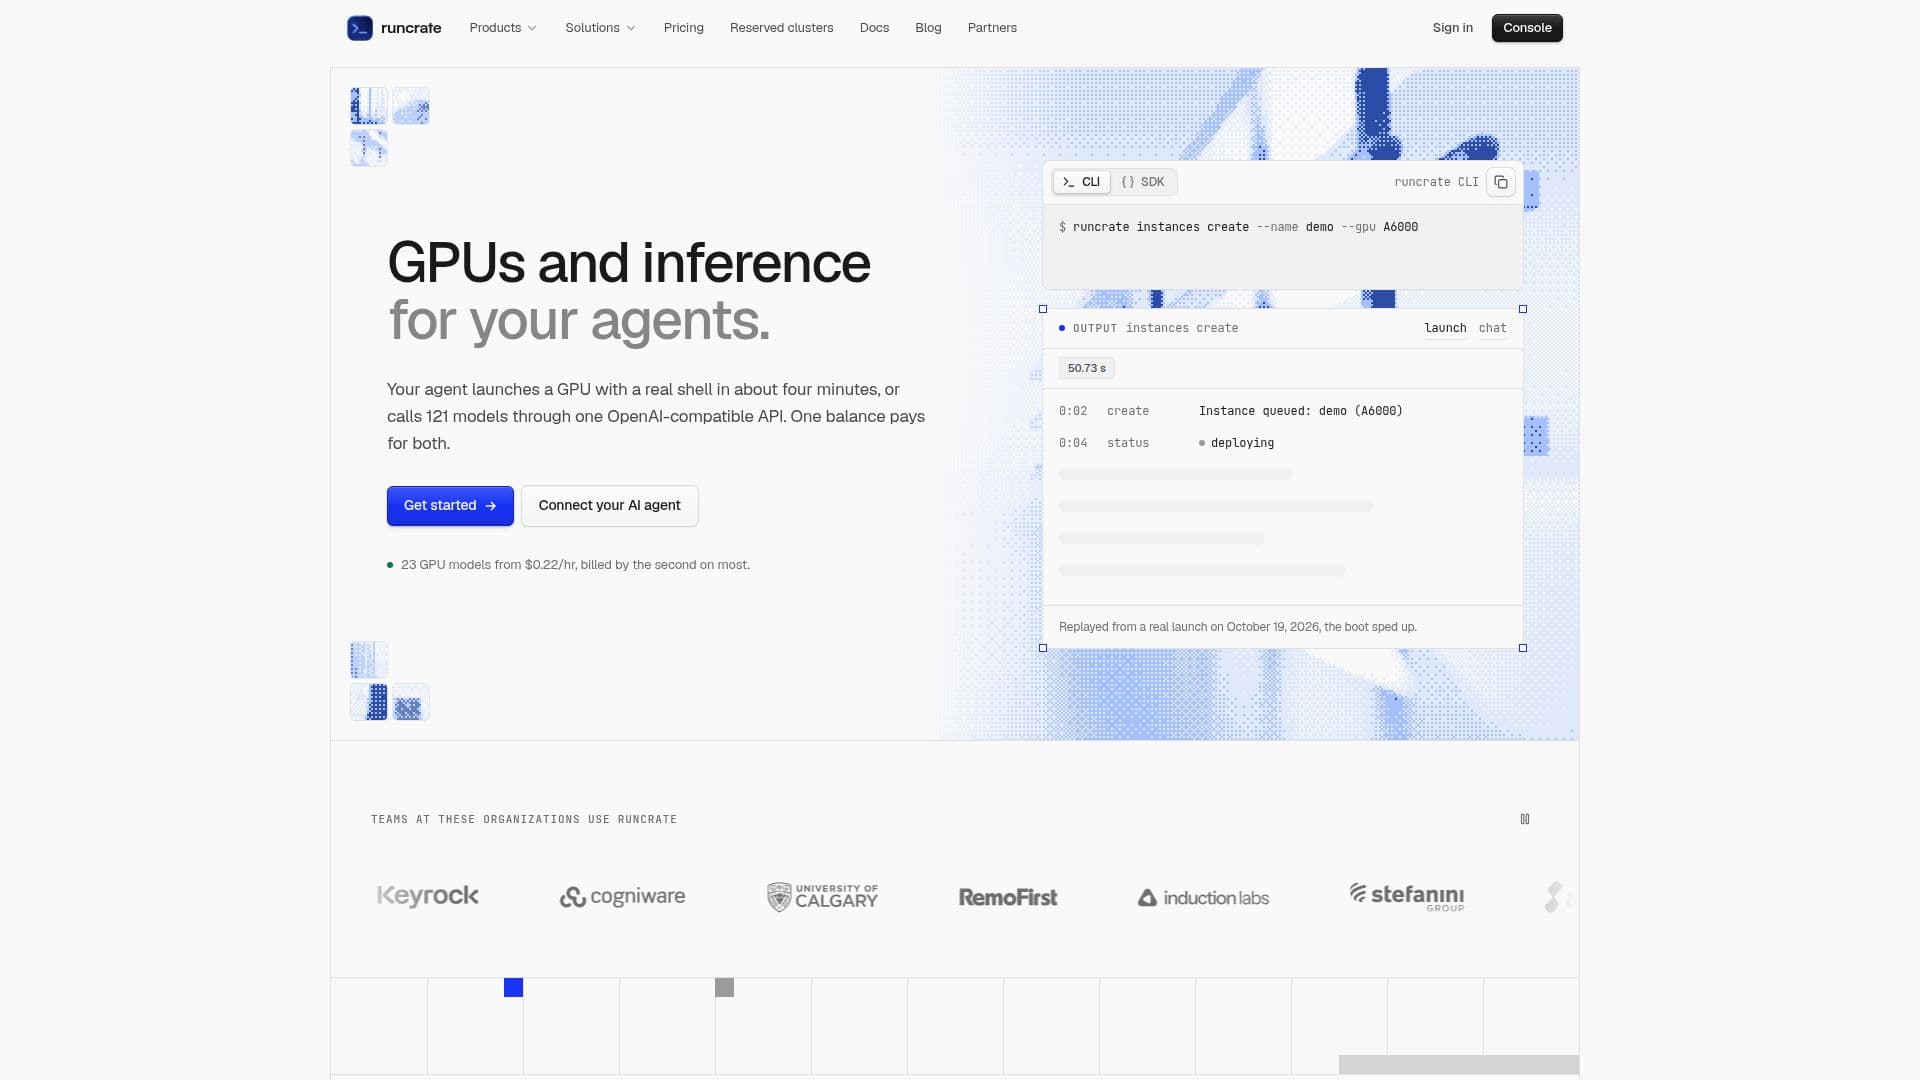
Runcrate, desarrollado por Aeonmind, ofrece una infraestructura de nube de IA integral diseñada para equipos de IA y aprendizaje automático. Proporciona acceso bajo demanda a potentes GPUs, incluyendo H100, H200, A100, L40S y RTX 4090, que se facturan por segundo para la mayoría de los modelos. Las instancias de GPU pueden ser lanzadas y estar operativas en minutos, eliminando colas de aprobación y solicitudes de cuota.
Leer más
La plataforma también cuenta con una API de inferencia compatible con OpenAI, que permite a los usuarios llamar a 121 modelos diferentes para diversas tareas como generación de texto, visión, procesamiento de imágenes, video, voz, transcripción y embeddings. Esta API unificada simplifica la integración y el uso de modelos, con un solo saldo que cubre tanto el uso de GPU como la inferencia de modelos.
Runcrate apoya una amplia gama de actividades de desarrollo de IA. Los usuarios pueden ajustar modelos abiertos como Llama, Mistral o Qwen con sus propios datos utilizando LoRA, servir LLMs de código abierto en GPUs dedicadas con vLLM, y transcribir archivos de audio y video a gran escala utilizando la API de Whisper. La plataforma también facilita la ejecución de ComfyUI en instancias RTX 4090 y el desarrollo de pipelines RAG mediante la incorporación de documentos y el uso de modelos de chat para respuestas.
Para la persistencia de datos, Runcrate ofrece volúmenes de almacenamiento que mantienen el código, los datos y los puntos de control entre instancias, asegurando que el trabajo no se pierda cuando se terminan las GPUs. La facturación es precisa, comenzando solo cuando una instancia está en funcionamiento y típicamente cobrada por segundo, sin cargos por tiempo de arranque. La plataforma se integra con herramientas como Claude Code, Codex y Cursor, permitiendo a los agentes lanzar y gestionar instancias de GPU directamente.
El modelo de precios de Runcrate incluye facturación por segundo para instancias de GPU, precios por token para llamadas a la API de inferencia y tarifas mensuales para volúmenes de almacenamiento. Se ofrecen opciones prepagadas para GPUs e inferencia, y los usuarios pueden reservar clústeres de múltiples nodos para proyectos a largo plazo. La visión de la empresa es hacer que el desarrollo de IA sea más barato y accesible al eliminar cuellos de botella en la infraestructura y promover modelos abiertos.
- CategoríaPlataformas de aprendizaje automático
- Modelo de preciosPago por uso
- ImplementaciónNube
- PlataformasWeb
Características principales de Runcrate
Instancias de GPU bajo demanda (H100, H200, A100, L40S, RTX 4090)
Facturación por segundo para la mayoría de las GPUs
API de inferencia compatible con OpenAI con 121 modelos
Despliegue rápido de instancias de GPU (típicamente en minutos)
Soporte para ajuste fino de LLMs (Llama, Mistral, Qwen) con LoRA/QLoRA
Servir LLMs de código abierto en GPUs dedicadas con vLLM
API de Whisper para transcripción de audio y video
Volúmenes de almacenamiento para datos persistentes entre instancias
Cuenta unificada y saldo para todos los productos (GPUs, inferencia, almacenamiento)
Integración con agentes de IA y herramientas de desarrollo (Claude Code, Codex, Cursor)
Opciones prepagadas y clústeres reservados disponibles
Sin facturación durante el tiempo de arranque de la GPU
Acceso a Jupyter y VS Code en el navegador
Imágenes listas para ajuste fino y servicio
Recarga automática para gestión de umbrales de crédito
¿Cómo usar Runcrate?
Conectar: Agrega Runcrate a tu herramienta preferida (Claude Code, Codex, Cursor o terminal) con un comando.
Iniciar sesión: Aprueba el acceso a través de tu navegador, sin necesidad de pegar una clave.
Lanzar GPU: Pide a tu agente que lance una GPU específica con un crate deseado, por ejemplo, «Lanza un H100 con el crate Finetune».
Configurar recursos: Selecciona tu modelo de GPU y configura los recursos necesarios.
Desplegar: Lanza la instancia; la facturación comienza cuando la instancia de GPU está en funcionamiento.
Gestionar: Despliega, gestiona y termina instancias de GPU directamente desde la terminal o herramientas integradas.
Utilizar: Usa la GPU para entrenar, servir modelos o llamar a modelos a través de la API compatible con OpenAI.
Almacenar datos: Mantén tu trabajo entre instancias utilizando volúmenes de almacenamiento persistentes.
Casos de uso de Runcrate
- Entrenamiento de Modelos
- Inferencia de IA
- Ajuste fino de LLMs
- Pipelines RAG
- Operaciones de Agentes de IA
- Generación de Imágenes y Videos
- Procesamiento de Voz y Audio
- Tareas de Visión por Computadora
- Procesamiento de Datos
- Investigación y Experimentos