Saltar al contenido principal
ToolPotion
Asesor de IA
Enviar

oMLX

oMLX es un servidor de inferencia nativo de macOS optimizado para Apple Silicon. Reduce significativamente el TTFT del agente de 30-90 segundos a menos de 5 segundos utilizando almacenamiento en caché KV en SSD paginado. Compatible con las API de OpenAI y Anthropic, mejora el rendimiento de la IA local en Mac.

Visitar URL
Compartir
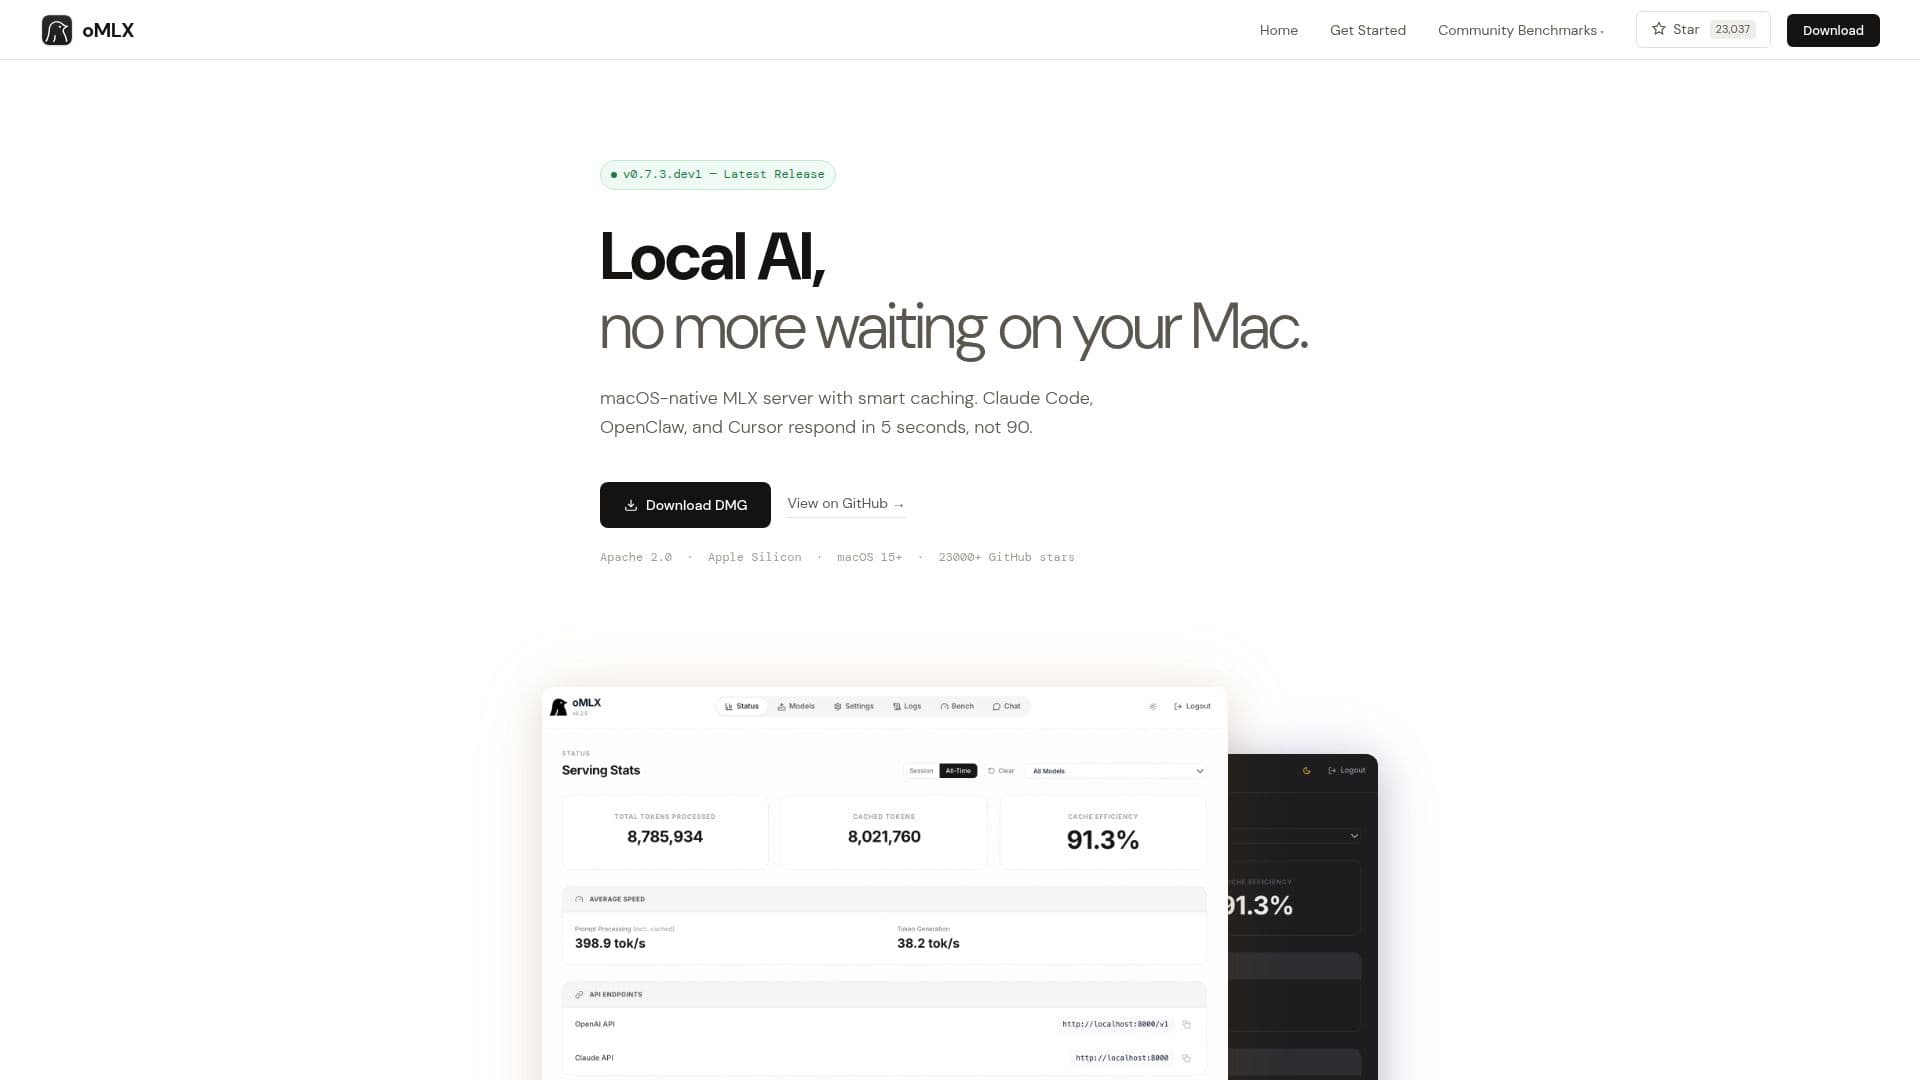
Captura de pantalla de oMLX

oMLX es un servidor de inferencia de vanguardia diseñado específicamente para macOS, aprovechando el poder de Apple Silicon. Construido sobre el marco MLX, ofrece una solución nativa para ejecutar modelos de lenguaje grande (LLMs) localmente en computadoras Mac. Una de sus características destacadas es el almacenamiento en caché KV en SSD paginado, que reduce drásticamente el tiempo hasta el primer token (TTFT) de 30-90 segundos a menos de 5 segundos. Esta mejora es particularmente beneficiosa para los agentes de codificación que invalidan frecuentemente la caché, ya que oMLX asegura que cada bloque de caché se persista en el SSD, permitiendo una rápida restauración desde el disco.

Leer más

El servidor es compatible con API populares como OpenAI y Anthropic, lo que lo convierte en una herramienta versátil para desarrolladores que trabajan con estas plataformas. Soporta el procesamiento por lotes continuo y proporciona una API de reemplazo para modelos como Claude Code, OpenClaw y Cursor, asegurando que las respuestas se entreguen en cuestión de segundos. Los benchmarks de rendimiento realizados en un M3 Ultra con 512GB de RAM demuestran un rendimiento impresionante y eficiencia de memoria en varios contextos y tamaños de lote.

oMLX está diseñado para desarrolladores y entusiastas de la IA que requieren una solución de IA local rápida y confiable en sus Macs. Elimina la necesidad de inferencia basada en la nube, reduciendo la latencia y la dependencia de servidores externos. La herramienta es de código abierto bajo la licencia Apache 2.0, con una fuerte presencia comunitaria, como lo demuestra su más de 23,000 estrellas en GitHub. Los usuarios pueden comenzar fácilmente descargando el DMG o instalando desde el código fuente, con compatibilidad para cachés estándar de Hugging Face y carpetas de LM Studio.

En general, oMLX ofrece una solución robusta y eficiente para ejecutar modelos de IA localmente en macOS, proporcionando mejoras significativas en velocidad e integración fluida con flujos de trabajo de IA existentes.

  • CategoríaMLOps y despliegue de modelos
  • Modelo de preciosCódigo abierto
  • ImplementaciónLocal
  • PlataformasmacOS 15+

  • Servidor de inferencia nativo de macOS

  • Almacenamiento en caché KV en SSD paginado

  • Compatibilidad con API de OpenAI y Anthropic

  • Soporte para procesamiento por lotes continuo

  • API de reemplazo para Claude Code, OpenClaw y Cursor

  • Rápida restauración de caché desde SSD

  • Código abierto bajo Apache 2.0

  • Más de 23,000 estrellas en GitHub

  1. Descargar: Obtener el DMG o el código fuente

  2. Instalar: Seguir las instrucciones de instalación

  3. Configurar: Configurar con la caché de Hugging Face

  4. Usar: Ejecutar modelos con TTFT reducido

  5. Optimizar: Aprovechar el procesamiento por lotes continuo

  • Desarrollo de IA Local
  • Integración de API
  • Agentes de Codificación
  • Procesamiento por Lotes
  • Contribución de Código Abierto

De oMLX

Reseñas de oMLX

Cargando...

Herramientas de IA populares como oMLX

omlx

Repositorios de IA en GitHub

omlx es un servidor de inferencia LLM diseñado para Apple Silicon, que cuenta con procesamiento por lotes continuo y almacenamiento en caché SSD. Se gestiona directamente desde la…

MLOps y despliegue de modelos

N.º 185 en Programación y desarrollo

Ver herramienta

Repositorios de IA en GitHub

Servidor de inferencia LLM diseñado para Apple Silicon, que cuenta con procesamiento por lotes continuo y almacenamiento en caché SSD. Se gestiona directamente desde la…omlx es un servidor de inferencia LLM diseñado para Apple Silicon, que cuenta con procesamiento por lotes continuo y almacenamiento en caché SSD. Se gestiona directamente desde la…

MLOps y despliegue de modelos
N.º 185 en Programación y desarrollo

Un proveedor de inferencia de IA de alta velocidad que sirve modelos en infraestructura ASIC diseñada específicamente a través de una API compatible con OpenAI, ofreciendo un bajo…

MLOps y despliegue de modelos
Ver herramienta

Un proveedor de inferencia de IA de alta velocidad que sirve modelos en infraestructura ASIC diseñada específicamente a través de una API compatible con OpenAI, ofreciendo un bajo…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

RunInfra

Apps de IA

RunInfra es una puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…

MLOps y despliegue de modelos

N.º 98 en MLOps y despliegue de modelos

Ver herramienta

Apps de IA

Puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…RunInfra es una puerta de enlace API alojada para modelos de IA de código abierto, que proporciona a los desarrolladores una clave API compatible con los SDK de OpenAI y…

MLOps y despliegue de modelos
N.º 98 en MLOps y despliegue de modelos

vLLM

Apps de IA

vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grande (LLMs). Permite un despliegue más rápido de modelos de IA con…

MLOps y despliegue de modelos
Ver herramienta

Apps de IA

Motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grande (LLMs). Permite un despliegue más rápido de modelos de IA con…vLLM es un motor de inferencia y servicio de alto rendimiento y eficiente en memoria para Modelos de Lenguaje Grande (LLMs). Permite un despliegue más rápido de modelos de IA con…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

Inference.net

Apps de IA

Inference.net proporciona infraestructura para equipos nativos de IA para ejecutar, monitorear y optimizar cargas de trabajo de IA. Ofrece inferencia ultrarrápida para modelos de…

MLOps y despliegue de modelos

N.º 78 para Ajuste fino de modelos de AI

Ver herramienta

Apps de IA

Proporciona infraestructura para equipos nativos de IA para ejecutar, monitorear y optimizar cargas de trabajo de IA. Ofrece inferencia ultrarrápida para modelos de…Inference.net proporciona infraestructura para equipos nativos de IA para ejecutar, monitorear y optimizar cargas de trabajo de IA. Ofrece inferencia ultrarrápida para modelos de…

MLOps y despliegue de modelos
N.º 78 para Ajuste fino de modelos de AI

Runware

Apps de IA

Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver herramienta

Apps de IA

Plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…Runware es una plataforma de inferencia de IA generativa que proporciona una API unificada para modelos de imagen, video, audio, 3D, LLM y visión. Ofrece más de 400,000 modelos,…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA

BLACKBOX AI

Apps de IA

BLACKBOX AI es una plataforma de inferencia que enruta solicitudes a través de más de 300 modelos de lenguaje abiertos y cerrados a través de una API encriptada compatible con…

MLOps y despliegue de modelos

N.º 125 en Apps de IA

Ver herramienta

Apps de IA

Plataforma de inferencia que enruta solicitudes a través de más de 300 modelos de lenguaje abiertos y cerrados a través de una API encriptada compatible con…BLACKBOX AI es una plataforma de inferencia que enruta solicitudes a través de más de 300 modelos de lenguaje abiertos y cerrados a través de una API encriptada compatible con…

MLOps y despliegue de modelos
N.º 125 en Apps de IA

Chutes es una plataforma de computación AI sin servidor que permite a los usuarios desplegar, ejecutar y escalar cualquier modelo de AI en segundos. Con un enfoque en modelos de…

MLOps y despliegue de modelos
Ver herramienta

Plataforma de computación AI sin servidor que permite a los usuarios desplegar, ejecutar y escalar cualquier modelo de AI en segundos. Con un enfoque en modelos de…Chutes es una plataforma de computación AI sin servidor que permite a los usuarios desplegar, ejecutar y escalar cualquier modelo de AI en segundos. Con un enfoque en modelos de…

MLOps y despliegue de modelos
Ver el Top 250 de Apps de IA
1 de 8