Descripción
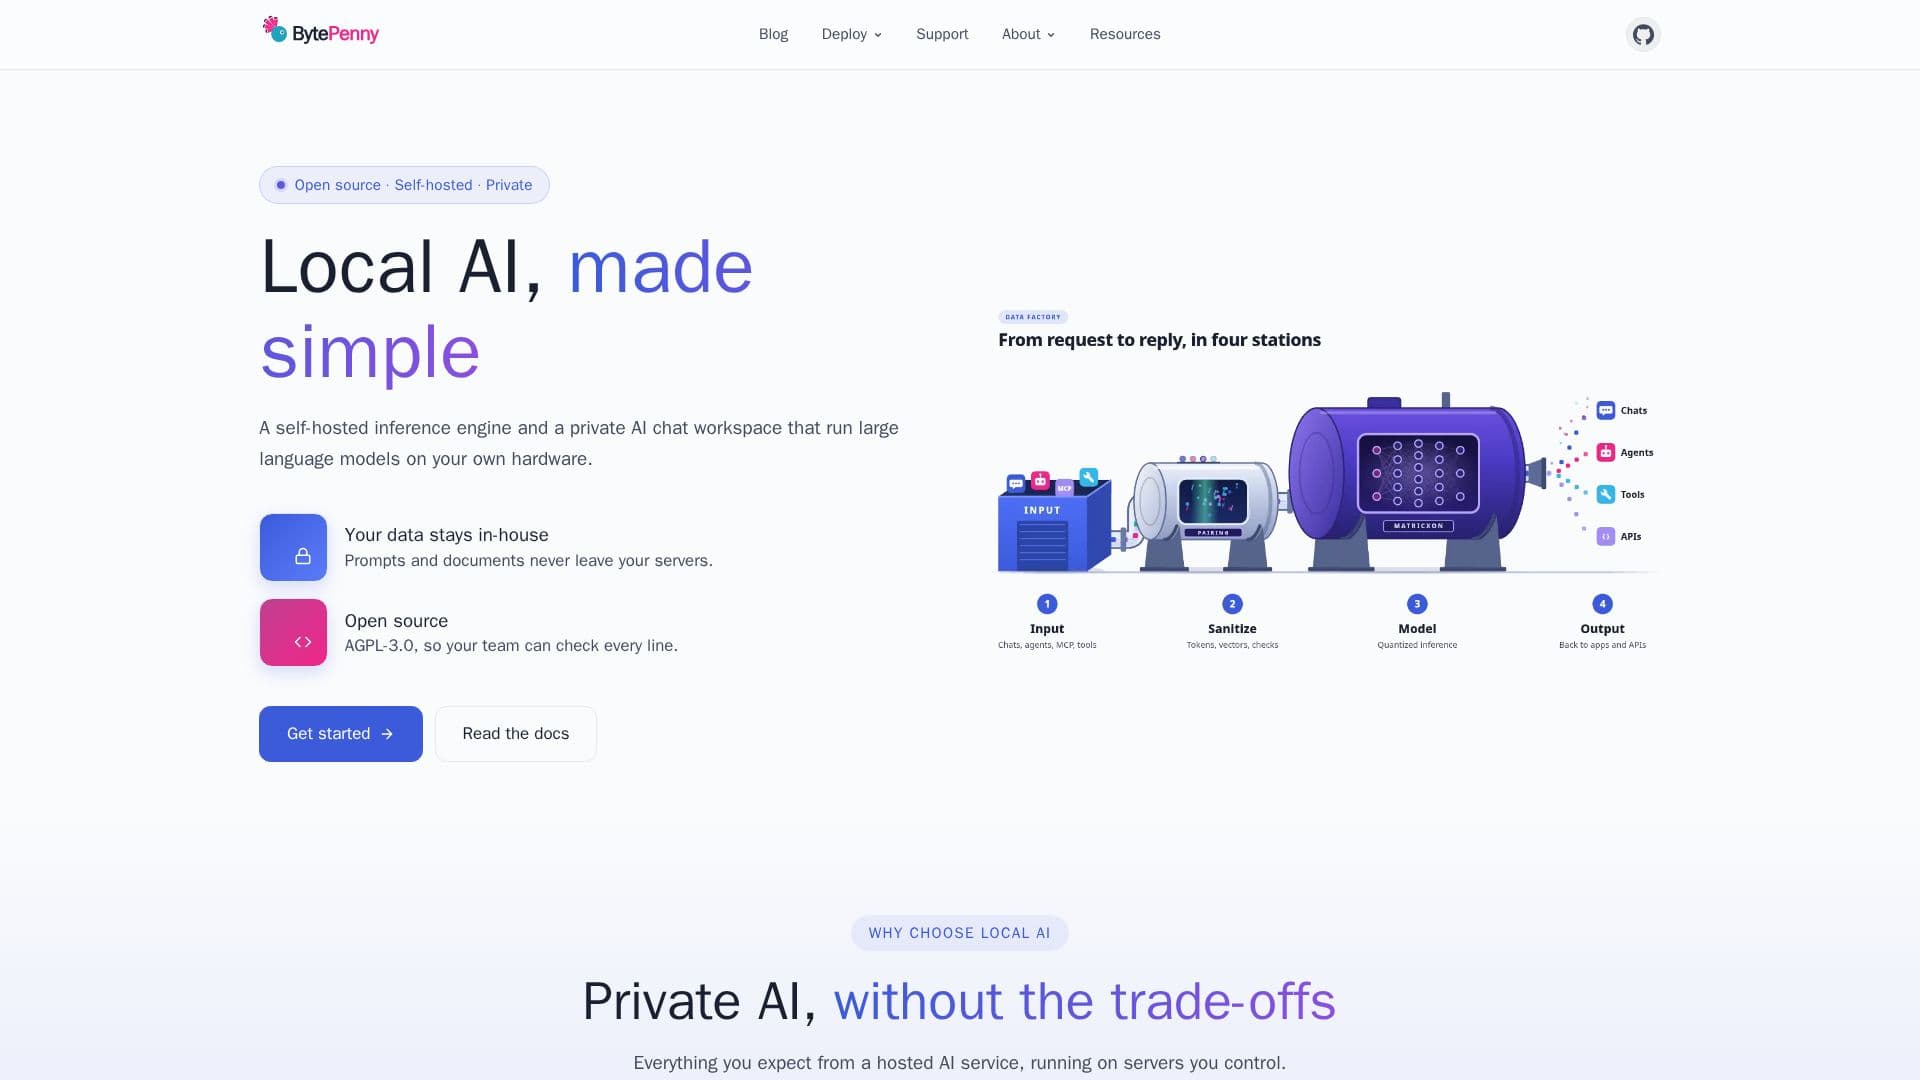
BytePenny proporciona un conjunto completo de herramientas de IA de código abierto y autohospedadas diseñadas para la privacidad y el control. La oferta principal incluye Matricxon, un motor de inferencia GGUF de código abierto, y pAIring, un espacio de trabajo de chat de IA privado adaptado para equipos. Estos productos permiten a las organizaciones ejecutar modelos de lenguaje grande directamente en su propio hardware, asegurando que los mensajes, documentos y datos de chat nunca abandonen sus servidores.
Leer más
La plataforma enfatiza la privacidad de los datos, operando completamente fuera de línea para mantener toda la información sensible en casa. Soporta varios modelos GGUF de fuentes como Hugging Face, llama.cpp o motores Matricxon, y puede integrarse con servidores de herramientas MCP. BytePenny está construido con una filosofía de código abierto, utilizando una licencia AGPL-3.0, que permite a los equipos inspeccionar y modificar cada línea de código, fomentando la transparencia y la confianza.
Matricxon, el motor de inferencia, es un runtime LLM ligero y legible escrito en Python y PyTorch, con núcleos C nativos para un rendimiento acelerado. Soporta modelos GGUF para tareas como chat, generación de texto, embeddings, reordenamiento, modelos de visión-lenguaje y pronósticos de series temporales, sirviéndolos a través de una API HTTP. Funciona de manera eficiente en CPUs y ofrece soporte BETA para GPUs NVIDIA, con planes de expansión a GPUs AMD y Apple Silicon. Matricxon también soporta un modo de clúster para modelos compartidos y cachés de chat a través de múltiples nodos, gestionados desde la interfaz de usuario de pAIring.
pAIring, el espacio de trabajo de chat de IA privado, está diseñado para la colaboración en equipo, ofreciendo características como acceso basado en roles, canales compartidos y una base de conocimientos integrada. Proporciona cachés de chat encriptados y asegura que los mensajes nunca se utilicen para el entrenamiento de modelos. El sistema es escalable, permitiendo a los usuarios comenzar con un solo servidor y expandirse añadiendo nodos con capacidades de balanceo de carga y conmutación por error. Para escenarios que requieren más potencia, pAIring puede conectarse a varios proveedores de nube como Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, y más, ofreciendo flexibilidad para mezclar motores locales y en la nube.
BytePenny elimina la facturación por token, permitiendo a las organizaciones aprovechar el hardware existente y mantener costos fijos a medida que el uso crece. Todo el stack está diseñado para ser abierto, desde el código AGPL-3.0 hasta modelos de pesos abiertos, haciéndolo ideal para redes privadas y cerradas. La seguridad es una preocupación primordial, con características como contraseñas hash bcrypt, secretos almacenados encriptados, cachés de chat encriptados con AES-256-GCM, y verificaciones de roles del lado del servidor para acciones administrativas. Tanto Matricxon como pAIring han obtenido la insignia de 'aprobado' de las Mejores Prácticas de OpenSSF, demostrando un compromiso con prácticas de desarrollo seguro.
- CategoríaMLOps y despliegue de modelos
- Modelo de preciosOpen Source (AGPL-3.0), No Per-Token Bills
- ImplementaciónSelf-Hosted, On-Premise, Cloud (Hybrid)
- PlataformasWindows, Linux
Características principales de BytePenny
Motor de inferencia de IA autohospedado (Matricxon)
Espacio de trabajo de chat de IA privado para equipos (pAIring)
Ejecutar modelos de lenguaje grande en su propio hardware
Los datos permanecen en casa; los mensajes y documentos nunca abandonan los servidores
Código abierto con licencia AGPL-3.0
Funciona completamente fuera de línea
Cachés de chat encriptados con AES-256-GCM
Acceso basado en roles para equipos
Los mensajes nunca se utilizan para el entrenamiento de modelos
Soporta modelos GGUF de Hugging Face, llama.cpp, Matricxon
Núcleos cuantizados para soporte de CPU y GPU NVIDIA
Sin facturación por token; costos fijos con el crecimiento del uso
Despliegue escalable: nodo único, clúster compartido o servidores separados
Se conecta a más de 12 proveedores de nube (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq, etc.)
Escrito desde cero en Python para legibilidad y personalización
¿Cómo usar BytePenny?
Desplegar BytePenny: Instale Matricxon y pAIring en sus propios servidores o infraestructura en la nube.
Configurar el Motor de Inferencia: Configure Matricxon como el motor de inferencia local o conecte pAIring a un proveedor de nube preferido.
Agregar Modelos: Integre modelos GGUF de Hugging Face u otras fuentes, o utilice modelos alojados en la nube a través de conectores.
Gestionar Usuarios y Equipos: Configure el acceso basado en roles, cree canales compartidos y establezca una base de conocimientos dentro de pAIring.
Comenzar a Chatear: Inicie conversaciones privadas de IA y aproveche la base de conocimientos para la colaboración en equipo.
Monitorear y Escalar: Observe el estado del sistema, gestione los nodos del clúster y expanda el hardware a medida que el uso crece sin incurrir en costos por token.
Casos de uso de BytePenny
- Chat Privado para Equipos
- Inferencia LLM Local
- Análisis de Documentos Seguros
- Operaciones de IA Controladas por Costos
- Flujos de Trabajo de IA Fuera de Línea
- Despliegue de Modelos Personalizados
- Infraestructura de IA Escalable
- Desarrollo de IA de Código Abierto