Beschreibung
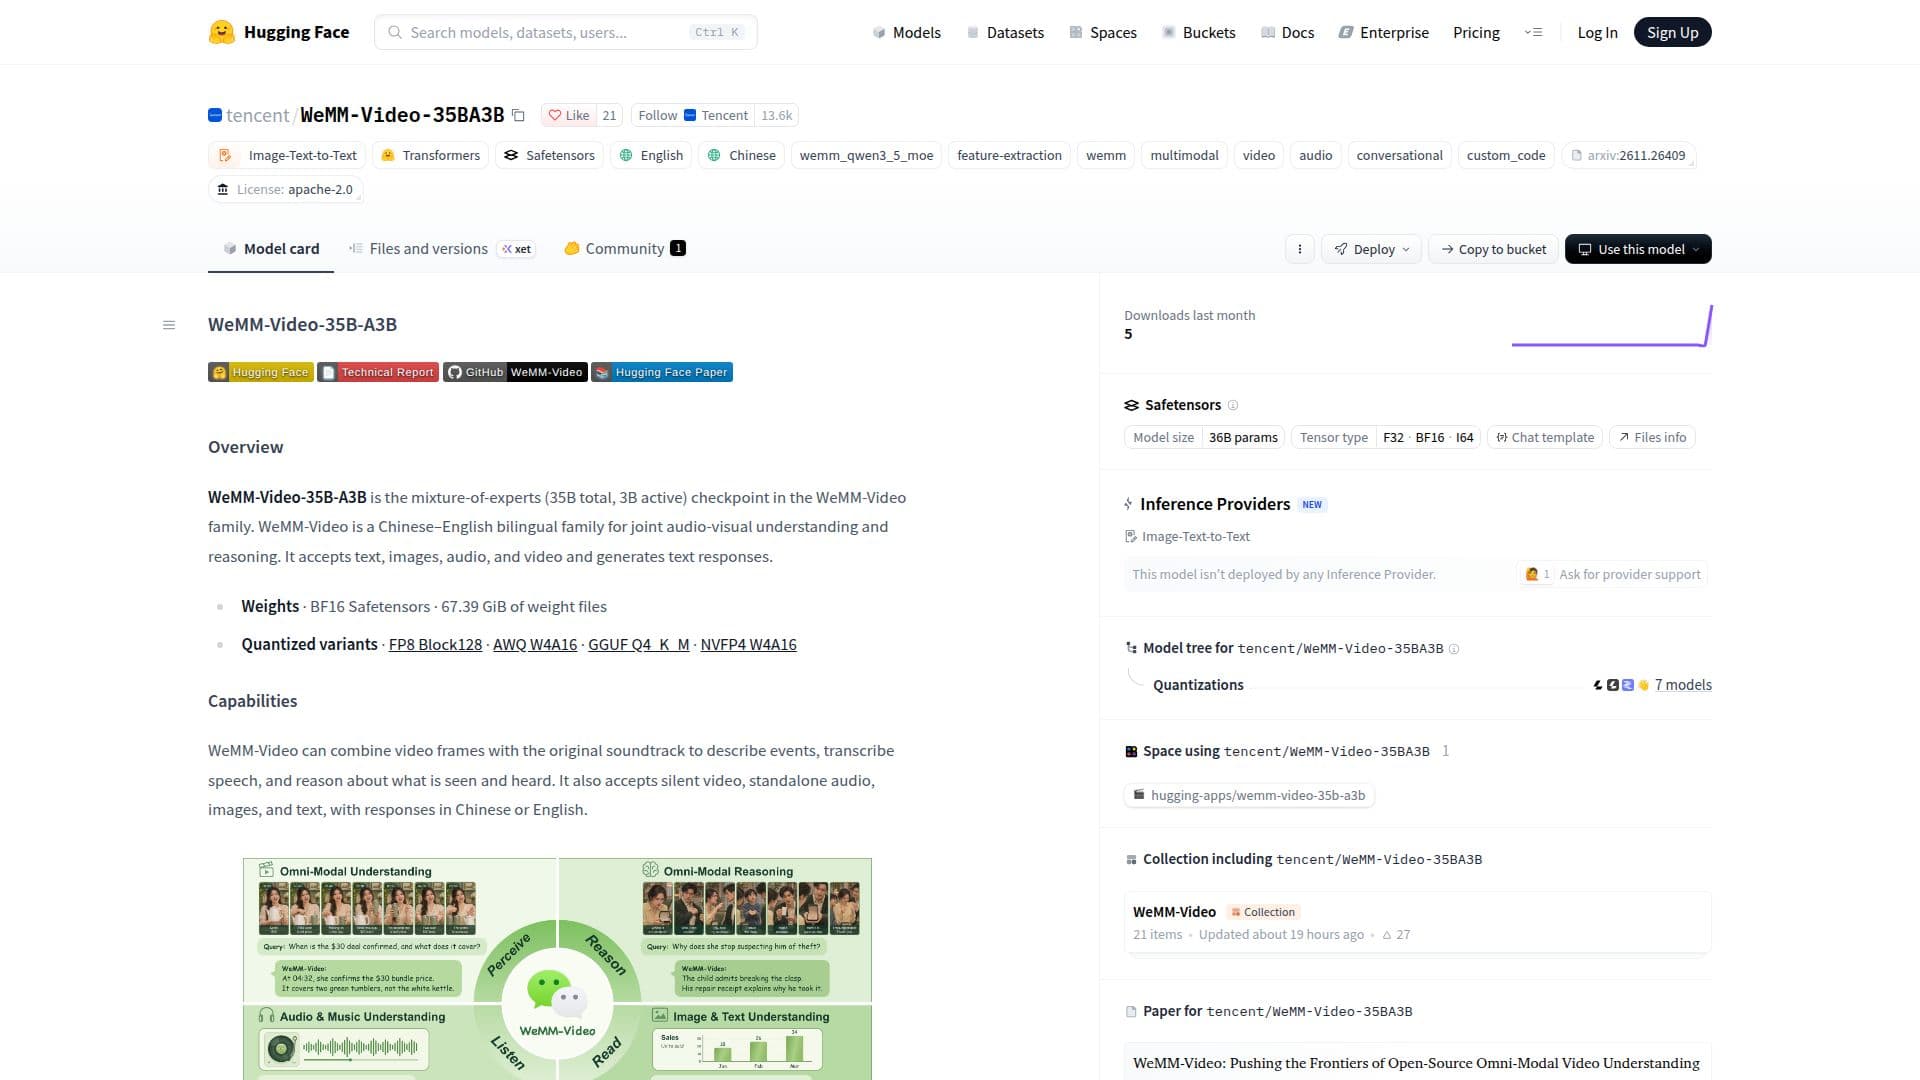
WeMM-Video-35B-A3B ist ein anspruchsvolles Mischung-von-Experten-Modell, das Teil der umfassenderen WeMM-Video-Familie ist und für ein umfassendes audio-visuelles Verständnis und Argumentation entwickelt wurde. Mit insgesamt 35 Milliarden Parametern und 3 Milliarden aktiven Parametern ist dieses Modell speziell darauf ausgelegt, multimodale Eingaben zu verarbeiten und zu interpretieren, einschließlich Text, Bilder, Audio und Video, und generiert kohärente Textantworten entweder in Chinesisch oder Englisch.
Weiterlesen
Die Kernfähigkeiten des Modells umfassen die Fähigkeit, Videobilder mit ihren ursprünglichen Soundtracks zu kombinieren, um Ereignisse zu beschreiben, Sprache genau zu transkribieren und Argumentationsaufgaben basierend auf visuellen und auditiven Informationen durchzuführen. Es ist auch vielseitig genug, um stummes Video, eigenständige Audios, Bilder und Texteingaben unabhängig zu verarbeiten. Dies macht es geeignet für eine Vielzahl von Anwendungen, die ein tiefes kontextuelles Verständnis über verschiedene Medientypen hinweg erfordern.
Architektonisch verwendet WeMM-Video-35B-A3B Vision- und Audio-Encoder, um Medieneingaben in Tokens umzuwandeln, die dann zusammen mit Text von einem Sprachmodell verarbeitet werden. Videobilder werden mit Zeitstempeln angereichert, um den zeitlichen Kontext aufrechtzuerhalten. Die Modellfamilie wurde umfangreich auf etwa 1,2 Billionen multimodalen Tokens vortrainiert, gefolgt von fortgeschrittenen Nachschulungstechniken wie Multi-Teacher OPD, Anti-Wiederholungs MrDPO und spezialisiertem Reinforcement Learning, um die Leistung und Robustheit zu verbessern.
Die Bereitstellung und Integration werden durch verschiedene Bereitstellungsoptionen erleichtert. Benutzer können die Transformers-Umgebung einrichten und Beispiele direkt aus dem WeMM-Video-Repository ausführen. Das Modell unterstützt quantisierte Varianten wie FP8 Block128, AWQ W4A16, GGUF Q4_K_M und NVFP4 W4A16. Für die Bereitstellung ist es kompatibel mit gepatchten Versionen von vLLM (0.18.0 und 0.31.0) und SGLang (0.5.16 oder 0.5.19), was eine effiziente Inferenz, einschließlich Tensorparallelität über mehrere GPUs, ermöglicht. Das Modell bietet auch verschiedene Chat-Modi, einschließlich eines Standard-Instruct-Modus und eines „Thinking-Modus“ für argumentierende Antworten.
WeMM-Video-35B-A3B hat eine starke Leistung gezeigt und einen neuen Open-Source-Stand der Technik etabliert. Es hat sich als überlegen gegenüber proprietären Modellen wie Qwen3.5-Omni-Flash und Seed2.0-Mini-0428 erwiesen und die Leistungsdifferenz zu fortgeschrittenen Modellen wie Gemini-3.0-Flash erheblich verringert. Das Modell wird unter der Apache License 2.0 veröffentlicht, was den offenen Zugang und die Zusammenarbeit innerhalb der KI-Community fördert.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
WeMM-Video-35B-A3B im Überblick
Chinesisch-englische bilinguale Verarbeitung
Gemeinsames audio-visuelles Verständnis und Argumentation
Akzeptiert Texte, Bilder, Audio- und Videoeingaben
Generiert Textantworten
Beschreibt Ereignisse aus Videobildern und Soundtracks
Transkribiert Sprache aus Audio
Argumentiert über visuelle und auditive Informationen
Unterstützt die Verarbeitung von stillem Video und eigenständigem Audio
Mischung-von-Experten-Architektur (35B insgesamt, 3B aktive Parameter)
Vortrainiert auf 1,2 Billionen multimodalen Tokens
Nachtrainiert mit Multi-Teacher OPD und MrDPO
Spezialisiertes Reinforcement Learning zur Leistungssteigerung
Unterstützt verschiedene quantisierte Varianten (FP8, AWQ, GGUF, NVFP4)
Kompatibel mit gepatchtem vLLM und SGLang für die Bereitstellung
Bietet Instruct- und Thinking-Chat-Modi
Erste Schritte mit WeMM-Video-35B-A3B
Umgebung einrichten: Installieren Sie die Transformers-Umgebung und die erforderlichen Abhängigkeiten.
Modell laden: Laden Sie das WeMM-Video-35B-A3B-Modell und den Prozessor aus dem Hugging Face Hub.
Eingaben vorbereiten: Stellen Sie Medieneingaben wie MP4-Video-Dateien, eigenständige Audios, Bilder oder Texte bereit.
Medien verarbeiten: Verwenden Sie das Skript, um Videobilder allein oder mit dem ursprünglichen Audiotrack zu verarbeiten.
Antworten generieren: Senden Sie Anfragen an das Modell und geben Sie den Chat-Modus (Instruct oder Thinking) für die Textgenerierung an.
Modell bereitstellen (optional): Installieren Sie den WeMM-Laufzeit-Patch und verwenden Sie gepatchtes vLLM oder SGLang für die API-Bereitstellung.
API-Anfragen senden: Verwenden Sie den gebündelten Anfrage-Client, um Medien inline an den OpenAI-kompatiblen Chat-Endpunkt zu senden.
WeMM-Video-35B-A3B's Anwendungsfälle
- Video-Inhaltsanalyse
- Sprachtranskription
- Multimodale Argumentation
- Bilinguale Inhaltsverarbeitung
- Audio-visuelle Ereignisbeschreibung
- Entwicklung von KI-Modellen
- Forschung und Experimentation