Beschreibung
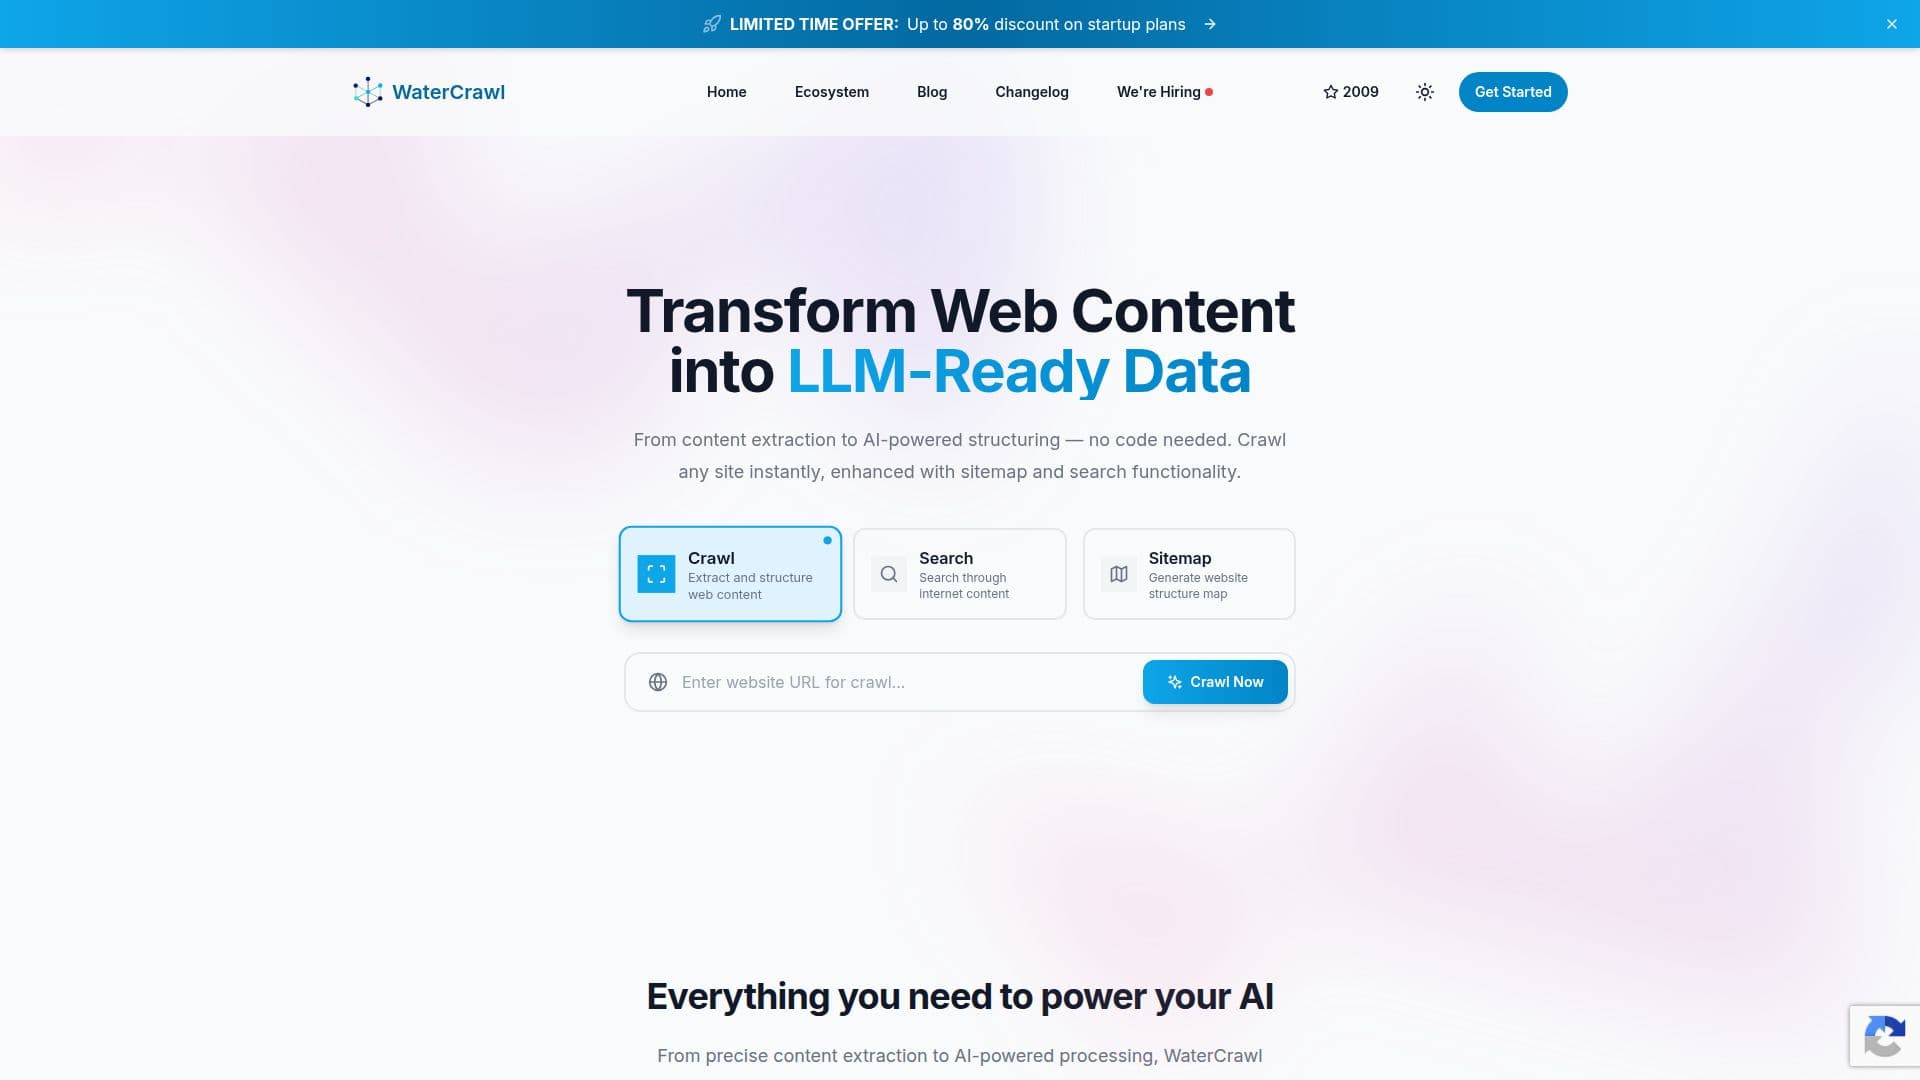
WaterCrawl ist eine moderne Plattform für Web-Crawling und Inhaltsextraktion, die jede Website in strukturierte, LLM-bereite Daten verwandelt. Entwickelt für Entwickler ermöglicht es Benutzern, jede Website sofort mit intelligenten Crawling-Steuerungen für Tiefe, Domains und Pfade zu durchsuchen, präzise Inhaltsextraktion mit benutzerdefinierten Selektoren, die Werbung und Fußzeilen herausfiltern, sowie JavaScript-Rendering, um dynamische Inhalte zu erfassen und Screenshots im PDF- oder JPG-Format zu erstellen.
Weiterlesen
Neben dem Crawling umfasst WaterCrawl eine Websuchmaschine für Echtzeitergebnisse im Internet, die automatische Sitemap-Generierung zur Kartierung aller URLs auf einer Website und die integrierte OpenAI-Integration, um rohes HTML in strukturierte, bedeutungsvolle Daten umzuwandeln. Es bietet ein erweiterbares Plug-in-System, Echtzeitüberwachung des Crawling-Status und der Leistung über Server-Sent Events sowie umfassende Fehlerberichterstattung. Das Projekt ist Open Source unter einer modifizierten MIT-Lizenz, wobei die kommerzielle Nutzung als konkurrierender Dienst eine Genehmigung erfordert.
Entwickler integrieren WaterCrawl über eine saubere REST-API mit JWT-basierter Authentifizierung und Webhook-Unterstützung sowie offiziellen SDKs für Python, Go, Node.js, PHP und Rust. Die API unterstützt das Starten von Einzel- oder Batch-Crawl-Anfragen, die Konfiguration von Spider- und Seitenoptionen, das Streaming von Live-Status und das Herunterladen von Ergebnissen als JSON oder Markdown sowie spezielle Suchendpunkte.
Ein kostenloser Plan bietet 1.000 Seiten-Credits pro Monat mit Rechenzentrums-Proxys und einem 7-tägigen Aufbewahrungszeitraum. Bezahlte Startup-, Wachstums- und Unternehmenspläne fügen weitere Seiten-Credits, höhere Crawltiefe und Parallelität, Premium-Residential-Proxys, mehr Teamplätze und längere Aufbewahrung hinzu.
- KategorieWeb Scraping & Datenextraktion
- PreismodellFreemium
- BereitstellungCloud
- PlattformenWeb
WaterCrawl's Kernfunktionen
Intelligente Crawling-Steuerungen für Tiefe, Domains und Pfade
Präzise Inhaltsextraktion mit benutzerdefinierten Selektoren
JavaScript-Rendering und Screenshots im PDF- oder JPG-Format
Integrierte Websuchmaschine mit Echtzeitergebnissen
Automatische Sitemap-Generierung und Standortkartierung
KI-gestützte Verarbeitung über OpenAI-Integration
Open Source mit einem erweiterbaren Plug-in-System
REST API, Webhooks und SDKs für mehrere Sprachen
Wie verwendet man WaterCrawl?
Kostenlos anmelden: Erstellen Sie ein Konto und erhalten Sie 1.000 monatliche Seiten-Credits.
API-Schlüssel erhalten: Generieren Sie einen Team-API-Schlüssel im Dashboard.
Crawl konfigurieren: Legen Sie die Start-URL, Tiefe, Domains und Seitenoptionen fest.
Ausführen und überwachen: Starten Sie den Crawl und verfolgen Sie den Fortschritt in Echtzeit über SSE.
Daten abrufen: Laden Sie Ergebnisse als JSON oder Markdown herunter oder erhalten Sie sie über Webhook.
WaterCrawl's Anwendungsfälle
- LLM-Datenpipelines
- Inhaltsaggregation
- Marktforschung
- Suchmaschinen
- Website-Überwachung