Beschreibung
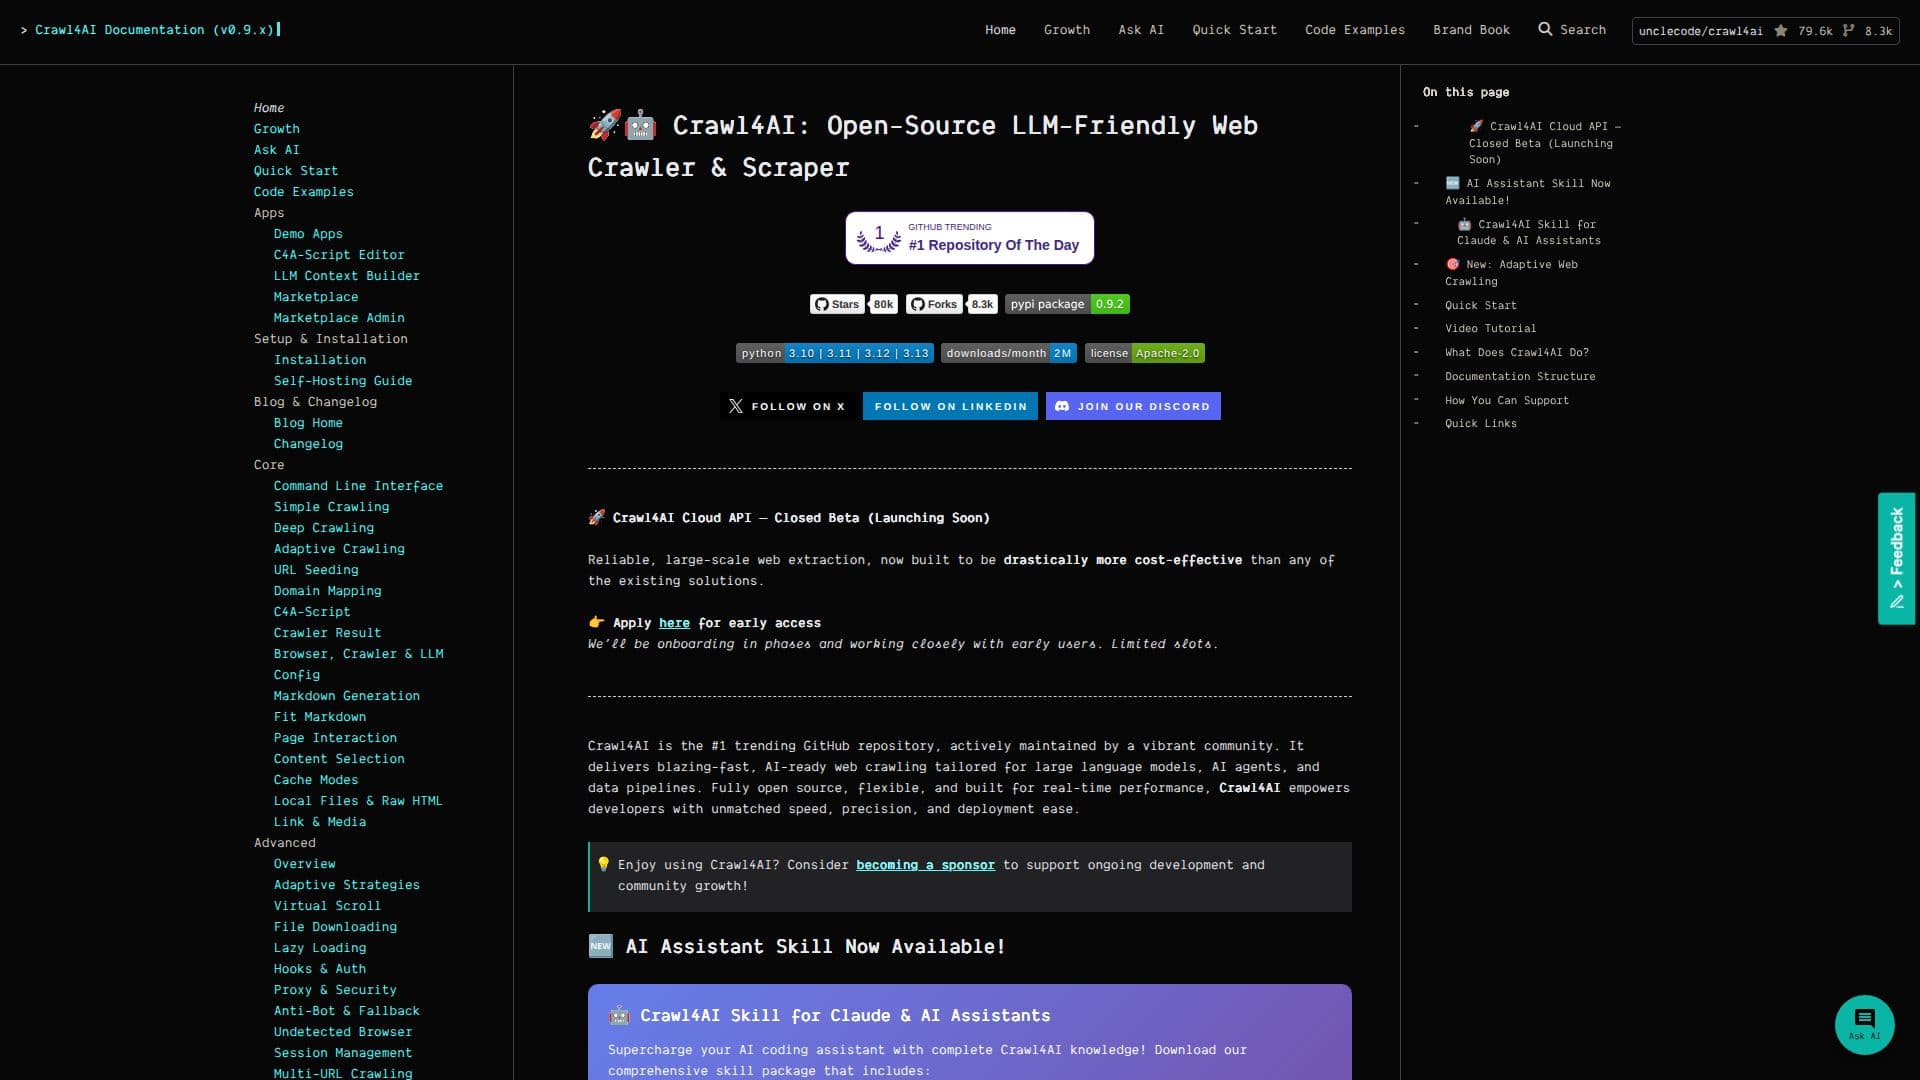
Crawl4AI ist ein Open-Source, LLM-freundlicher Web-Crawler und Scraper, der Entwicklern ermöglicht, effizient Daten aus dem Web zu extrahieren. Entwickelt für große Sprachmodelle und KI-Agenten, bietet es eine zuverlässige Lösung für die Web-Extraktion, die sowohl kosteneffektiv als auch einfach zu implementieren ist.
Weiterlesen
Die Plattform wird aktiv von einer lebhaften Community gepflegt und hat Anerkennung als das #1 trendende GitHub-Repository gewonnen. Mit seiner blitzschnellen Leistung ist Crawl4AI auf Echtzeitanwendungen zugeschnitten und somit eine ideale Wahl für Entwickler, die Web-Scraping in ihre Datenpipelines integrieren möchten.
Eine der herausragenden Funktionen von Crawl4AI ist die Fähigkeit, sauberes Markdown zu generieren, das perfekt für Retrieval-augmented Generation (RAG) Pipelines oder die direkte Eingabe in LLMs geeignet ist. Es unterstützt strukturierte Extraktion, die es Benutzern ermöglicht, wiederholte Muster mithilfe von CSS, XPath oder LLM-basierten Extraktionsmethoden zu analysieren. Darüber hinaus bietet Crawl4AI eine fortschrittliche Browserkontrolle mit Funktionen wie Hooks, Proxys, Stealth-Modi und Sitzungswiederverwendung, die eine feinkörnige Kontrolle über den Crawling-Prozess ermöglichen.
Crawl4AI führt auch intelligentes, adaptives Crawling ein, das fortschrittliche Informationsbeschaffungsalgorithmen nutzt, um zu bestimmen, wann genügend Informationen gesammelt wurden, um eine Anfrage zu beantworten. Diese Funktion verbessert die Effizienz der Datensammlung, indem unnötige Anfragen minimiert werden.
Die Dokumentation ist gut strukturiert und bietet klare Abschnitte zu Einrichtung, Installation und fortschrittlichen Funktionen. Benutzer finden praktische Anleitungen, Codebeispiele und Referenzen, die ihnen helfen, schnell zu starten. Die Plattform fördert die Beteiligung der Community, indem sie es Benutzern ermöglicht, durch Pull-Requests, das Einreichen von Problemen und die Teilnahme an Diskussionen auf Discord beizutragen.
Die Mission von Crawl4AI ist es, den Zugang zu Daten zu demokratisieren, indem es kostenlos und hochgradig konfigurierbar ist. Es zielt darauf ab, Studenten, Forschern, Unternehmern und Datenwissenschaftlern zu ermöglichen, die Daten der Welt schnell und kreativ zuzugreifen, zu analysieren und zu gestalten.
- KategorieWeb Scraping & Datenextraktion
- PreismodellKostenlos
- BereitstellungCloud
- PlattformenPlattformübergreifend
Crawl4AI's Kernfunktionen
Open Source
LLM-freundlich
Adaptives Crawling
Strukturierte Extraktion
Fortschrittliche Browserkontrolle
Hohe Leistung
Echtzeit-Anwendungsfälle
Keine erzwungenen API-Schlüssel
Wie verwendet man Crawl4AI?
Konfigurieren: Richten Sie Crawl4AI über pip oder Docker ein.
Verwenden: Starten Sie Ihren ersten Crawl mit den bereitgestellten Beispielen.
Extrahieren: Nutzen Sie strukturierte Extraktionsmethoden zur Datenanalyse.
Optimieren: Implementieren Sie fortschrittliche Funktionen wie adaptives Crawling und Sitzungspersistenz.
Crawl4AI's Anwendungsfälle
- Datenextraktion
- Web-Scraping
- Forschung
- KI-Training
- Inhaltsaggregation