Beschreibung
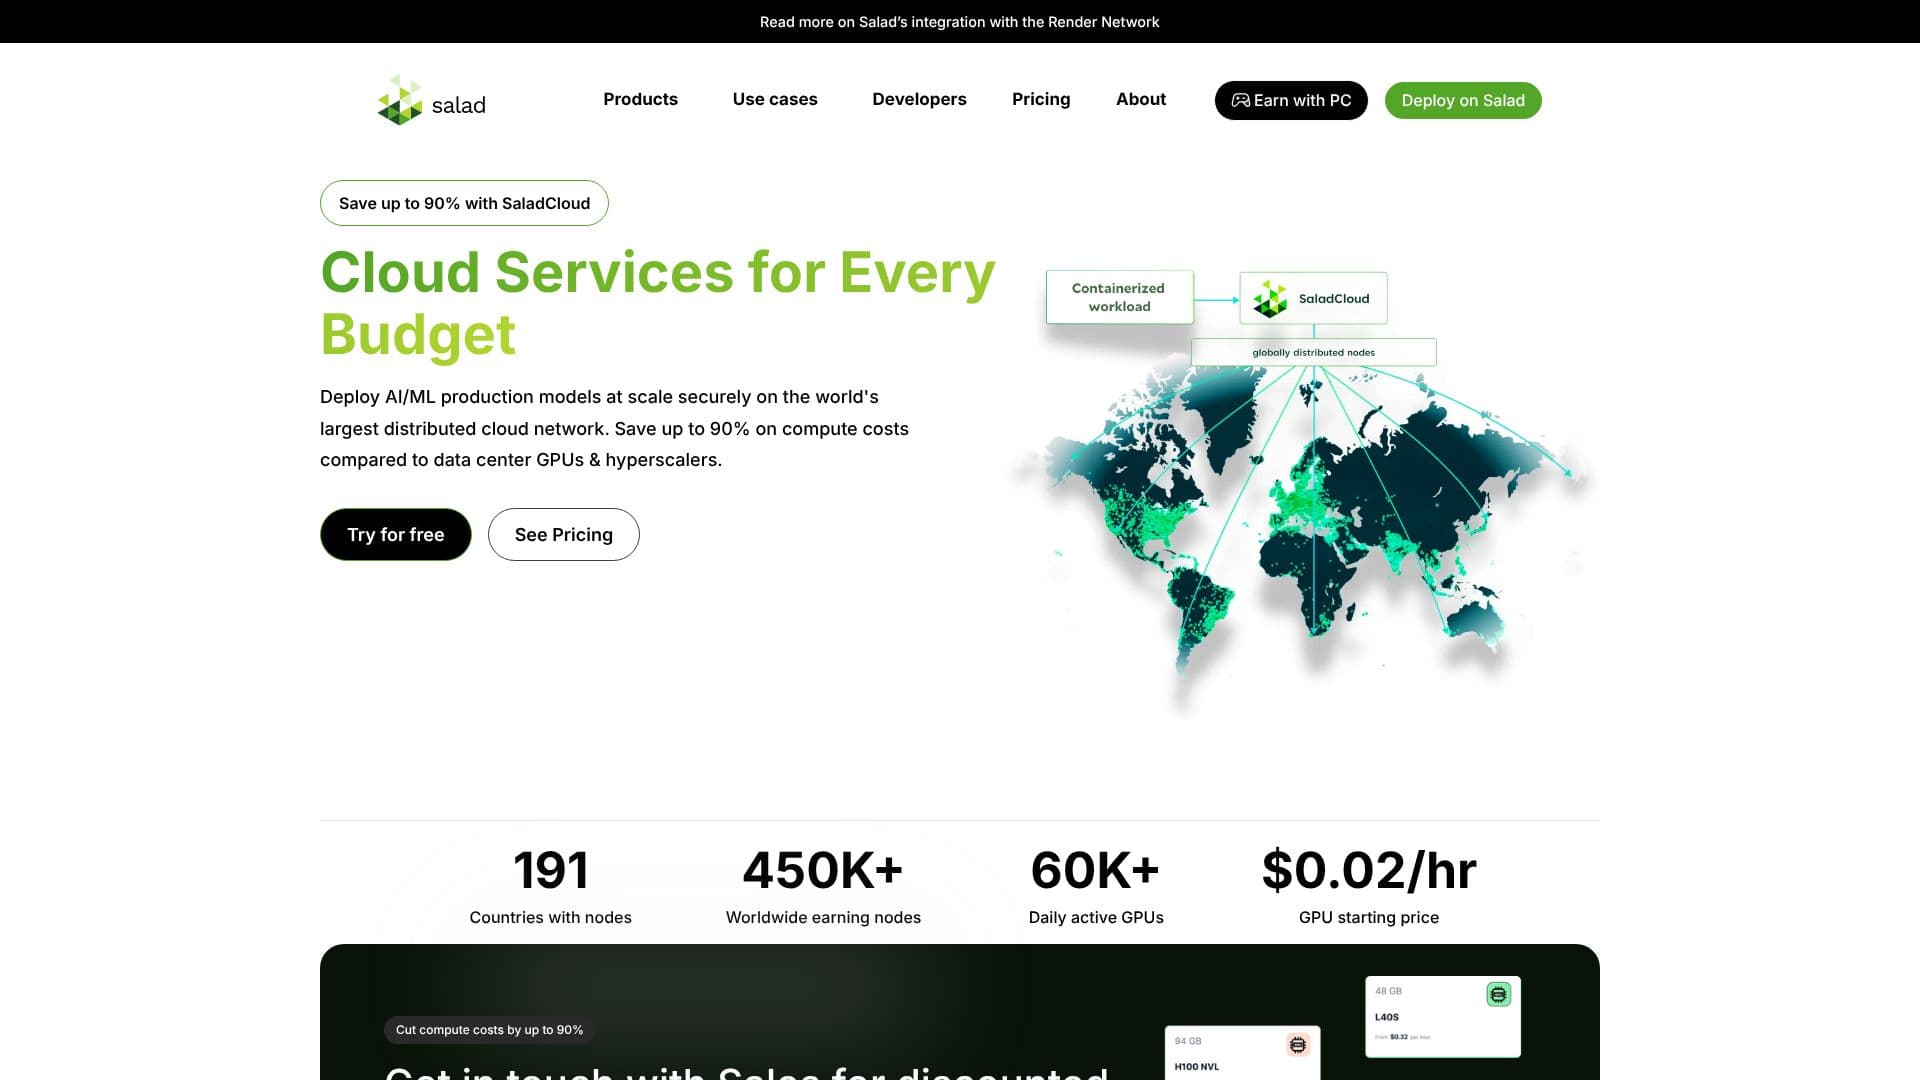
Salad definiert Cloud-Computing neu, indem es die weltweit größte KI-Rechenleistung freisetzt, die über ein globales Netzwerk von über 60.000 täglich aktiven GPUs verteilt ist. Diese Community-gesteuerte Cloud bietet deutlich niedrigere Kosten, mit Preisen ab nur 0,02 $ pro Stunde, was erhebliche Einsparungen von bis zu 90 % im Vergleich zu herkömmlichen Hyperscalern ermöglicht.
Weiterlesen
Salad ist für die nahtlose Skalierung von KI-Projekten konzipiert und ermöglicht es Unternehmen, KI/ML-Produktionsmodelle bereitzustellen, KI-Inferenz durchzuführen, Batch-Verarbeitung zu handhaben und anspruchsvolle Workloads wie Molekulardynamik mit unübertroffener Kosteneffizienz auszuführen. Die Plattform nutzt KI-fähige Consumer-GPUs und bietet für viele Anwendungsfälle ein überlegenes Kosten-Leistungs-Verhältnis im Vergleich zu Rechenzentrums-GPUs.
Die Salad Container Engine (SCE) ermöglicht es Benutzern, Workloads einfach bereitzustellen, ohne virtuelle Maschinen oder einzelne Instanzen verwalten zu müssen. Dieser vollständig verwaltete Containerdienst gewährleistet elastische Bedarfsbereitstellung, sodass Workloads mühelos mit dynamischer Ressourcenzuweisung skaliert werden können, um schwankende Anforderungen zu erfüllen. Das globale Edge-Netzwerk von Salad bringt die Rechenleistung näher an die Benutzer heran, mit Latenz-armen Knoten weltweit, was die Leistung und Zuverlässigkeit verbessert.
Salad ist ideal für eine breite Palette von GPU-intensiven Workloads, einschließlich Text-zu-Bild-Generierung, Text-zu-Sprache, Sprache-zu-Text, Computer Vision und Sprachmodelle. Die Plattform bietet Funktionen wie Multi-Cloud-Kompatibilität, die die Integration in bestehende Hybrid- oder Multi-Cloud-Konfigurationen ermöglicht, sowie optimierte Nutzungsgebühren mit transparenter, nutzungsbasierter Preisgestaltung und ohne Vorauszahlungsverträge oder Verpflichtungen.
Sicherheit hat Priorität, mit einem patentierten Ansatz, der Kundenumgebungen und Daten im gesamten Netzwerk isoliert. SaladCloud ist SOC2-zertifiziert und gewährleistet eine sichere und zuverlässige Bereitstellungsumgebung. Durch die Nutzung ungenutzter, latenter GPUs fördert Salad einen nachhaltigen Ansatz für das Computing, demokratisiert den Zugang zu Rechenleistung und reduziert die Umweltauswirkungen.
Kunden wie Civitai, Blend und Klyne.ai haben nach dem Wechsel zu SaladCloud erhebliche Kostensenkungen und verbesserte Skalierbarkeit gemeldet. Das Engagement der Plattform für Erschwinglichkeit, Skalierbarkeit und Kundenfreundlichkeit macht sie zu einer attraktiven Option für Start-ups und Unternehmen, die ihre Cloud-Compute-Ausgaben optimieren möchten.
- KategorieMLOps & Modell-Deployment
- PreismodellNutzungsbasiert
- BereitstellungCloud
- PlattformenWeb
Salad Distributed GPU Cloud's Kernfunktionen
Verteilte GPU-Cloud mit über 60.000 täglich aktiven GPUs
Kostengünstige GPU-Instanzen ab 0,02 $/Stunde
Bis zu 90 % Kostenersparnis im Vergleich zu Hyperscalern
Nahtlose Skalierung von KI-Projekten
Unterstützt KI-Inferenz, Batch-Verarbeitung und HPC-Workloads
Globales Edge-Netzwerk mit Latenz-armen Knoten
Salad Container Engine (SCE) für einfache Bereitstellung
Elastische Bedarfsbereitstellung und dynamische Ressourcenzuweisung
Multi-Cloud-kompatibel
Nutzungsbasierte Preisgestaltung ohne Verträge oder Verpflichtungen
SOC2-zertifiziert für Sicherheit
Keine Ingress-/Egress-Datakosten
Vollständig verwalteter Containerdienst
Unendliche Skalierbarkeit für GPU-Zugriff
Wie verwendet man Salad Distributed GPU Cloud?
Bereitstellen: Containerisieren Sie Ihre Anwendung und definieren Sie die Ressourcenanforderungen.
Konfigurieren: Wählen Sie Ihre gewünschten GPU-Ressourcen und Bereitstellungseinstellungen.
Starten: Initiieren Sie Ihren Workload im verteilten GPU-Netzwerk.
Überwachen: Verfolgen Sie Leistung und Kosten über das Salad-Dashboard.
Skalieren: Passen Sie Ressourcen dynamisch an die Echtzeitnachfrage an.
Salad Distributed GPU Cloud's Anwendungsfälle
- KI-Inferenz
- Text-zu-Bild-Generierung
- Text-zu-Sprache
- Sprache-zu-Text
- Computer Vision
- Sprachmodelle
- Batch-Verarbeitung
- HPC-Workloads
- Rendering