Beschreibung
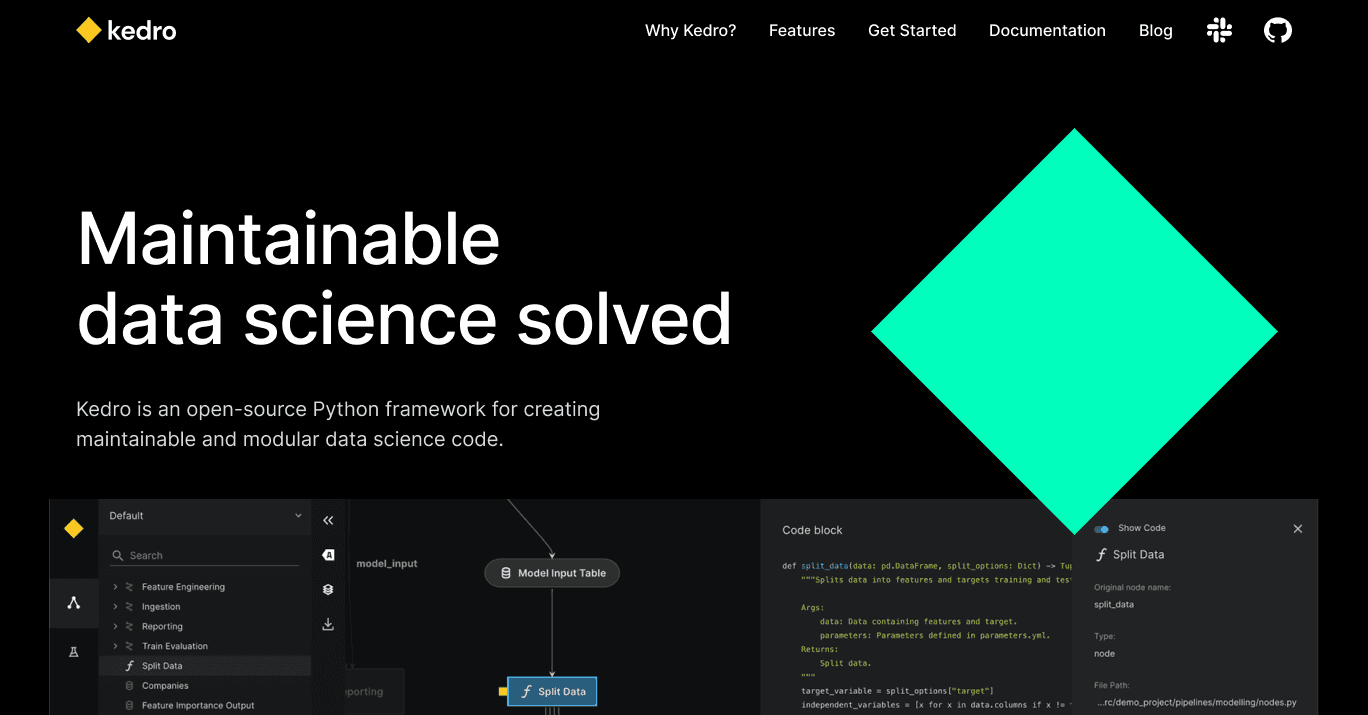
Kedro ist ein Open-Source-Python-Framework, das die Erstellung von reproduzierbarem, wartbarem und modularen Code für Datenengineering und Data Science erleichtert. Es wurde entwickelt, um Datenprofis dabei zu helfen, bessere Datenpipelines zu erstellen, indem bewährte Praktiken der Softwareentwicklung angewendet werden. Kedro unterstützt die Entwicklung von Datenpipelines, die sowohl robust als auch skalierbar sind, was es zu einer idealen Wahl für Dateningenieure und -wissenschaftler macht, die komplexe Datenworkflows verwalten müssen.
Das Framework bietet eine Reihe von Funktionen, einschließlich der Möglichkeit, Daten- und Machine-Learning-Pipelines durch Kedro-Viz zu visualisieren, ein Tool, das es Benutzern ermöglicht, Experimente zu verfolgen und den Datenfluss innerhalb ihrer Projekte zu verstehen. Kedro bietet auch eine Reihe von Startern, die vordefinierte Vorlagen sind und den Benutzern helfen, neue Projekte schnell mit einer standardisierten Struktur einzurichten.
Kedro ist kompatibel mit macOS, Linux und Windows und erfordert Python 3.10 oder höher. Es integriert sich mit verschiedenen Tools und Plattformen, einschließlich Git für die Versionskontrolle und Conda für das Management von Umgebungen. Das Framework unterstützt mehrere Python-Paketierungstools wie Poetry und PDM, sodass Benutzer Abhängigkeiten effektiv verwalten können.
Die Kedro-Community ist aktiv auf Plattformen wie Slack und GitHub, wo Benutzer Ideen austauschen, Fragen stellen und zur Entwicklung des Projekts beitragen können. Die Dokumentation von Kedro umfasst umfassende Anleitungen und Tutorials, um Benutzern den Einstieg zu erleichtern und ihre Projekte zu optimieren.
Insgesamt ist Kedro ein leistungsstarkes Tool für Datenprofis, die die Qualität und Wartbarkeit ihrer Datenpipelines verbessern möchten. Sein Fokus auf bewährte Praktiken und modulare Gestaltung macht es zu einem wertvollen Asset für das Management von Datenprojekten jeder Größe.
Kedro Framework's Kernfunktionen
Open-Source-Python-Framework
Reproduzierbarer und wartbarer Code
Modulares Datenengineering
Entwicklung von Data-Science-Pipelines
Kedro-Viz zur Visualisierung
Vordefinierte Projektstarter
Plattformübergreifende Kompatibilität
Aktive Community-Unterstützung
Wie verwendet man Kedro Framework?
Installieren: Kedro mit Python 3.10+ einrichten
Erstellen: Starter verwenden, um Projekte zu initiieren
Entwickeln: Datenpipelines unter Verwendung bewährter Praktiken erstellen
Visualisieren: Kedro-Viz verwenden, um Experimente zu verfolgen
Kedro Framework's Anwendungsfälle
- Entwicklung von Datenpipelines
- Machine-Learning-Workflows
- Projektvorlagen
- Datenvisualisierung
- Plattformübergreifende Entwicklung