Beschreibung
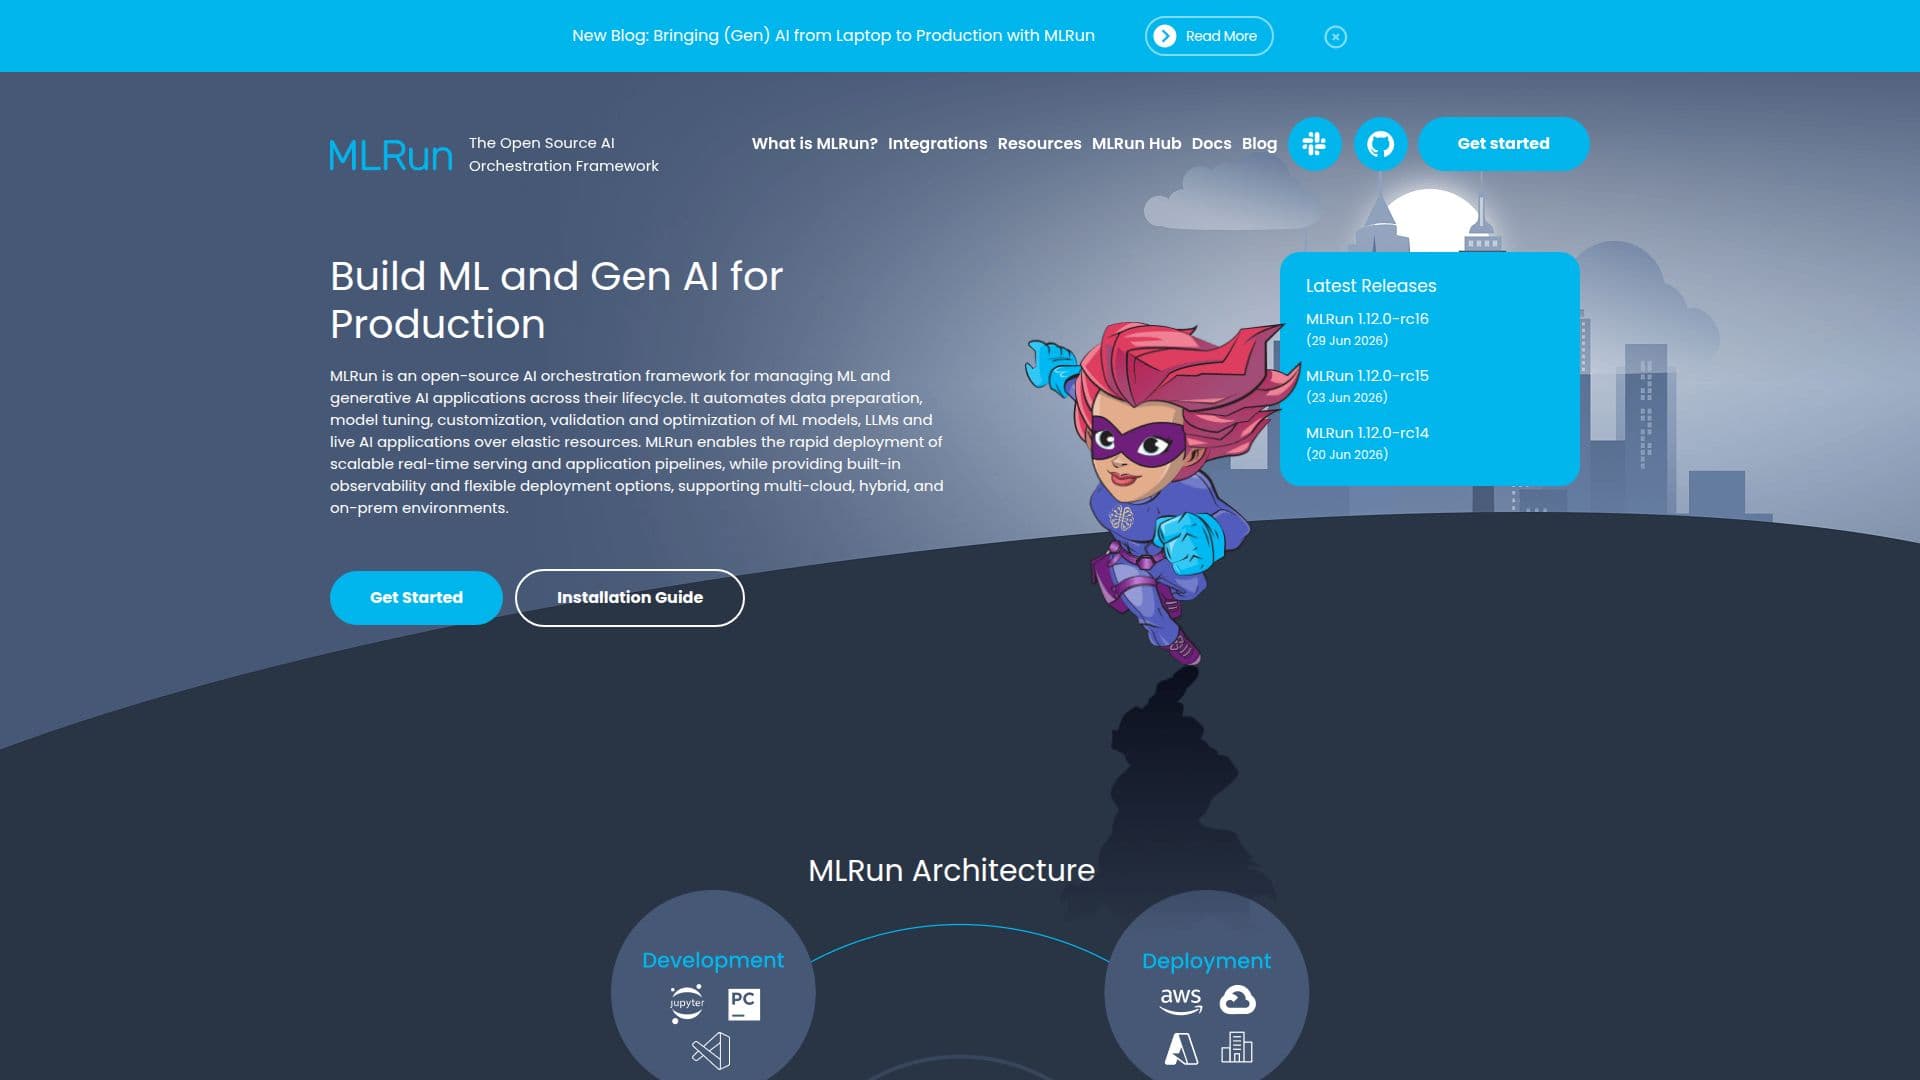
MLRun ist ein Open-Source-AI-Orchestrierungsframework, das entwickelt wurde, um maschinelles Lernen (ML) und generative AI-Anwendungen über ihren gesamten Lebenszyklus zu verwalten. Es bietet einen integrativen Ansatz zur Optimierung von ML-Pipelines von den frühen Entwicklungsphasen bis hin zum Produktionsmanagement. MLRun automatisiert verschiedene Prozesse, einschließlich Datenvorbereitung, Modellanpassung, Anpassung, Validierung und Optimierung von ML-Modellen und Live-AI-Anwendungen über elastische Ressourcen.
Die Plattform ermöglicht eine schnelle Bereitstellung skalierbarer Echtzeit-Servierung und Anwendungs-Pipelines und bietet integrierte Beobachtbarkeit sowie flexible Bereitstellungsoptionen. Sie unterstützt Multi-Cloud-, Hybrid- und On-Prem-Umgebungen, sodass Benutzer Workloads überall bereitstellen können. Die Architektur von MLRun ist offen und unterstützt alle gängigen Frameworks, verwaltete ML-Dienste und LLMs und integriert sich mit jedem Drittanbieterdienst.
MLRun reduziert den Ingenieureinsatz, indem es AI-Pipelines von Ende zu Ende automatisiert, von Training und Test bis hin zur Bereitstellung und Verwaltung in der Produktion. Es ermöglicht die schnelle Bereitstellung von Echtzeit-Servierung und Anwendungs-Pipelines und automatisiert die Modelltrainings- und Testpipelines mit CI/CD. Die Plattform generiert auch automatisch Batch- und Echtzeit-Datenpipelines und reduziert die Rechenkosten durch optimierte Ressourcennutzung und nahtloses Skalieren von Workloads.
Zusammenarbeit ist ein zentrales Merkmal von MLRun, da es einen einheitlichen Technologiestack für Dateningenieure, Datenwissenschaftler und Maschinenlern-Ingenieure bereitstellt. Dies hilft, Silos abzubauen, Wiederverwendung und Teilen zwischen Rollen zu fördern und die Wartungszeiten zu reduzieren. MLRun legt auch Wert auf verantwortungsvolle AI mit minimalem Ingenieureinsatz, indem es Daten, Herkunft, Experimente und Modelle automatisch verfolgt und Modelle, Ressourcen und Daten in Echtzeit überwacht.
Die Plattform bietet eine End-to-End-Beobachtbarkeit, die eine qualitativ hochwertige Governance und Reproduzierbarkeit ermöglicht. Sie verfügt über eine serverlose Anwendungsruntime zur Bereitstellung von LLMs mit einer produktionsorientierten Denkweise und umfasst ein integriertes LLM-Gateway zur Operationalisierung und Überwachung von LLMs, das Kostenoptimierung, Versionierung und beobachtbarkeit auf Anwendungsfall-Ebene ermöglicht.
MLRun's Kernfunktionen
Open-Source-AI-Orchestrierungsframework
Automatisiert Datenvorbereitung und Modellanpassung
Unterstützt Multi-Cloud-, Hybrid- und On-Prem-Umgebungen
Schnelle Bereitstellung skalierbarer Echtzeit-Servierung
Integrierte Beobachtbarkeit und flexible Bereitstellungsoptionen
End-to-End-AI-Pipeline-Automatisierung
Optimiert Ressourcennutzung zur Reduzierung der Rechenkosten
Einheitlicher Technologiestack für Zusammenarbeit
Wie verwendet man MLRun?
Konfigurieren: Richten Sie Ihre Client-Umgebung ein
Verwenden: Entwickeln und bereitstellen von AI-Anwendungen
Optimieren: Überwachen und Anpassen der Ressourcennutzung
Bereitstellen: Verwenden Sie serverlose Funktionen für die Echtzeit-Servierung
MLRun's Anwendungsfälle
- Echtzeit-Servierung
- Modellanpassung
- Datenvorbereitung
- Zusammenarbeit
- Kostenoptimierung