Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

Flide

Flide ist eine leistungsstarke Inferenzinfrastruktur, die für Jev-Stil Entscheidungsmodelle entwickelt wurde. Sie beschleunigt die Entscheidungsinferenz, indem sie einen einzelnen Zustand in alle seine Fragen innerhalb eines Vorwärtsdurchlaufs aufteilt, wodurch sichergestellt wird, dass jede Frage eine Antwort erhält, die identisch ist mit der, die sie erhalten würde, wenn sie allein gestellt würde. Dieser Ansatz steigert den Durchsatz erheblich und erhält eine hohe Genauigkeit für komplexe Entscheidungsprozesse.

URL besuchen
Teilen
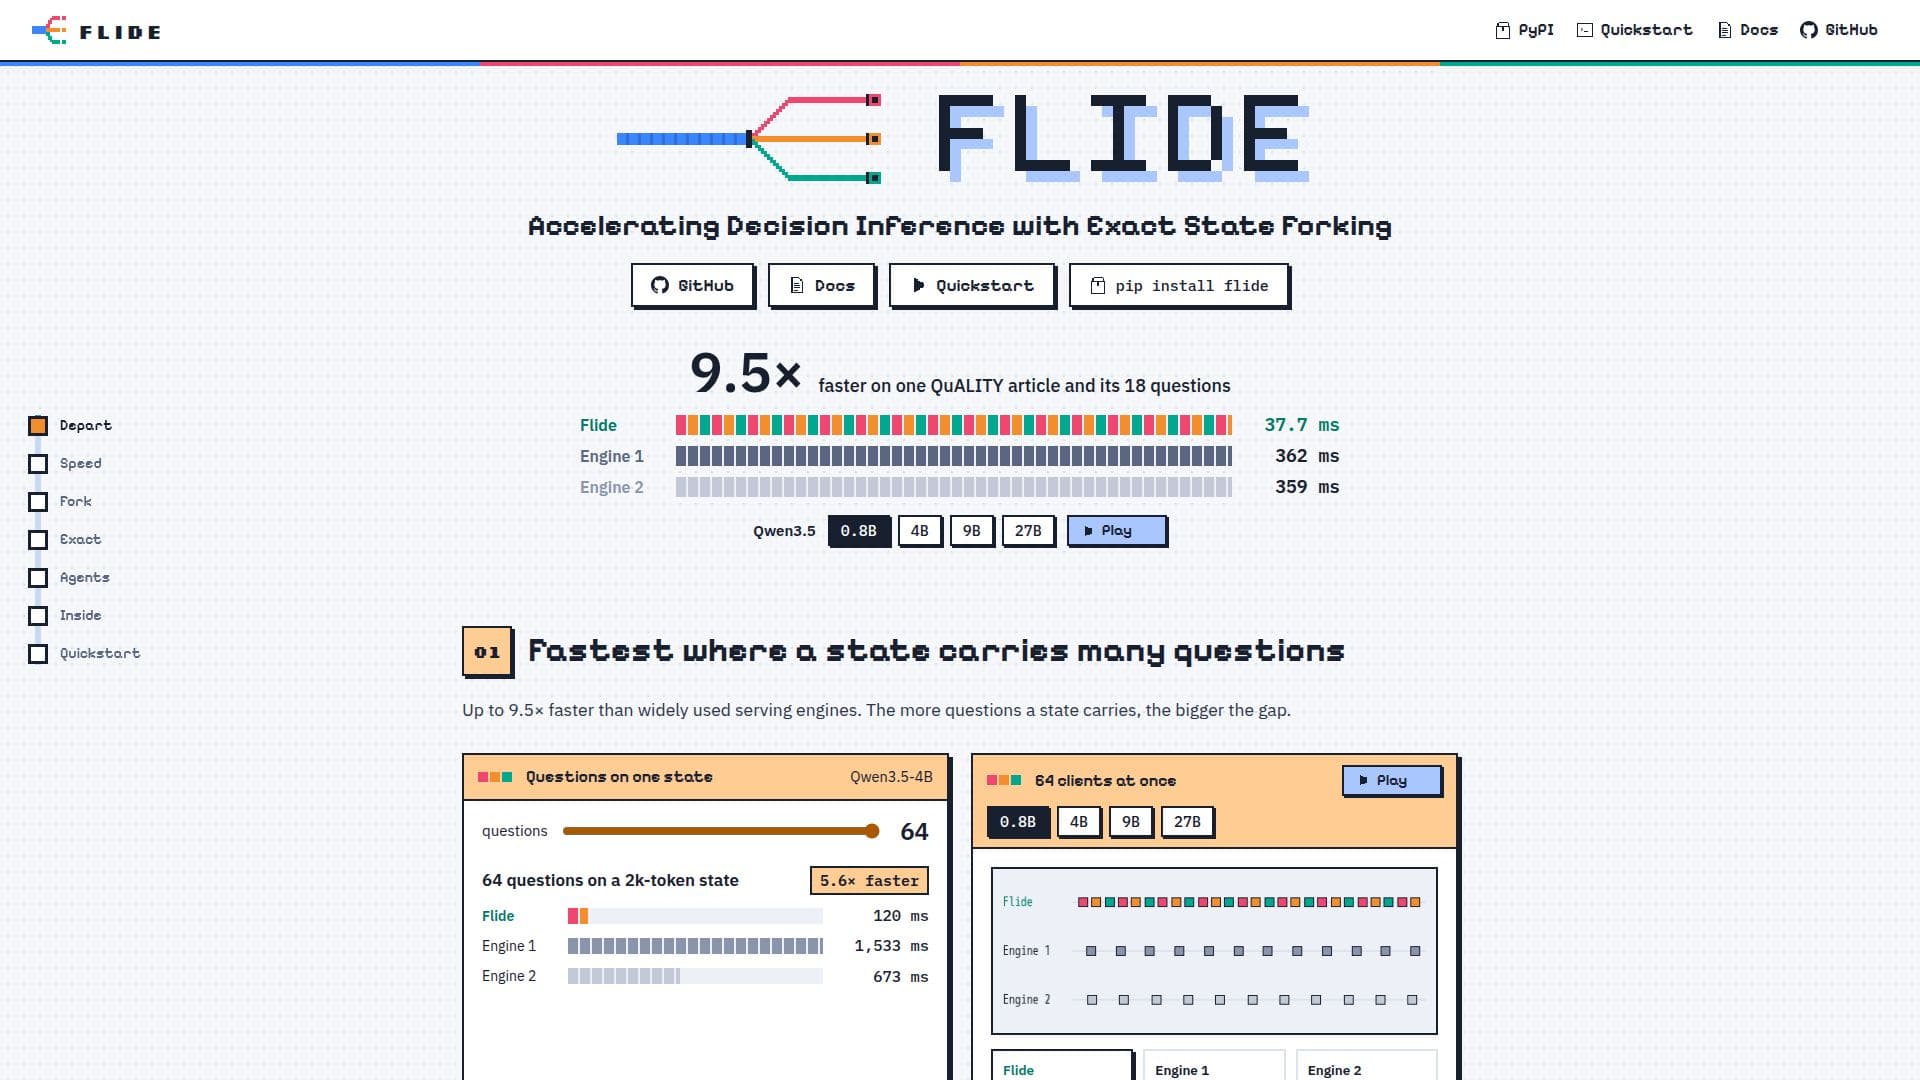
Screenshot von Flide

Flide ist eine fortschrittliche Inferenzinfrastruktur, die speziell entwickelt wurde, um Jev-Stil Entscheidungsmodelle zu beschleunigen. Die zentrale Innovation besteht in der Fähigkeit, exakte Zustandsaufteilungen durchzuführen, sodass ein einzelner Eingabestatus für mehrere Fragen in einem Vorwärtsdurchlauf verarbeitet werden kann. Das bedeutet, dass der Zustand nur einmal gelesen und dann effizient aufgeteilt wird, wodurch sichergestellt wird, dass jede Frage die präzise Antwort erhält, die sie erhalten würde, wenn sie isoliert gestellt würde.

Weiterlesen

Diese einzigartige Architektur bietet erhebliche Leistungsgewinne, wobei Flide eine bis zu 9,5-mal schnellere Inferenz im Vergleich zu weit verbreiteten Serving-Engines wie vLLM und SGLang demonstriert. Der Leistungsunterschied wird noch deutlicher, wenn die Anzahl der Fragen, die mit einem bestimmten Zustand verbunden sind, zunimmt. Beispielsweise erreicht Flide mit 64 Fragen auf einem 2k-Token-Zustand eine 9,5-fache Beschleunigung und einen 2,2-fachen höheren Durchsatz mit 64 Clients.

Neben der Geschwindigkeit priorisiert Flide die Genauigkeit und bleibt innerhalb von 1,1 Punkten eines float32-Referenzwerts, was es zu einer der genauesten Engines macht, die verfügbar sind. Es unterstützt eine Vielzahl von Modellen, einschließlich Chat-Modellen, die auf Qwen3.5 und Gemma 4 basieren, sowie OneJev-Modellen. Flide verarbeitet auch hybride Modelle, bei denen Gated DeltaNet-Schichten sicherstellen, dass jede Frage vom exakten Zustand des gemeinsamen Kontexts ausgeht. Das System bietet eine `--batch-invariant`-Option, die garantiert, dass eine Anfrage die gleichen Bits unabhängig davon liefert, wie sie gebündelt ist.

Die Installation erfolgt unkompliziert über pip, und es unterstützt das Serving mit vorgefertigten Kernen für verschiedene NVIDIA GPUs, einschließlich A40, A10, RTX 30, H100 und H200. Flide bietet die gleiche `/v1/systemone` API wie vLLM und SGLang und liefert Wahrscheinlichkeiten für jede Option in der Antwort. Es unterstützt multimodale Eingaben, einschließlich Text, Bilder und Videos, abhängig vom zugrunde liegenden Modell. Funktionen wie FP8-Quantisierung für Qwen3.5 auf Ada, Hopper und Blackwell GPUs sowie ein Sitzungs-Cache zum Fortsetzen von Agentenzuständen erweitern seine Fähigkeiten.

  • KategorieMLOps & Modell-Deployment
  • BereitstellungSelbst gehostet
  • PlattformenWeb

  • Exakte Zustandsaufteilung: Verarbeitet einen Zustand für alle Fragen in einem einzigen Vorwärtsdurchlauf.

  • Beschleunigte Inferenz: Bis zu 9,5-mal schneller als andere Serving-Engines.

  • Hoher Durchsatz: Erreicht einen 2,2-fachen Durchsatz mit 64 Clients bei bestimmten Benchmarks.

  • Nähe zur Float32-Referenz: Bleibt innerhalb von 1,1 Punkten einer float32-Referenz für Genauigkeit.

  • Batch-Invarianz: Gewährleistet konsistente Ergebnisse unabhängig von der Bündelung mit `--batch-invariant`.

  • ForkAttention-Mechanismus: Jede Frage liest ihren Zustand an Ort und Stelle, als ob sie allein gestellt würde.

  • Genau bei hybriden Modellen: Unterstützt Gated DeltaNet-Schichten für präzise Kontextverarbeitung.

  • Einheitliche Stream-Verarbeitung: Führt Anfragen als einen einzigen Token-Stream aus, der von CUDA-Grafiken wiedergegeben wird.

  • vLLM/SGLang-kompatible API: Verwendet den `/v1/systemone` API-Standard.

  • Vorgefertigte Kerne: Optimiert für NVIDIA A40, A10, RTX 30, H100 und H200 GPUs.

  • Modell-Rückgrate: Unterstützt Qwen3.5 (0,8B, 2B, 4B, 9B, 27B) und Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B).

  • Multimodale Eingaben: Verarbeitet Text-, Bild- und Videoeingaben.

  • FP8-Quantisierung: Führt Qwen3.5 in FP8 auf Ada, Hopper und Blackwell GPUs aus.

  • Sitzungs-Cache: Beibehaltung früherer Zustände für Agenten zum Fortsetzen (z.B. `--session-cache-gb 40`).

  • Frontend-Prozesse: Unterstützt das Ausführen von HTTP, Rendering und Tokenisierung in separaten Prozessen für viele Clients.

  1. Flide installieren: Verwenden Sie pip, um das Flide-Paket zu installieren.

  2. Server starten: Führen Sie `flide serve` aus, um den Inferenzserver zu starten, optional mit Angabe von `--host`.

  3. Modelle konfigurieren: Servieren Sie Chat-Modelle wie Qwen3.5 oder Gemma 4 direkt oder kombinieren Sie Open-Jev-Adapter.

  4. Anfragen senden: Interagieren Sie mit dem Server über die `/v1/systemone` API, um Zustände und Fragen zu senden.

  5. Multimodale Eingaben verarbeiten: Fügen Sie Bildpfade im Zustand hinzu und senden Sie Medien für Modelle, die Bilder unterstützen.

  • Beschleunigte Entscheidungsmodelle
  • Multimodale Inferenz
  • Konsistente Batch-Verarbeitung
  • Agentenzustandsverwaltung
  • Hochleistungs-LLM-Serving
  • Forschung & Entwicklung

Flide Bewertungen

Wird geladen...

Beliebte KI-Tools wie Flide

vLLM

KI-Apps

vLLM ist eine leistungsstarke und speichereffiziente Inferenz- und Bereitstellungs-Engine für große Sprachmodelle (LLMs). Es ermöglicht eine schnellere Bereitstellung von…

MLOps & Modell-Deployment
Tool ansehen

KI-Apps

Leistungsstarke und speichereffiziente Inferenz- und Bereitstellungs-Engine für große Sprachmodelle (LLMs). Es ermöglicht eine schnellere Bereitstellung von…vLLM ist eine leistungsstarke und speichereffiziente Inferenz- und Bereitstellungs-Engine für große Sprachmodelle (LLMs). Es ermöglicht eine schnellere Bereitstellung von…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

Ein Hochgeschwindigkeits-Anbieter für KI-Inferenz, der Modelle auf speziell entwickelter ASIC-Infrastruktur über eine OpenAI-kompatible API bereitstellt und eine geringe Zeit bis…

MLOps & Modell-Deployment
Tool ansehen

Ein Hochgeschwindigkeits-Anbieter für KI-Inferenz, der Modelle auf speziell entwickelter ASIC-Infrastruktur über eine OpenAI-kompatible API bereitstellt und eine geringe Zeit bis…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

Inference.net bietet Infrastruktur für KI-native Teams, um KI-Workloads auszuführen, zu überwachen und zu optimieren. Es bietet blitzschnelle Inferenz für Open-Source-,…

MLOps & Modell-Deployment

Platz 78 für Feinabstimmung von KI-Modellen

Tool ansehen

Bietet Infrastruktur für KI-native Teams, um KI-Workloads auszuführen, zu überwachen und zu optimieren. Es bietet blitzschnelle Inferenz für Open-Source-,…Inference.net bietet Infrastruktur für KI-native Teams, um KI-Workloads auszuführen, zu überwachen und zu optimieren. Es bietet blitzschnelle Inferenz für Open-Source-,…

MLOps & Modell-Deployment
Platz 78 für Feinabstimmung von KI-Modellen

Jev AI

KI-Apps

Jev AI ist ein Entscheidungsintelligenz-Tool für Software-Teams, das ein schnelles KI-Modell ohne Warteliste bietet. Es verwandelt reale Zustände in strukturierte,…

KI-DevOps- & -Cloud-Tools
Tool ansehen

KI-Apps

Entscheidungsintelligenz-Tool für Software-Teams, das ein schnelles KI-Modell ohne Warteliste bietet. Es verwandelt reale Zustände in strukturierte,…Jev AI ist ein Entscheidungsintelligenz-Tool für Software-Teams, das ein schnelles KI-Modell ohne Warteliste bietet. Es verwandelt reale Zustände in strukturierte,…

KI-DevOps- & -Cloud-Tools
Top 250 KI-Apps ansehen

JevModel

KI-Apps

JevModel ist eine Plattform, die das Jev-Modell für strukturierte KI-Entscheidungen nutzt und Choice-, Score- und Noul-Ausgaben bietet. Sie ermöglicht es Benutzern, Texte oder…

Machine-Learning-Plattformen
Tool ansehen

KI-Apps

Plattform, die das Jev-Modell für strukturierte KI-Entscheidungen nutzt und Choice-, Score- und Noul-Ausgaben bietet. Sie ermöglicht es Benutzern, Texte oder…JevModel ist eine Plattform, die das Jev-Modell für strukturierte KI-Entscheidungen nutzt und Choice-, Score- und Noul-Ausgaben bietet. Sie ermöglicht es Benutzern, Texte oder…

Machine-Learning-Plattformen
Top 250 KI-Apps ansehen

Morph

KI-Apps

Eine Inferenzplattform, die für Codierungsagenten entwickelt wurde und schnelle Frontier-Modelle sowie spezialisierte Modelle für Codesuche, Anwendung von Änderungen,…

MLOps & Modell-Deployment
Tool ansehen

KI-Apps

Eine Inferenzplattform, die für Codierungsagenten entwickelt wurde und schnelle Frontier-Modelle sowie spezialisierte Modelle für Codesuche, Anwendung von Änderungen,…

MLOps & Modell-Deployment
Top 250 KI-Apps ansehen

vLLM

KI-GitHub-Repos

vllm-project/vllm ist eine hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…

MLOps & Modell-Deployment

Platz 23 in KI-GitHub-Repos

Tool ansehen

KI-GitHub-Repos

Hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…vllm-project/vllm ist eine hochdurchsatz- und speichereffiziente Inferenz- und Servier-Engine, die für große Sprachmodelle (LLMs) entwickelt wurde. Sie optimiert die Leistung bei…

EmpfohlenMLOps & Modell-Deployment
Platz 23 in KI-GitHub-Repos

trnrt

KI-GitHub-Repos

trnrt ist eine Open-Source-LLM-Inferenz-Engine, die für AWS Trainium entwickelt wurde, bietet NKI-Megakernels und unterstützt einen Kontext von 1M-Token. Entwickelt von…

MLOps & Modell-Deployment

Platz 160 in MLOps & Modell-Deployment

Tool ansehen

KI-GitHub-Repos

Open-Source-LLM-Inferenz-Engine, die für AWS Trainium entwickelt wurde, bietet NKI-Megakernels und unterstützt einen Kontext von 1M-Token. Entwickelt von…trnrt ist eine Open-Source-LLM-Inferenz-Engine, die für AWS Trainium entwickelt wurde, bietet NKI-Megakernels und unterstützt einen Kontext von 1M-Token. Entwickelt von…

MLOps & Modell-Deployment
Platz 160 in MLOps & Modell-Deployment
1 von 8