Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

evalship

evalship bietet Qualitätskontrolle für LLM-Bewertungen, identifiziert Mängel und optimiert Eingabeaufforderungen und Modelle. Es integriert sich in bestehende Bewertungsrahmen, kommentiert Pull-Requests mit detaillierten Aufschlüsselungen, was kaputt gegangen ist und warum, und hilft sicherzustellen, dass KI-Aufrufe gründlich getestet werden. Die Plattform zielt darauf ab, Ihre LLM-Bewertungen im Autopilot-Modus zu betreiben, um Zuverlässigkeit und Leistung zu verbessern.

URL besuchen
Teilen
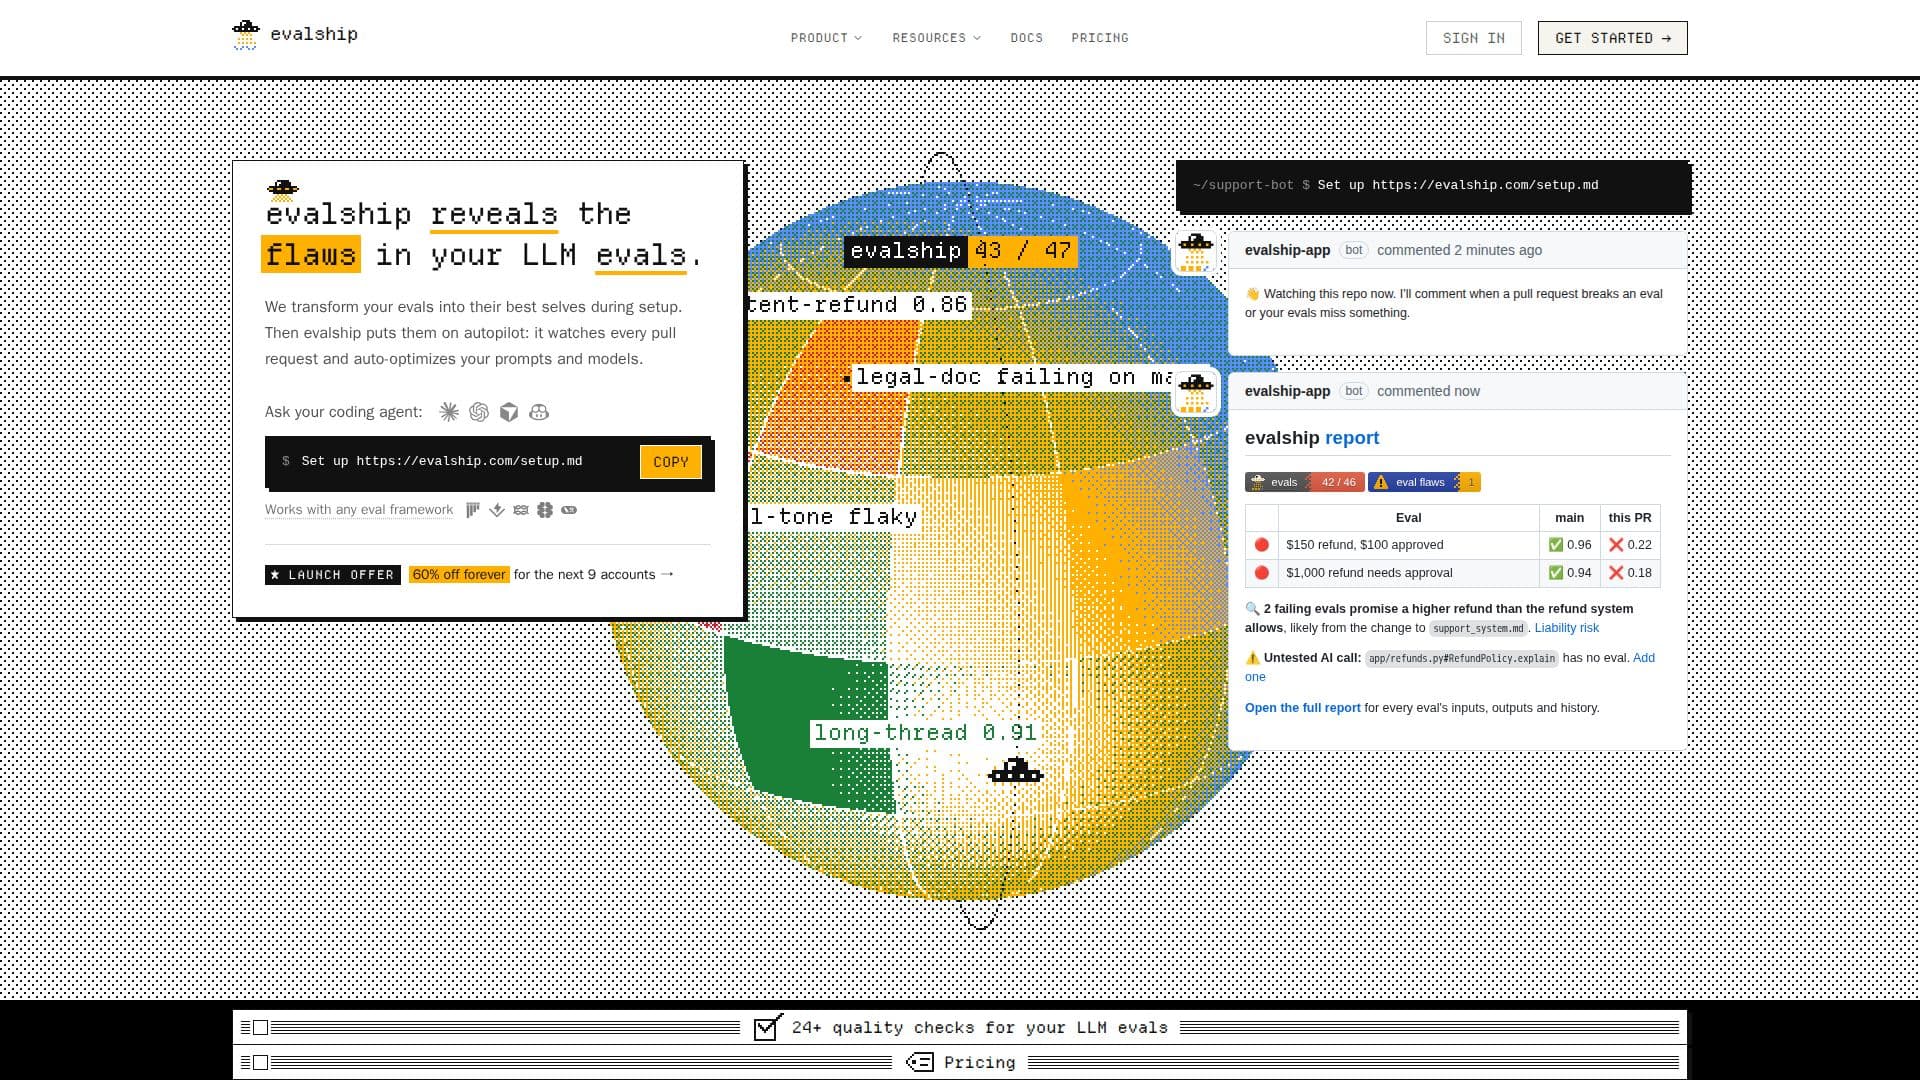
Screenshot von evalship

evalship bietet eine umfassende Qualitätskontrolllösung, die speziell für Bewertungen von großen Sprachmodellen (LLM) entwickelt wurde. Es integriert sich direkt in Ihren GitHub-Workflow und fungiert als wachsamer Wächter für Ihren LLM-Entwicklungsprozess. Der Hauptzweck von evalship besteht darin, Mängel in Ihren Bewertungs-Setups zu identifizieren und zu beheben, um sicherzustellen, dass Ihre LLMs wie erwartet funktionieren und keine Rückschritte einführen.

Weiterlesen

Nach der Einrichtung überprüft evalship gründlich Ihre bestehenden Bewerter, Richter und Eingabeaufforderungen, um Schwächen wie Bewertungen, die fälschlicherweise bestehen, oder Regeln, die keine angemessene Testabdeckung haben, zu identifizieren. Es überwacht dann jeden Pull-Request und bietet sofortiges Feedback dazu, was kaputt gegangen ist, warum es kaputt gegangen ist und was die wahrscheinliche Ursache ist. Dazu gehört das Kennzeichnen ungetesteter KI-Aufrufe und das Trennen echter Rückschritte von unzuverlässigen Bewertungsergebnissen durch die Analyse der historischen Leistung auf Ihrem Standardbranch.

Die Plattform funktioniert nahtlos mit verschiedenen Bewertungsrahmen, einschließlich solcher, die JUnit XML, promptfoo JSON oder evalship JSON erzeugen, wie pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust und LangSmith. Es führt Ihre Bewertungen nicht direkt aus; stattdessen führt Ihr GitHub Actions-Workflow oder Ihr Codierungsagent sie mit Ihren API-Schlüsseln aus, und evalship verarbeitet die Ergebnisse.

Über die Identifizierung von Problemen hinaus hilft evalship, Ihre Eingabeaufforderungen und Modelle zu optimieren. Über Ihren Codierungsagenten testet es verschiedene Änderungen auf Ihrem Computer, wie kostengünstigere Modelle oder klarere Regeln, und berichtet, welche Änderungen statistisch signifikante Verbesserungen bringen. Dies ermöglicht es Teams, datengestützte Entscheidungen zur Verbesserung der Modellleistung und Kosteneffizienz zu treffen. evalship bietet auch wöchentliche Berichte, die die Bewertungsleistung zusammenfassen und kritische Probleme hervorheben, die erkannt werden, bevor sie in die Produktion gelangen.

Die Preisgestaltung umfasst eine kostenlose Stufe für öffentliche Repositories und ein privates Repository mit einem Benutzer, das 100 PR-Analysen und 30 Tage Bewertungsverlauf bietet. Bezahlte Pläne (Team, Pro, Business) bieten mehr Benutzer, private Repositories, PR-Analysen und längeren Bewertungsverlauf, mit Optionen für monatliche oder jährliche Abrechnung. Ein Einführungsangebot bietet erhebliche Rabatte für frühe Anwender. evalship gewährleistet Sicherheit, indem es Ihren Quellcode oder Ihre API-Schlüssel nicht speichert, sondern nur Diffs und Bewertungsergebnisse verarbeitet.

  • KategorieKI-Code-Review & -Testing
  • PreismodellFreemium
  • BereitstellungCloud
  • PlattformenWeb

  • Identifiziert Mängel in LLM-Bewertungen während der Einrichtung

  • Kommentiert jeden Pull-Request mit detaillierter Aufschlüsselung der Bewertungsfehler

  • Optimiert automatisch Eingabeaufforderungen und Modelle basierend auf Leistungsdaten

  • Funktioniert mit jedem bestehenden Bewertungsrahmen (JUnit XML, promptfoo, evalship JSON)

  • Bietet über 24 Qualitätsprüfungen für LLM-Bewertungen

  • Trennt Rückschritte von unzuverlässigen Bewertungen mithilfe historischer Daten

  • Erkennt ungetestete KI-Aufrufe in Pull-Requests

  • Blockiert Zusammenführungen, die Bewertungsregeln verletzen (konfigurierbar)

  • Hebt Pull-Requests auf, sobald Probleme behoben sind

  • Versendet wöchentliche Bewertungsberichte, die Leistung und Probleme zusammenfassen

  • Unterstützt Monorepos und mehrere Bewertungs-Workflows

  • Integriert sich ohne Wechsel in Langfuse, Braintrust und LangSmith

  • Bietet eine kostenlose Überprüfung der Bewertungen bei der Einrichtung

  • Ermöglicht Codierungsagenten, Änderungen zu überprüfen, bevor sie Pull-Requests öffnen

  • Gewährleistet Sicherheit, indem kein Quellcode oder API-Schlüssel gespeichert wird

  1. Einrichten: Verbinden Sie Ihr GitHub-Repository und bitten Sie Ihren Codierungsagenten, evalship einzurichten, der Ihre Bewertungen überprüft und einen Einrichtung-Pull-Request erstellt.

  2. Überwachen von Pull-Requests: evalship überwacht automatisch jeden Pull-Request und kommentiert Änderungen, die Bewertungen brechen oder ungetestete KI-Aufrufe einführen.

  3. Berichte überprüfen: Greifen Sie auf detaillierte Berichte zu den Eingaben, Ausgaben und dem Verlauf jeder Bewertung zu, um zu verstehen, was kaputt gegangen ist und warum.

  4. Optimieren: Nutzen Sie die Optimierungsfunktion von evalship, um Änderungen an Eingabeaufforderungen und Modellen mit Ihrem Codierungsagenten zu testen und Verbesserungen über den Zufall hinaus zu identifizieren.

  5. Berichte erhalten: Erhalten Sie wöchentliche E-Mail-Berichte, die die Bewertungsleistung zusammenfassen und kritische Probleme hervorheben, die vor der Zusammenführung erkannt wurden.

  • Qualitätskontrolle von LLM-Bewertungen
  • Automatisierte Pull-Request-Überprüfung
  • Optimierung von Eingabeaufforderungen und Modellen
  • Verhinderung von Rückschritten
  • Erkennung ungetesteter KI-Aufrufe
  • Management von unzuverlässigen Bewertungen
  • Einhaltung und Risikominderung
  • Verbesserung des Entwickler-Workflows
evalship Bewertungen

Wird geladen...

Beliebte KI-Tools wie evalship

LangWatch

KI-Apps

LangWatch ist eine Plattform für das Testen von KI-Agenten, die Evaluierung von LLMs und Observability. Sie ermöglicht Entwicklern, reale Szenarien zu simulieren, Regressionen zu…

MLOps & Modell-Deployment

Platz 14 in Prompt-Engineering-Tools

Tool ansehen

KI-Apps

Plattform für das Testen von KI-Agenten, die Evaluierung von LLMs und Observability. Sie ermöglicht Entwicklern, reale Szenarien zu simulieren, Regressionen zu…LangWatch ist eine Plattform für das Testen von KI-Agenten, die Evaluierung von LLMs und Observability. Sie ermöglicht Entwicklern, reale Szenarien zu simulieren, Regressionen zu…

EmpfohlenMLOps & Modell-Deployment
Platz 14 in Prompt-Engineering-Tools

EvalCore

KI-Apps

EvalCore bietet Snapshot-Tests für das Verhalten von KI und ermöglicht es Ihnen, aufzuzeichnen, wie Ihre LLM-Anwendung funktioniert, und diese Aufzeichnung bei jeder Änderung in…

KI-Code-Review & -Testing
Tool ansehen

KI-Apps

Bietet Snapshot-Tests für das Verhalten von KI und ermöglicht es Ihnen, aufzuzeichnen, wie Ihre LLM-Anwendung funktioniert, und diese Aufzeichnung bei jeder Änderung in…EvalCore bietet Snapshot-Tests für das Verhalten von KI und ermöglicht es Ihnen, aufzuzeichnen, wie Ihre LLM-Anwendung funktioniert, und diese Aufzeichnung bei jeder Änderung in…

KI-Code-Review & -Testing
Top 250 KI-Apps ansehen

Confident AI bietet eine umfassende Plattform zur Bewertung von LLMs, die KI-Systeme benchmarkt, Eingabeaufforderungen und Modelle vergleicht und Regressionen mithilfe von…

Machine-Learning-Plattformen

Platz 47 für Überwachung von KI-Modellen

Tool ansehen

Bietet eine umfassende Plattform zur Bewertung von LLMs, die KI-Systeme benchmarkt, Eingabeaufforderungen und Modelle vergleicht und Regressionen mithilfe von…Confident AI bietet eine umfassende Plattform zur Bewertung von LLMs, die KI-Systeme benchmarkt, Eingabeaufforderungen und Modelle vergleicht und Regressionen mithilfe von…

Machine-Learning-Plattformen
Platz 47 für Überwachung von KI-Modellen

Evidently AI bietet Open-Source-Tools zur Bewertung und Überwachung von KI-Anwendungen. Es hilft sicherzustellen, dass KI-Systeme produktionsbereit sind, indem LLMs getestet und…

MLOps & Modell-Deployment

Platz 20 in MLOps & Modell-Deployment

Tool ansehen

Bietet Open-Source-Tools zur Bewertung und Überwachung von KI-Anwendungen. Es hilft sicherzustellen, dass KI-Systeme produktionsbereit sind, indem LLMs getestet und…Evidently AI bietet Open-Source-Tools zur Bewertung und Überwachung von KI-Anwendungen. Es hilft sicherzustellen, dass KI-Systeme produktionsbereit sind, indem LLMs getestet und…

MLOps & Modell-Deployment
Platz 20 in MLOps & Modell-Deployment

mabl

KI-Apps

mabl ist eine automatisierte Software-Testplattform, die Teams befähigt, Releases zu beschleunigen und die Softwarequalität sicherzustellen. Sie nutzt maschinelles Lernen und…

KI-Code-Review & -Testing

Platz 32 in KI-Code-Review & -Testing

Tool ansehen

KI-Apps

Automatisierte Software-Testplattform, die Teams befähigt, Releases zu beschleunigen und die Softwarequalität sicherzustellen. Sie nutzt maschinelles Lernen und…mabl ist eine automatisierte Software-Testplattform, die Teams befähigt, Releases zu beschleunigen und die Softwarequalität sicherzustellen. Sie nutzt maschinelles Lernen und…

KI-Code-Review & -Testing
Platz 32 in KI-Code-Review & -Testing

Giskard OSS

KI-GitHub-Repos

Giskard OSS ist eine Open-Source-Bibliothek zur Bewertung und Testung von LLM-Agenten. Sie bietet Werkzeuge zur Beurteilung und Verbesserung der Leistung von Sprachmodellen und…

KI-Code-Review & -Testing

Platz 111 in KI-GitHub-Repos

Tool ansehen

KI-GitHub-Repos

Open-Source-Bibliothek zur Bewertung und Testung von LLM-Agenten. Sie bietet Werkzeuge zur Beurteilung und Verbesserung der Leistung von Sprachmodellen und…Giskard OSS ist eine Open-Source-Bibliothek zur Bewertung und Testung von LLM-Agenten. Sie bietet Werkzeuge zur Beurteilung und Verbesserung der Leistung von Sprachmodellen und…

KI-Code-Review & -Testing
Platz 111 in KI-GitHub-Repos

Future AGI

KI-Apps

Future AGI ist eine Open-Source-Plattform zum Erstellen, Testen und Überwachen von KI-Agenten. Sie hilft, KI-Halluzinationen in Echtzeit mit Guardrails, umfassenden Auswertungen…

MLOps & Modell-Deployment

Platz 38 in MLOps & Modell-Deployment

Tool ansehen

KI-Apps

Open-Source-Plattform zum Erstellen, Testen und Überwachen von KI-Agenten. Sie hilft, KI-Halluzinationen in Echtzeit mit Guardrails, umfassenden Auswertungen…Future AGI ist eine Open-Source-Plattform zum Erstellen, Testen und Überwachen von KI-Agenten. Sie hilft, KI-Halluzinationen in Echtzeit mit Guardrails, umfassenden Auswertungen…

EmpfohlenMLOps & Modell-Deployment
Platz 38 in MLOps & Modell-Deployment

DeepEval

KI-GitHub-Repos

DeepEval ist ein Open-Source-Rahmenwerk, das zur Bewertung großer Sprachmodelle (LLMs) entwickelt wurde. Es ermöglicht Entwicklern, zur Verbesserung des Bewertungsprozesses…

MLOps & Modell-Deployment

Platz 91 in KI-GitHub-Repos

Tool ansehen

KI-GitHub-Repos

Open-Source-Rahmenwerk, das zur Bewertung großer Sprachmodelle (LLMs) entwickelt wurde. Es ermöglicht Entwicklern, zur Verbesserung des Bewertungsprozesses…DeepEval ist ein Open-Source-Rahmenwerk, das zur Bewertung großer Sprachmodelle (LLMs) entwickelt wurde. Es ermöglicht Entwicklern, zur Verbesserung des Bewertungsprozesses…

MLOps & Modell-Deployment
Platz 91 in KI-GitHub-Repos
1 von 8