Beschreibung
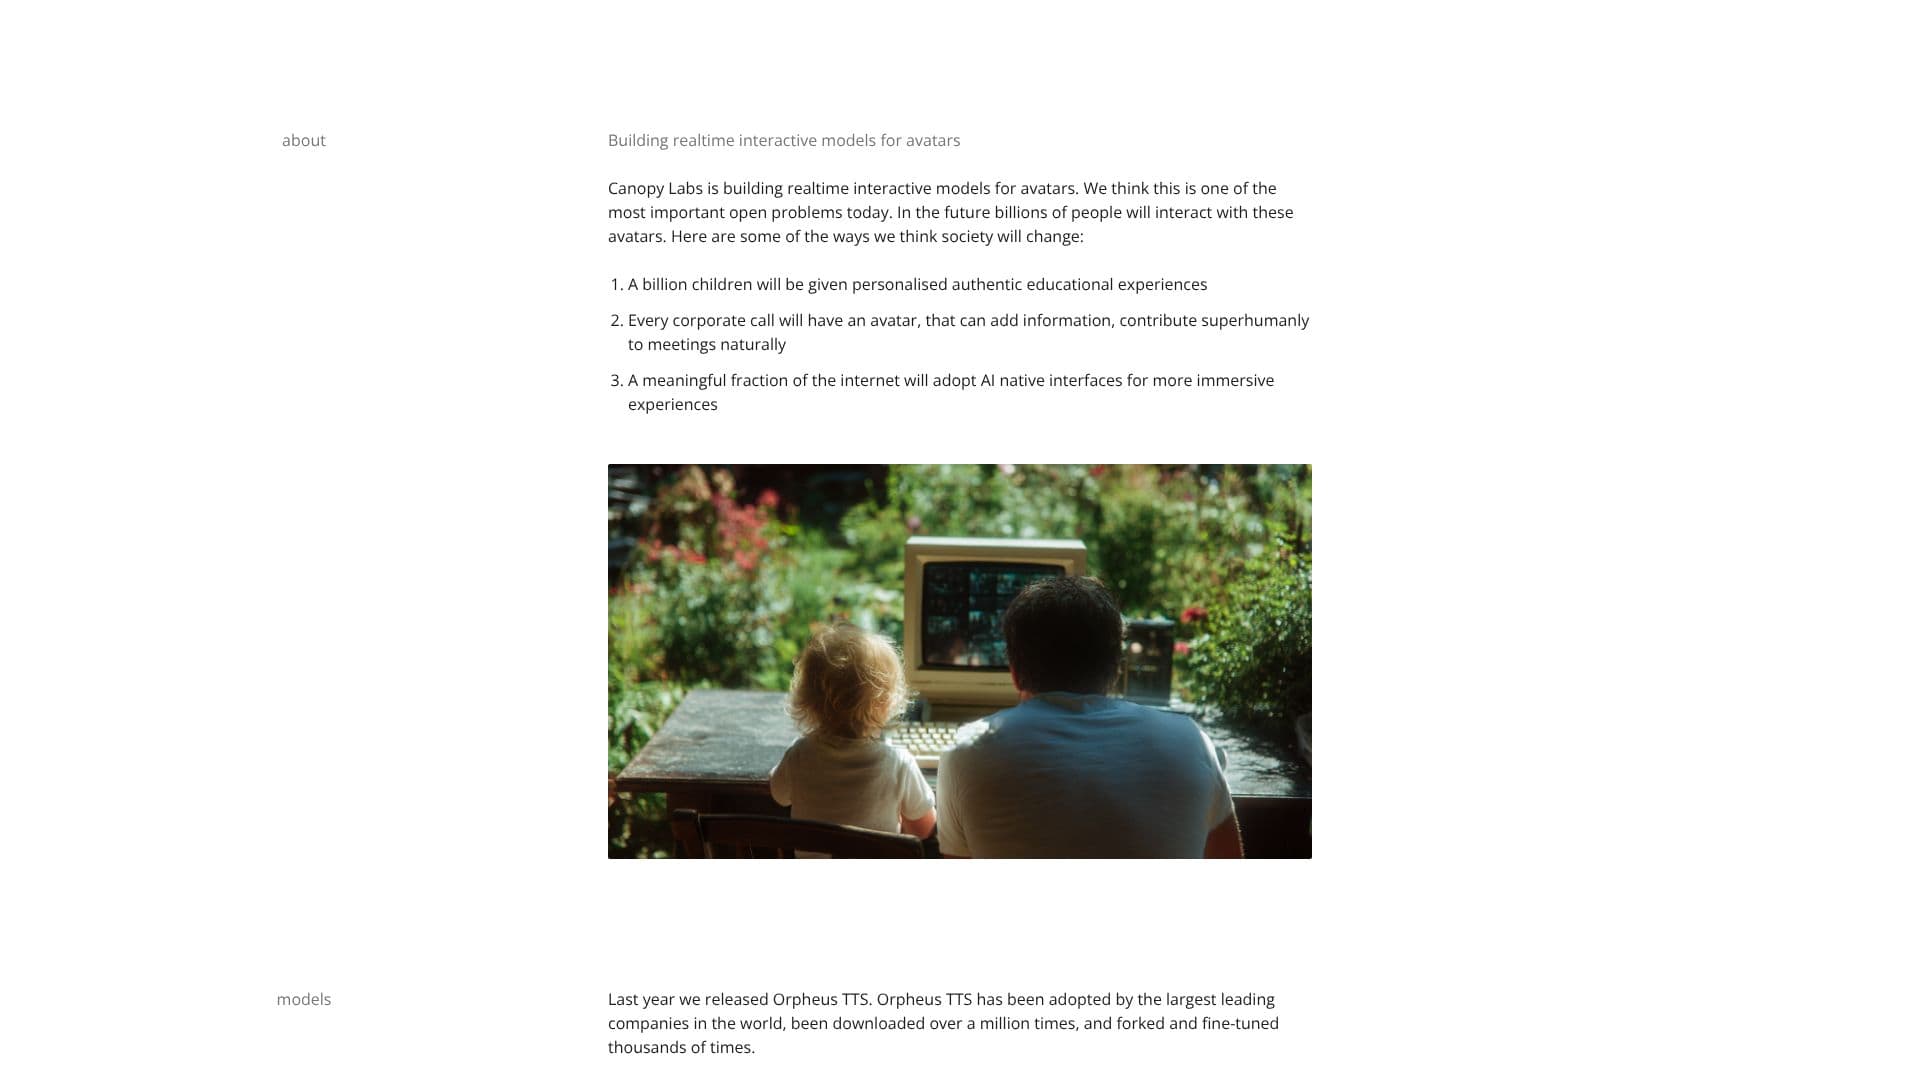
Canopy Labs beschreibt seine Arbeit als Entwicklung interaktiver Modelle für Avatare in Echtzeit, mit dem erklärten Ziel, digitale Menschen zu entwickeln, die von echten nicht zu unterscheiden sind. Das Unternehmen betrachtet dies als ein offenes Forschungsproblem, von dem es erwartet, dass es die Art und Weise, wie Menschen mit Software interagieren, neu gestalten wird, und listet Szenarien wie personalisierte Bildungserfahrungen und Avatare, die an Unternehmensbesprechungen teilnehmen, als Richtungen auf, die die Technologie ermöglichen soll; dies sind die eigenen erklärten Visionen des Unternehmens und keine ausgelieferten Funktionen.
Weiterlesen
Canopy Labs hat zuvor Orpheus TTS veröffentlicht, das, wie das Unternehmen angibt, von Unternehmen übernommen wurde, über eine Million Mal heruntergeladen und tausendfach geforkt oder feinabgestimmt wurde (laut den eigenen Angaben des Unternehmens). Seitdem gibt Canopy Labs an, 17 Millionen Dollar gesammelt zu haben und entwickelt weitere Sprach- und Avatar-Modelle, die noch nicht öffentlich sind.
Das heute verfügbare Produkt ist Orpheus v1, ein Text-to-Speech-Modell, das in zwei Stufen, Base und Flash, angeboten wird. Es ist nativ mehrsprachig und unterstützt Englisch, Hindi, Mandarin, Deutsch, Japanisch, Französisch, Italienisch, Portugiesisch, Russisch, Spanisch und Koreanisch und unterstützt Inline-Bühnenanweisungen in einem Skript, wie das Markieren einer Zeile als undeutlich oder emotional, um zu steuern, wie sie geliefert wird. Canopy Labs gibt an, dass das Modell eine ultra-niedrige Latenz hat, mit einer p99-Antwortzeit innerhalb von 30 Millisekunden von seiner Basislinie. Eine Sprachbibliothek wird mit mehr als 30 voreingestellten Stimmen geliefert, und professionelle oder einmalige Sprachklonierung kann eine benutzerdefinierte Markenstimme aus wenigen Stunden Audio erstellen.
Für Unternehmenskunden kann Orpheus vor Ort oder in einer privaten Cloud mit priorisiertem Support und einem SLA bereitgestellt werden, anstatt nur über eine gehostete API. Auf seiner Website demonstriert Canopy Labs das Modell in mehreren voreingestellten Lieferstilen, einschließlich einer Kundenservice-Stimme, einem selbstreflektierenden Ton, einer theatralischen Lesung, einer Sprachlernerzählung und einer Meditations-Coach-Stimme, um zu zeigen, wie dasselbe Modell unterschiedliche Register handhabt. Canopy Labs veröffentlicht keine öffentlichen Preise für Orpheus auf seiner Website.
- KategorieKI-Avatar-Generatoren
- BereitstellungCloud
- PlattformenWeb
Canopy Labs's Kernfunktionen
Text-to-Speech-Modell (Orpheus v1) in den Stufen Base und Flash verfügbar
Nativ mehrsprachig in elf Sprachen, einschließlich Englisch, Hindi und Mandarin
Unterstützt Inline-Bühnenanweisungen zur Steuerung der emotionalen Lieferung einer Zeile
Bietet professionelle und einmalige Sprachklonierung aus wenigen Stunden Audio
Stellt eine Bibliothek mit mehr als 30 voreingestellten Stimmen zur Verfügung
Behauptet ultra-niedrige Latenz, mit p99 innerhalb von 30 Millisekunden von der Basislinie
Unterstützt die Bereitstellung vor Ort oder in einer privaten Cloud für Unternehmen mit SLA-Support
Forschung an interaktiven Avatar-Modellen in Echtzeit über das ausgelieferte Sprachprodukt hinaus
Wie verwendet man Canopy Labs?
Modellstufe auswählen: Wählen Sie Orpheus v1 Base oder Flash je nach Latenz- und Qualitätsanforderungen.
Stimme auswählen oder klonen: Verwenden Sie eine Bibliotheksstimme oder klonen Sie eine benutzerdefinierte aus Beispiel-Audio.
Das Skript schreiben: Fügen Sie Bühnenanweisungen hinzu, um die Lieferung zu gestalten, wie Ton oder Emotion.
Bereitstellung wählen: Verwenden Sie das gehostete Modell oder arrangieren Sie die Bereitstellung vor Ort oder in einer privaten Cloud.
Das Ergebnis integrieren: Füttern Sie die generierte Sprache in ein Produkt, einen Avatar oder einen Support-Workflow.
Canopy Labs's Anwendungsfälle
- Prototyping von Sprachprodukten
- Kundenservice-Stimmen
- Erzählung für das Sprachenlernen
- Unternehmensbereitstellung vor Ort