Beschreibung
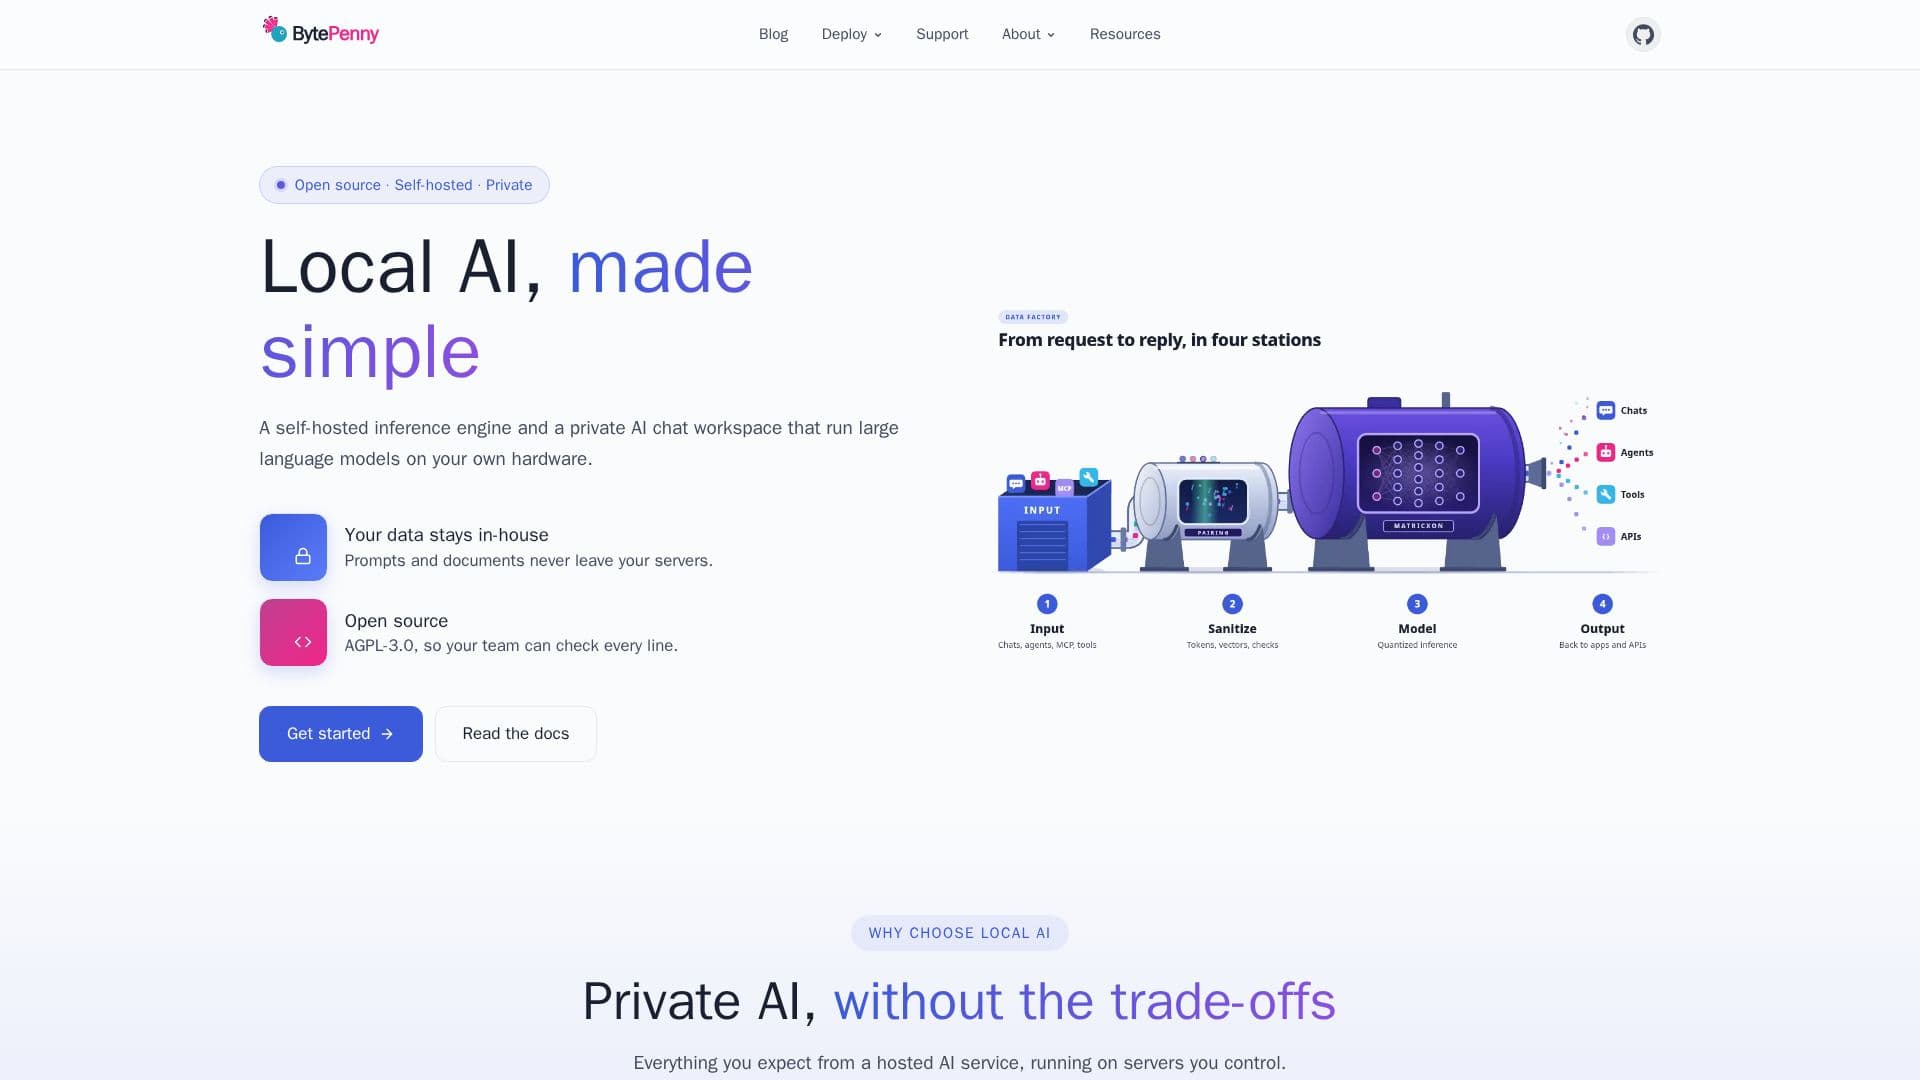
BytePenny bietet eine umfassende Suite von Open-Source-, selbstgehosteten KI-Tools, die für Datenschutz und Kontrolle entwickelt wurden. Das Hauptangebot umfasst Matricxon, eine Open-Source-GGUF-Inferenz-Engine, und pAIring, einen privaten KI-Chat-Arbeitsbereich, der speziell für Teams konzipiert ist. Diese Produkte ermöglichen es Organisationen, große Sprachmodelle direkt auf ihrer eigenen Hardware auszuführen, sodass Eingaben, Dokumente und Chatdaten niemals ihre Server verlassen.
Weiterlesen
Die Plattform legt großen Wert auf Datenschutz und arbeitet vollständig offline, um alle sensiblen Informationen im Haus zu halten. Sie unterstützt verschiedene GGUF-Modelle von Quellen wie Hugging Face, llama.cpp oder Matricxon-Engines und kann mit MCP-Tool-Servern integriert werden. BytePenny ist mit einer Open-Source-Philosophie aufgebaut und verwendet eine AGPL-3.0-Lizenz, die es Teams ermöglicht, jede Zeile Code zu überprüfen und zu ändern, was Transparenz und Vertrauen fördert.
Matricxon, die Inferenz-Engine, ist eine leichte, lesbare LLM-Laufzeit, die in Python und PyTorch geschrieben ist und native C-Kerne für beschleunigte Leistung bietet. Sie unterstützt GGUF-Modelle für Aufgaben wie Chat, Textgenerierung, Einbettungen, Neurangierung, vision-language-Modelle und Zeitreihenprognosen und bedient sie über eine HTTP-API. Sie läuft effizient auf CPUs und bietet BETA-Unterstützung für NVIDIA-GPUs, mit Plänen zur Erweiterung auf AMD- und Apple-Silicon-GPUs. Matricxon unterstützt auch einen Cluster-Modus für gemeinsame Modelle und Chat-Caches über mehrere Knoten, die über die pAIring-Benutzeroberfläche verwaltet werden.
pAIring, der private KI-Chat-Arbeitsbereich, ist für die Teamzusammenarbeit konzipiert und bietet Funktionen wie rollenbasierte Zugriffssteuerung, gemeinsame Kanäle und eine integrierte Wissensdatenbank. Es bietet verschlüsselte Chat-Caches und stellt sicher, dass Eingaben niemals für das Training von Modellen verwendet werden. Das System ist skalierbar und ermöglicht es Benutzern, mit einem einzelnen Server zu beginnen und durch Hinzufügen von Knoten mit Lastenausgleich und Failover-Funktionen zu erweitern. Für Szenarien, die mehr Leistung erfordern, kann pAIring mit verschiedenen Cloud-Anbietern wie Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq und mehr verbunden werden, was Flexibilität beim Mischen von lokalen und Cloud-Engines bietet.
BytePenny beseitigt die Abrechnung pro Token, sodass Organisationen vorhandene Hardware nutzen und flache Kosten beibehalten können, während die Nutzung wächst. Der gesamte Stack ist darauf ausgelegt, offen zu sein, von dem AGPL-3.0-Code bis hin zu Open-Weight-Modellen, was ihn ideal für private und geschlossene Netzwerke macht. Sicherheit hat oberste Priorität, mit Funktionen wie bcrypt-gehashten Passwörtern, verschlüsselten gespeicherten Geheimnissen, AES-256-GCM-verschlüsselten Chat-Caches und serverseitigen Rollenprüfungen für Admin-Aktionen. Sowohl Matricxon als auch pAIring haben das OpenSSF Best Practices 'passing'-Abzeichen erhalten, was ein Engagement für sichere Entwicklungspraktiken demonstriert.
- KategorieMLOps & Modell-Deployment
- PreismodellOpen Source (AGPL-3.0), No Per-Token Bills
- BereitstellungSelf-Hosted, On-Premise, Cloud (Hybrid)
- PlattformenWindows, Linux
BytePenny's Kernfunktionen
Selbstgehostete KI-Inferenz-Engine (Matricxon)
Privater KI-Chat-Arbeitsbereich für Teams (pAIring)
Große Sprachmodelle auf Ihrer eigenen Hardware ausführen
Daten bleiben im Haus; Eingaben und Dokumente verlassen niemals die Server
Open-Source mit AGPL-3.0-Lizenz
Funktioniert vollständig offline
Verschlüsselte Chat-Caches mit AES-256-GCM
Rollenbasierter Zugriff für Teams
Eingaben werden niemals für das Training von Modellen verwendet
Unterstützt GGUF-Modelle von Hugging Face, llama.cpp, Matricxon
Quantisierte Kerne für CPU- und NVIDIA-GPU-Unterstützung
Keine Abrechnung pro Token; flache Kosten mit wachsender Nutzung
Skalierbare Bereitstellung: einzelner Knoten, gemeinsamer Cluster oder separate Server
Verbindung zu über 12 Cloud-Anbietern (Bedrock, Vertex AI, Azure OpenAI, Gemini, Groq usw.)
Von Grund auf in Python für Lesbarkeit und Anpassbarkeit geschrieben
Wie verwendet man BytePenny?
BytePenny bereitstellen: Installieren Sie Matricxon und pAIring auf Ihren eigenen Servern oder in Ihrer Cloud-Infrastruktur.
Inferenz-Engine konfigurieren: Richten Sie Matricxon als lokale Inferenz-Engine ein oder verbinden Sie pAIring mit einem bevorzugten Cloud-Anbieter.
Modelle hinzufügen: Integrieren Sie GGUF-Modelle von Hugging Face oder anderen Quellen oder nutzen Sie cloud-gehostete Modelle über Connectoren.
Benutzer und Teams verwalten: Konfigurieren Sie rollenbasierten Zugriff, erstellen Sie gemeinsame Kanäle und richten Sie eine Wissensdatenbank innerhalb von pAIring ein.
Chatten Sie los: Beginnen Sie private KI-Gespräche und nutzen Sie die Wissensdatenbank für die Teamzusammenarbeit.
Überwachen und skalieren: Beobachten Sie den Systemstatus, verwalten Sie Clusterknoten und erweitern Sie die Hardware, während die Nutzung wächst, ohne Kosten pro Token zu verursachen.
BytePenny's Anwendungsfälle
- Privater Team-Chat
- Lokale LLM-Inferenz
- Sichere Dokumentenanalyse
- Kostenkontrollierte KI-Operationen
- Offline-KI-Workflows
- Bereitstellung benutzerdefinierter Modelle
- Skalierbare KI-Infrastruktur
- Open-Source-KI-Entwicklung