الوصف
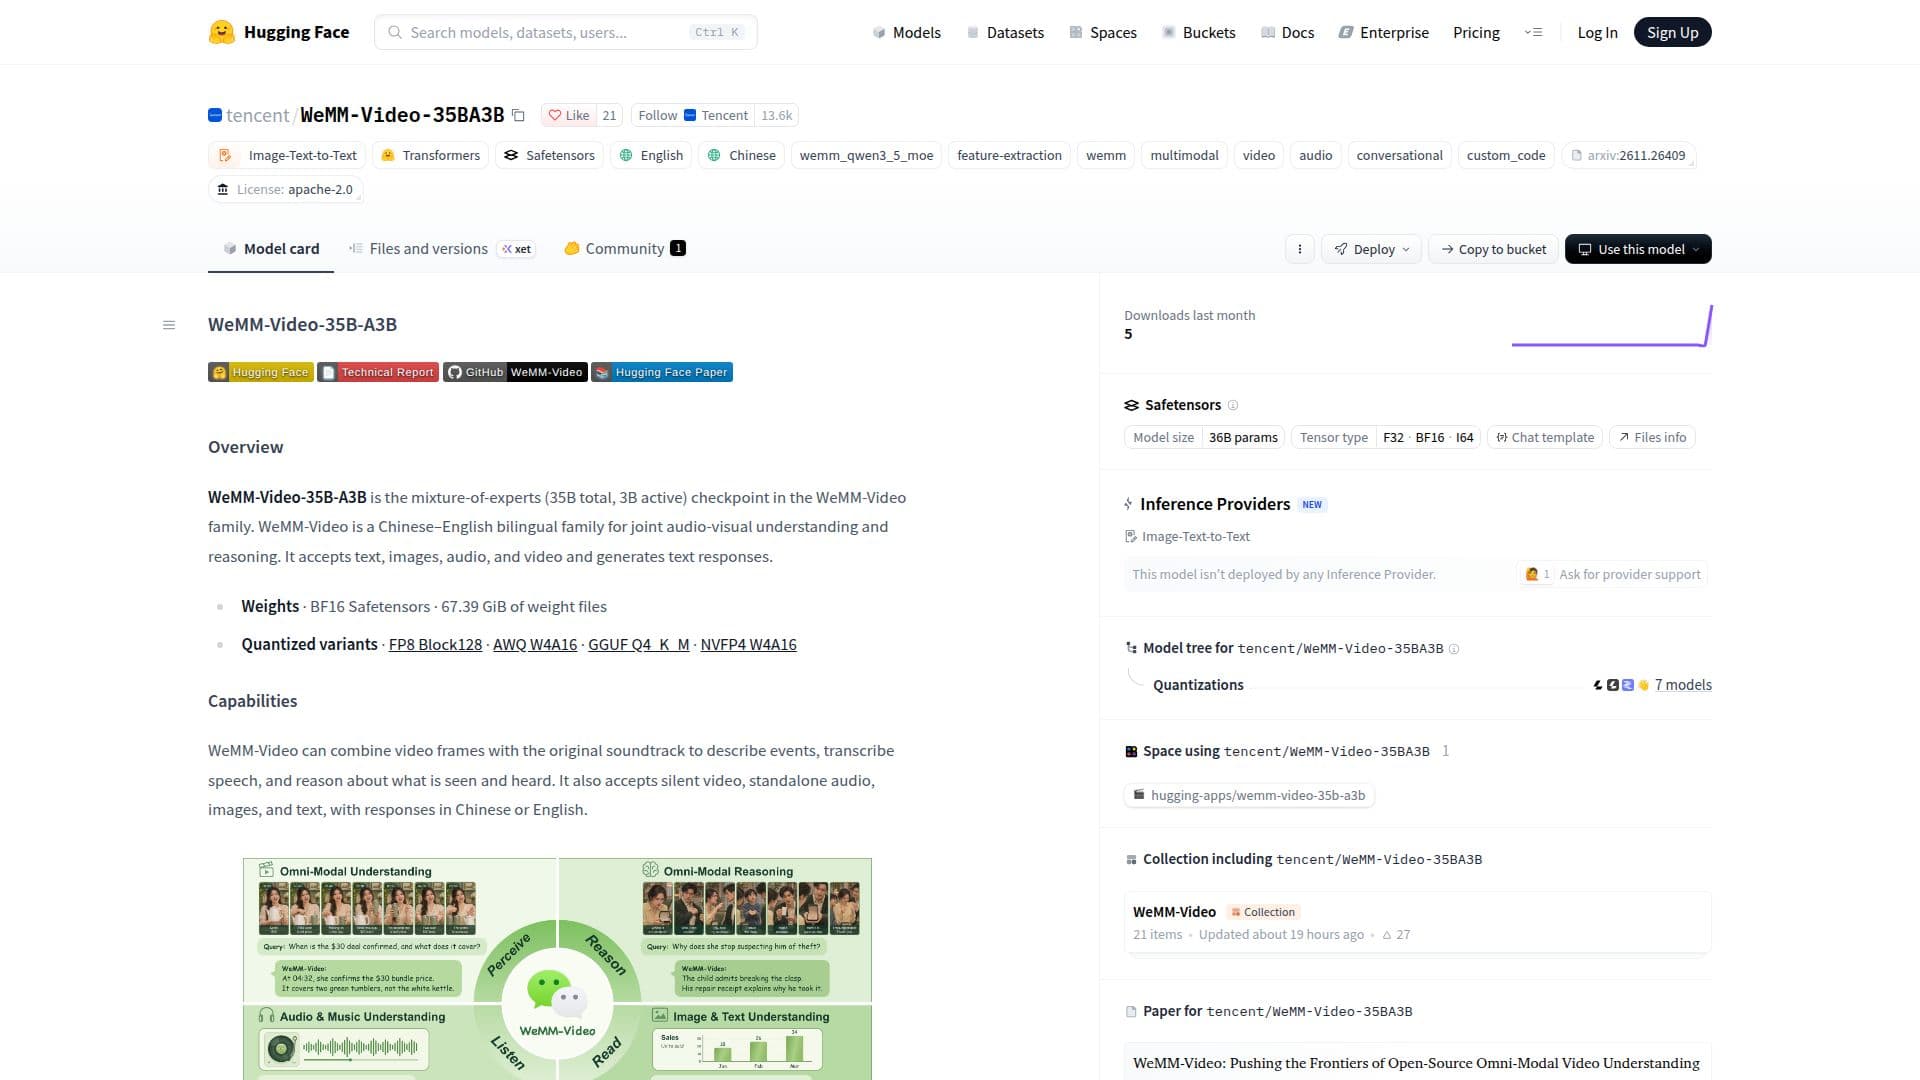
WeMM-Video-35B-A3B هو نموذج مزيج من الخبراء متطور، جزء من عائلة WeMM-Video الأوسع، تم تطويره لفهم الصوت والصورة بشكل شامل والتفكير. مع 35 مليار معلمة إجمالية و3 مليار معلمة نشطة، تم تصميم هذا النموذج خصيصاً لمعالجة وتفسير المدخلات متعددة الوسائط، بما في ذلك النصوص والصور والصوت والفيديو، وتوليد ردود نصية متماسكة إما باللغة الصينية أو الإنجليزية.
قراءة المزيد
تشمل القدرات الأساسية للنموذج القدرة على دمج إطارات الفيديو مع مسارات الصوت الأصلية لوصف الأحداث، ونسخ الكلام بدقة، وأداء مهام التفكير بناءً على المعلومات البصرية والسمعية. كما أنه مرن بما يكفي للتعامل مع الفيديو الصامت، والصوت المستقل، والصور، ومدخلات النصوص بشكل مستقل. وهذا يجعله مناسباً لمجموعة واسعة من التطبيقات التي تتطلب فهماً عميقاً للسياق عبر أنواع الوسائط المختلفة.
معمارياً، يستخدم WeMM-Video-35B-A3B مشفرات الرؤية والصوت لتحويل مدخلات الوسائط إلى رموز، والتي تتم معالجتها بعد ذلك بواسطة نموذج لغوي جنباً إلى جنب مع النص. يتم إثراء إطارات الفيديو بطوابع زمنية للحفاظ على السياق الزمني. خضعت عائلة النموذج لتدريب مسبق مكثف على حوالي 1.2 تريليون رمز متعدد الوسائط، تلاها تقنيات تدريب متقدمة مثل OPD متعدد المعلمين، وMrDPO لمكافحة التكرار، وتعلم تعزيز متخصص لتعزيز أدائه وقوته.
تسهل خيارات الخدمة المختلفة النشر والتكامل. يمكن للمستخدمين إعداد بيئة Transformers وتشغيل الأمثلة مباشرة من مستودع WeMM-Video. يدعم النموذج متغيرات كمية مثل FP8 Block128، وAWQ W4A16، وGGUF Q4_K_M، وNVFP4 W4A16. بالنسبة للخدمة، فهو متوافق مع الإصدارات المرقعة من vLLM (0.18.0 و0.31.0) وSGLang (0.5.16 أو 0.5.19)، مما يسمح باستنتاج فعال، بما في ذلك التوازي في التنسور عبر وحدات معالجة الرسوميات المتعددة. كما يقدم النموذج أوضاع دردشة مختلفة، بما في ذلك وضع التعليم الافتراضي ووضع "التفكير" لردود التفكير.
لقد أظهر WeMM-Video-35B-A3B أداءً قوياً، مما أسس معياراً جديداً مفتوح المصدر. لقد أظهر تفوقه على نماذج ملكية مثل Qwen3.5-Omni-Flash وSeed2.0-Mini-0428، مما يقلل بشكل كبير من الفجوة في الأداء مع نماذج متقدمة مثل Gemini-3.0-Flash. تم إصدار النموذج بموجب رخصة Apache 2.0، مما يعزز الوصول المفتوح والتعاون داخل مجتمع الذكاء الاصطناعي.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
أبرز ملامح WeMM-Video-35B-A3B
معالجة ثنائية اللغة الصينية-الإنجليزية
فهم صوتي بصري مشترك والتفكير
يقبل مدخلات النصوص والصور والصوت والفيديو
يولد ردود نصية
يصف الأحداث من إطارات الفيديو ومسارات الصوت
ينسخ الكلام من الصوت
يفكر في المعلومات البصرية والسمعية
يدعم معالجة الفيديو الصامت والصوت المستقل
معمارية مزيج من الخبراء (35B إجمالي، 3B معلمات نشطة)
مدرب مسبقاً على 1.2 تريليون رمز متعدد الوسائط
مدرب بعدي باستخدام OPD متعدد المعلمين وMrDPO
تعلم تعزيز متخصص لأداء معزز
يدعم متغيرات كمية مختلفة (FP8، AWQ، GGUF، NVFP4)
متوافق مع إصدارات مرقعة من vLLM وSGLang للخدمة
يقدم أوضاع دردشة تعليمية وتفكير
البدء مع WeMM-Video-35B-A3B
إعداد البيئة: تثبيت بيئة Transformers والاعتماديات اللازمة.
تحميل النموذج: تحميل نموذج WeMM-Video-35B-A3B والمعالج من Hugging Face Hub.
تحضير المدخلات: تقديم مدخلات الوسائط مثل ملفات الفيديو MP4، الصوت المستقل، الصور، أو النصوص.
معالجة الوسائط: استخدام السكربت لمعالجة إطارات الفيديو بمفردها أو مع مسار الصوت الأصلي.
توليد الردود: إرسال الطلبات إلى النموذج، مع تحديد وضع الدردشة (تعليم أو تفكير) لتوليد النص.
خدمة النموذج (اختياري): تثبيت تصحيح وقت التشغيل WeMM واستخدام vLLM أو SGLang المرقعة لخدمة API.
إرسال طلبات API: استخدام عميل الطلبات المدمج لإرسال الوسائط مباشرة إلى نقطة نهاية دردشة متوافقة مع OpenAI.
حالات استخدام WeMM-Video-35B-A3B
- تحليل محتوى الفيديو
- نسخ الكلام
- التفكير متعدد الوسائط
- معالجة المحتوى ثنائي اللغة
- وصف الأحداث الصوتية البصرية
- تطوير نماذج الذكاء الاصطناعي
- البحث والتجريب