

تخطَّ إلى المحتوى الرئيسي
ToolPotion
مستشار الذكاء الاصطناعي
إرسال (مجاني)

نماذج BERT متعددة اللغات

توفر BERT نموذجين متعددَي اللغات: Cased و Uncased، يدعمان أكثر من 100 لغة. يُوصى بنموذج Cased للأبجديات غير اللاتينية والاستخدام العام، بينما يُعد نموذج Uncased إصدارًا أقدم. تم تصميم هذه النماذج لمهام فهم اللغة الطبيعية ويمكن ضبطها بدقة لتطبيقات محددة.

زيارة الرابط
مشاركة
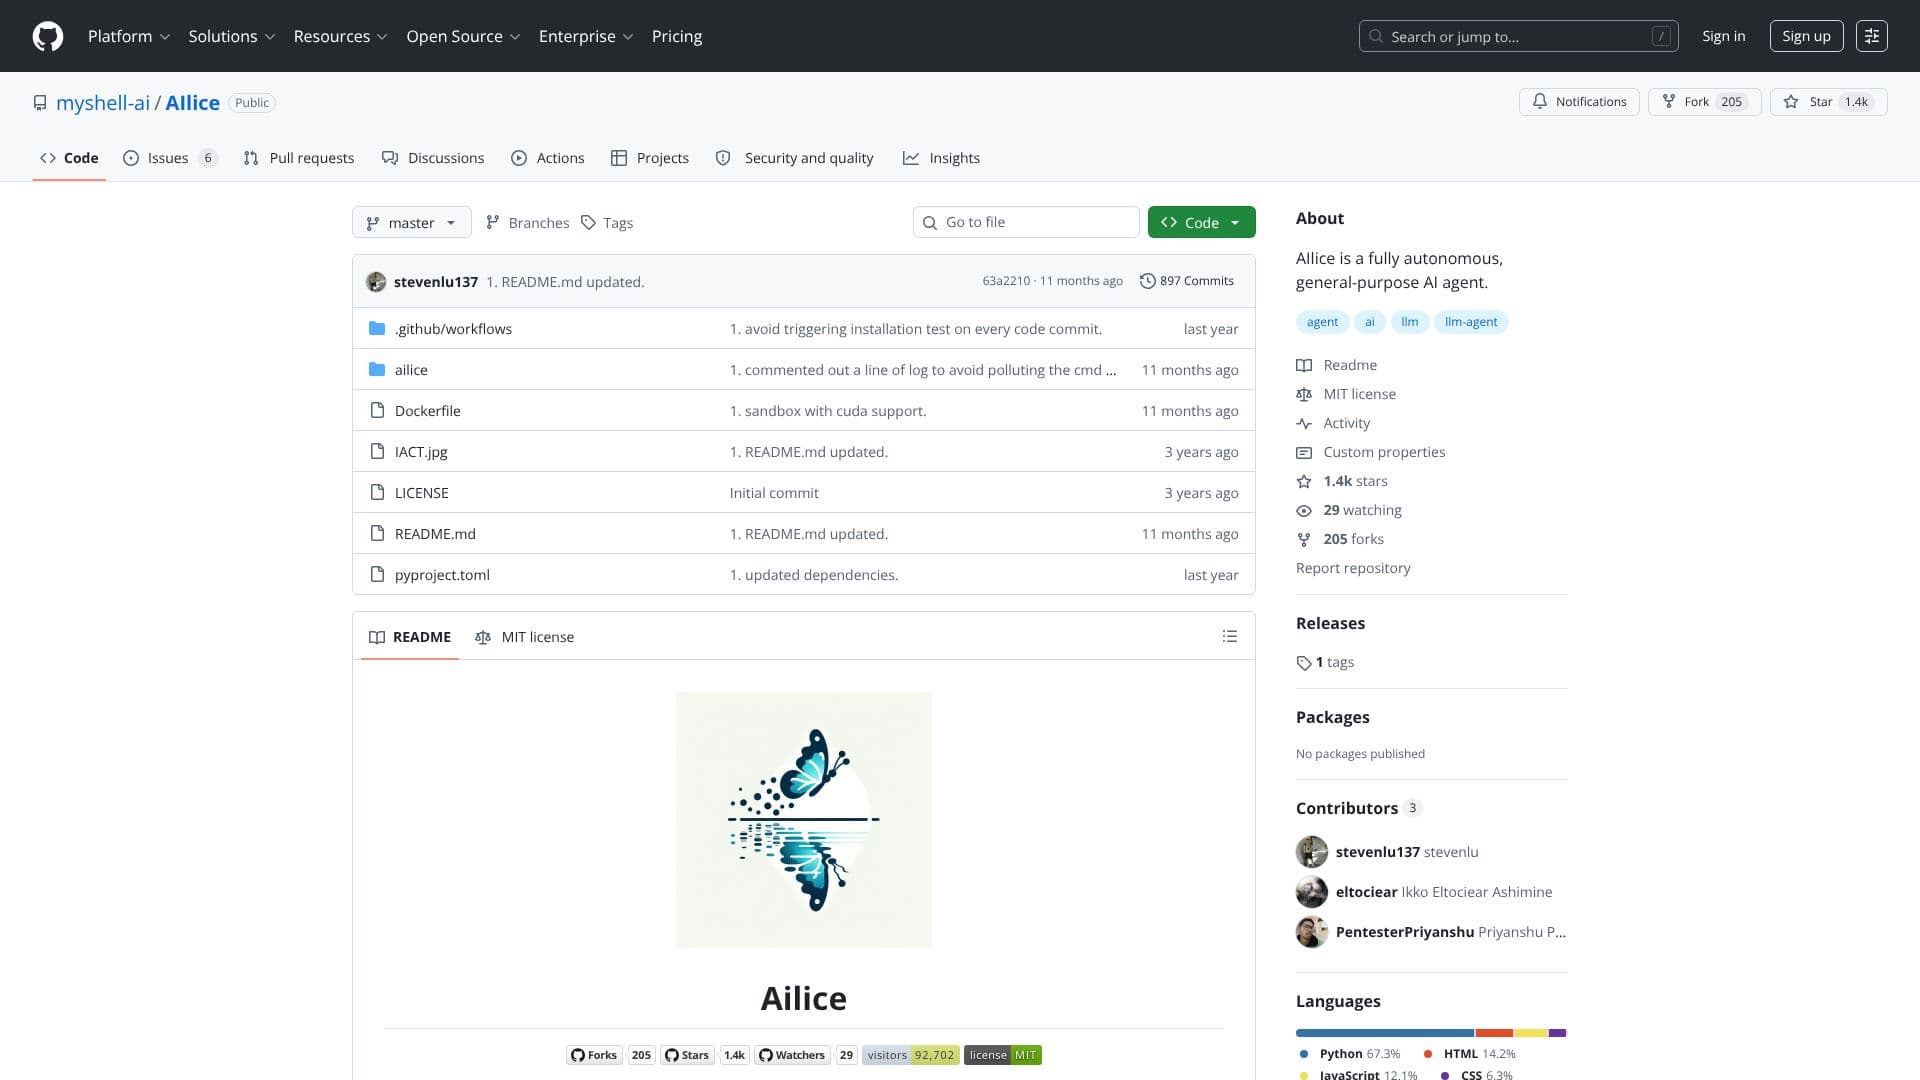
لقطة شاشة لـ نماذج BERT متعددة اللغات

يقدم مشروع BERT (Bidirectional Encoder Representations from Transformers) نماذج مُدربة مسبقًا لمهام معالجة اللغة الطبيعية. من بين عروضه نماذج متعددة اللغات مصممة للتعامل مع مجموعة واسعة من اللغات، مما يتيح الفهم والتطبيقات عبر اللغات. حاليًا، يتوفر نموذجان رئيسيان متعددَي اللغات: BERT-Base, Multilingual Cased (جديد، موصى به) و BERT-Base, Multilingual Uncased (أصلي، غير موصى به).

قراءة المزيد

يدعم نموذج BERT-Base, Multilingual Cased 104 لغات ويتميز ببنية من 12 طبقة مع 768 وحدة مخفية، و 12 رأس انتباه، و 110 مليون معامل. يُوصى بهذا النموذج نظرًا لتحسين تطبيعه للعديد من اللغات، خاصة تلك التي تحتوي على أبجديات غير لاتينية. عند استخدام هذا النموذج، من الضروري تعيين `--do_lower_case=false` في نصوص التشغيل. نموذج Multilingual Uncased، على الرغم من دعمه لـ 102 لغة بنفس البنية، إلا أنه غير موصى به للمشاريع الجديدة.

بالنسبة لمهام اللغة الصينية، يتوفر أيضًا نموذج BERT-Base, Chinese مخصص، يدعم الصينية المبسطة والتقليدية. بينما تتضمن النماذج متعددة اللغات اللغة الصينية، قد يوفر نموذج صيني فقط نتائج أفضل للضبط الدقيق الخاص باللغة الصينية. تم تقييم أداء هذه النماذج على مجموعة بيانات XNLI، وهي مهمة استدلال لغوي طبيعي عبر اللغات. تشير النتائج إلى أنه بينما قد تتفوق النماذج أحادية اللغة على النماذج متعددة اللغات للغات ذات الموارد العالية، فإن الأخيرة توفر حلاً عمليًا لتغطية لغوية واسعة دون الحاجة إلى صيانة العديد من النماذج أحادية اللغة.

لا يتطلب ضبط نماذج BERT متعددة اللغات تغييرات كبيرة في واجهة برمجة التطبيقات (API). ومع ذلك، قد تكون التحديثات على `BasicTokenizer` ضرورية لترميز الأحرف الصينية. يمكن دمج النماذج في سير العمل باستخدام النصوص البرمجية المتوفرة مثل `run_classifier.py`، والتي تم تحديثها لدعم مجموعات بيانات مثل XNLI. تضمنت استراتيجية أخذ عينات البيانات للتدريب المسبق ترجيحًا مُخففًا أسيًا لبيانات ويكيبيديا لموازنة اللغات ذات الموارد العالية والمنخفضة، مما يضمن تمثيلاً أفضل للجميع. يستخدم الترميز مفردات WordPiece مشتركة، مع معالجة محددة للغات CJK لمعالجة غياب المسافات البيضاء. يتجنب النموذج متعدد اللغات عمدًا علامات اللغة لتسهيل قدرات التعلم الصفري (zero-shot learning).

  • الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
  • نموذج التسعيرمفتوح المصدر
  • النشرسحابي
  • المنصاتالويب

  • يدعم 104 لغات (Multilingual Cased)

  • يدعم 102 لغة (Multilingual Uncased)

  • بنية Transformer من 12 طبقة

  • 768 وحدة مخفية

  • 12 رأس انتباه

  • 110 مليون معامل

  • نموذج Multilingual Cased موصى به لتحسين التطبيع

  • قدرة التعلم الصفري (Zero-shot learning)

  • دعم الضبط الدقيق للمهام المحددة

  • مُدرب مسبقًا على بيانات ويكيبيديا

  • مفردات WordPiece مشتركة

  • يعالج لغات CJK بترميز الأحرف

  • كود TensorFlow مفتوح المصدر متاح

  1. الوصول إلى النموذج: قم بتنزيل نماذج BERT متعددة اللغات المُدربة مسبقًا.

  2. إعداد البيئة: قم بتثبيت TensorFlow والتبعيات اللازمة.

  3. الدمج عبر API: قم بتحميل النماذج والمُرمّزات باستخدام المكتبات المتوفرة.

  4. إعداد البيانات: قم بتنسيق بيانات النص متعددة اللغات للتدريب أو الاستدلال.

  5. الضبط الدقيق: قم بتكييف النموذج لمهام المصب المحددة مثل التصنيف أو الإجابة على الأسئلة.

  6. تشغيل الاستدلال: استخدم النموذج المضبوط بدقة لمعالجة بيانات نصية جديدة.

  7. تقييم الأداء: قم بتقييم دقة النموذج على معايير قياسية متعددة اللغات ذات الصلة.

  • التصنيف عبر اللغات
  • تحليل المشاعر متعدد اللغات
  • نقل التعلم الصفري عبر اللغات
  • تقييم الترجمة الآلية
  • الإجابة على الأسئلة متعددة اللغات
  • استرجاع المعلومات عبر اللغات
  • الاستدلال اللغوي الطبيعي

من Google

تقييمات نماذج BERT متعددة اللغات

جاري التحميل...

أدوات ذكاء اصطناعي شائعة مثل نماذج BERT متعددة اللغات

BERT base uncased

نماذج الذكاء الاصطناعي

نموذج BERT الأساسي (غير مميز) هو نموذج تحويل مدرب مسبقًا مصمم لفهم اللغة الإنجليزية. يستخدم نمذجة اللغة المقنعة وتوقع الجملة التالية لتعلم العلاقات السياقية، مما يجعله مناسبًا…

أدوات معالجة اللغة الطبيعية
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج BERT الأساسي (غير مميز) هو نموذج تحويل مدرب مسبقًا مصمم لفهم اللغة الإنجليزية. يستخدم نمذجة اللغة المقنعة وتوقع الجملة التالية لتعلم العلاقات السياقية، مما يجعله مناسبًا…

مميزةأدوات معالجة اللغة الطبيعية
عرض أفضل 5 من نماذج الذكاء الاصطناعي

نموذج اللغة SmolLM3

نماذج اللغة الكبيرة

نموذج SmolLM3 هو نموذج لغة يحتوي على 3 مليار معلمة مصمم لدفع حدود النماذج الصغيرة. يدعم التفكير في وضعين، وست لغات، ومعالجة سياق طويل، مما يوفر أداءً قويًا في نطاق 3B–4B.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة

المرتبة 45 في نماذج اللغة الكبيرة

عرض الأداة

نماذج اللغة الكبيرة

نموذج SmolLM3 هو نموذج لغة يحتوي على 3 مليار معلمة مصمم لدفع حدود النماذج الصغيرة. يدعم التفكير في وضعين، وست لغات، ومعالجة سياق طويل، مما يوفر أداءً قويًا في نطاق 3B–4B.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
المرتبة 45 في نماذج اللغة الكبيرة

SpanBERT

مستودعات GitHub للذكاء الاصطناعي

SpanBERT هو نموذج ذكاء اصطناعي يركز على تحسين التدريب المسبق من خلال تمثيل وتنبؤ المقاطع النصية. يقدم نماذج أساسية وكبيرة مُدربة مسبقًا، متوافقة مع تنسيقات HuggingFace BERT. يوفر…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

مستودعات GitHub للذكاء الاصطناعي

نموذج ذكاء اصطناعي يركز على تحسين التدريب المسبق من خلال تمثيل وتنبؤ المقاطع النصية. يقدم نماذج أساسية وكبيرة مُدربة مسبقًا، متوافقة مع تنسيقات HuggingFace BERT. يوفر…SpanBERT هو نموذج ذكاء اصطناعي يركز على تحسين التدريب المسبق من خلال تمثيل وتنبؤ المقاطع النصية. يقدم نماذج أساسية وكبيرة مُدربة مسبقًا، متوافقة مع تنسيقات HuggingFace BERT. يوفر…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 250 من مستودعات GitHub للذكاء الاصطناعي

XLM-RoBERTa Base

نماذج الذكاء الاصطناعي

XLM-RoBERTa هو نموذج متعدد اللغات تم تدريبه مسبقًا على 2.5 تيرابايت من البيانات عبر 100 لغة. يتفوق في مهام مثل تصنيف التسلسل وتصنيف الرموز، مما يجعله أداة قيمة لمجموعة متنوعة من…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج متعدد اللغات تم تدريبه مسبقًا على 2.5 تيرابايت من البيانات عبر 100 لغة. يتفوق في مهام مثل تصنيف التسلسل وتصنيف الرموز، مما يجعله أداة قيمة لمجموعة متنوعة من…XLM-RoBERTa هو نموذج متعدد اللغات تم تدريبه مسبقًا على 2.5 تيرابايت من البيانات عبر 100 لغة. يتفوق في مهام مثل تصنيف التسلسل وتصنيف الرموز، مما يجعله أداة قيمة لمجموعة متنوعة من…

مميزةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 5 من نماذج الذكاء الاصطناعي

DeepSeek

نماذج اللغة الكبيرة

DeepSeek هي شركة بحث في الذكاء الاصطناعي مكرسة لتطوير الذكاء الاصطناعي العام. تقدم نماذج لغة كبيرة مفتوحة المصدر مثل DeepSeek-V4 وDeepSeek-R1 وDeepSeek-Coder، مما يمكّن المستخدمين…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة

المرتبة 2 في نماذج اللغة الكبيرة

عرض الأداة

نماذج اللغة الكبيرة

شركة بحث في الذكاء الاصطناعي مكرسة لتطوير الذكاء الاصطناعي العام. تقدم نماذج لغة كبيرة مفتوحة المصدر مثل DeepSeek-V4 وDeepSeek-R1 وDeepSeek-Coder، مما يمكّن المستخدمين…DeepSeek هي شركة بحث في الذكاء الاصطناعي مكرسة لتطوير الذكاء الاصطناعي العام. تقدم نماذج لغة كبيرة مفتوحة المصدر مثل DeepSeek-V4 وDeepSeek-R1 وDeepSeek-Coder، مما يمكّن المستخدمين…

مميزةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
المرتبة 2 في نماذج اللغة الكبيرة

نموذج Qwen1.5-110B

نماذج الذكاء الاصطناعي

نموذج Qwen1.5-110B هو نموذج لغوي يعتمد على المحولات ويقدم تحسينات كبيرة في الأداء، ودعم متعدد اللغات، وطول سياق ثابت يبلغ 32K. مثالي لتطبيقات الذكاء الاصطناعي المتقدمة.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج لغوي يعتمد على المحولات ويقدم تحسينات كبيرة في الأداء، ودعم متعدد اللغات، وطول سياق ثابت يبلغ 32K. مثالي لتطبيقات الذكاء الاصطناعي المتقدمة.نموذج Qwen1.5-110B هو نموذج لغوي يعتمد على المحولات ويقدم تحسينات كبيرة في الأداء، ودعم متعدد اللغات، وطول سياق ثابت يبلغ 32K. مثالي لتطبيقات الذكاء الاصطناعي المتقدمة.

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 5 من نماذج الذكاء الاصطناعي

intfloat multilingual-e5-large

نماذج الذكاء الاصطناعي

نموذج intfloat multilingual-e5-large هو أداة ذكاء اصطناعي قوية مصممة لتضمين النصوص متعددة اللغات. يدعم 100 لغة ومُحسّن لمهام مثل استرجاع النصوص والتشابه الدلالي، مما يوفر أداءً…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج intfloat multilingual-e5-large هو أداة ذكاء اصطناعي قوية مصممة لتضمين النصوص متعددة اللغات. يدعم 100 لغة ومُحسّن لمهام مثل استرجاع النصوص والتشابه الدلالي، مما يوفر أداءً…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 5 من نماذج الذكاء الاصطناعي

Llama-3.1-8B-Instruct

نماذج الذكاء الاصطناعي

Llama-3.1-8B-Instruct هو نموذج لغوي كبير متعدد اللغات تم تطويره بواسطة Meta، مُحسّن للمهام المعتمدة على التعليمات. تم تصميمه للتطبيقات التجارية والبحثية، حيث يوفر قدرات متقدمة في…

نماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض الأداة

نماذج الذكاء الاصطناعي

نموذج لغوي كبير متعدد اللغات تم تطويره بواسطة Meta، مُحسّن للمهام المعتمدة على التعليمات. تم تصميمه للتطبيقات التجارية والبحثية، حيث يوفر قدرات متقدمة في…Llama-3.1-8B-Instruct هو نموذج لغوي كبير متعدد اللغات تم تطويره بواسطة Meta، مُحسّن للمهام المعتمدة على التعليمات. تم تصميمه للتطبيقات التجارية والبحثية، حيث يوفر قدرات متقدمة في…

مميزةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
عرض أفضل 5 من نماذج الذكاء الاصطناعي
1 من 8








