الوصف
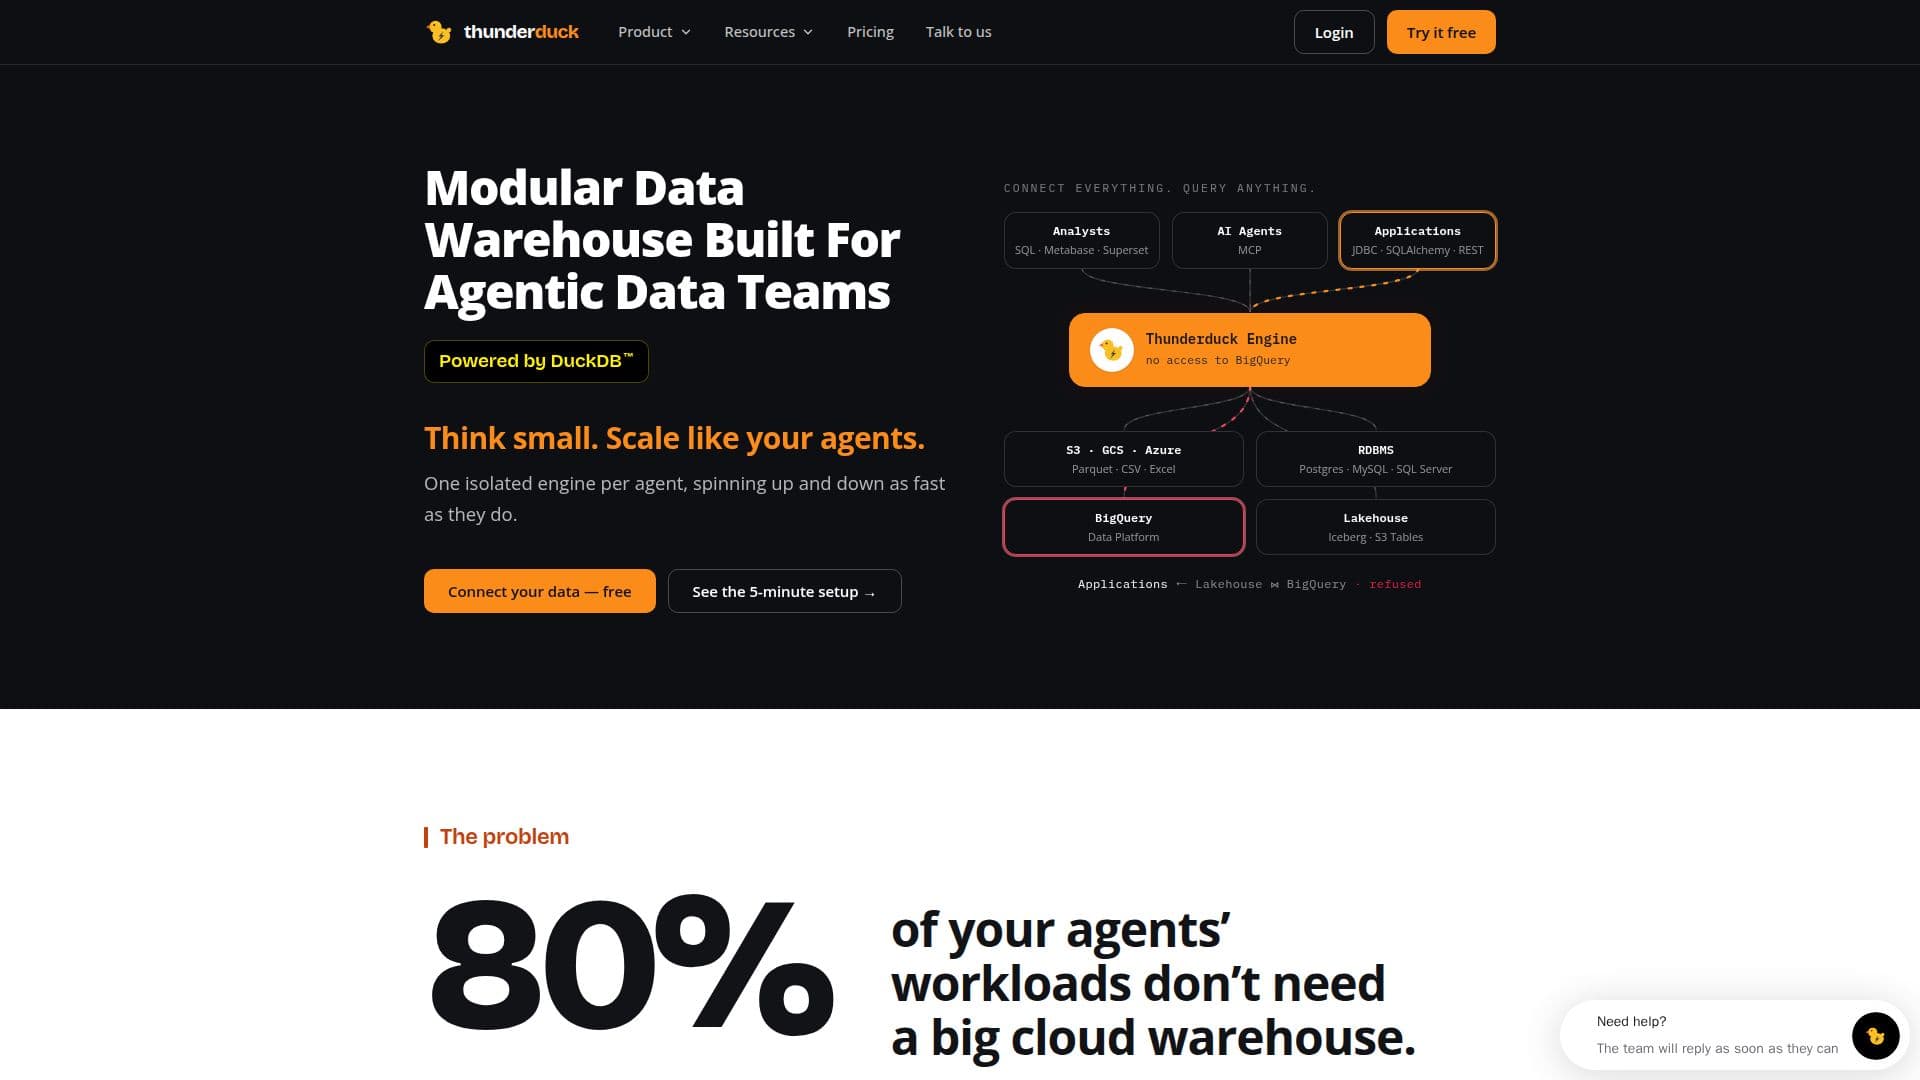
Thunderduck يقدم حلاً لمستودع بيانات معياري مصمم خصيصًا لفرق البيانات الوكيلة، مستفيدًا من قوة DuckDB. يعالج المشكلة الشائعة حيث لا تتطلب 80% من أعباء عمل الوكلاء مستودع سحابي كبير، ومع ذلك تتحمل الفرق تكاليف كبيرة لنظم التوزيع والرسوم المرتبطة بالخدمات المدارة. من خلال توفير محرك معزول لكل وكيل، يسمح Thunderduck للمحركات بالعمل بسرعة، مما يتناسب مع الطبيعة الديناميكية لأعباء العمل الوكيلة.
قراءة المزيد
تم تصميم المنصة لتقديم استعلامات في أقل من ثانية على تيرابايت من البيانات، بغض النظر عن عدد الوكلاء الذين يعملون. تبسط بناء خطوط بيانات وتقوم بأتمتة مهام DevOps، كل ذلك مع الحفاظ على حوكمة على مستوى المؤسسات. لدى المستخدمين المرونة لنشر Thunderduck في أي مكان، سواء محليًا مع مرونة تشبه السحابة أو ضمن بنيتهم التحتية السحابية الحالية.
في جوهره، يستخدم Thunderduck DuckDB، وهو قاعدة بيانات تحليلية مفتوحة المصدر، تعمل في العملية مع محرك موجه. تعني هذه البنية أنه يعمل حيث يعمل كودك، مما يلغي الحاجة لإدارة الخادم. يدعم تعدد المستأجرين ويقدم أمانًا على مستوى المؤسسات، مما يضمن سيادة البيانات من خلال الاحتفاظ بالبيانات ضمن سحابة المستخدم أو مركز البيانات وفقًا لقواعد الوصول الخاصة بهم.
يسهل Thunderduck التكامل السلس مع وكلاء الذكاء الاصطناعي مثل Claude وChatGPT أو Cursor عبر MCP. يمكن للوكلاء تفسير معاني الجداول والأعمدة، وليس فقط الأسماء، للعثور على الجداول الصحيحة، وقراءة الأقسام والفهارس، وكتابة استعلامات فعالة. تعمل هذه الاستعلامات تحت أدوار محددة مسبقًا وحدود تكلفة. يمكن للمنصة أيضًا أتمتة بناء نماذج dbt، متبعة طبقات الميدالية، واختبار الفروع، وفتح طلبات سحب للحفاظ على بيانات نظيفة وقابلة للإدارة.
يدعم Thunderduck اتحاد الاستعلامات بدون ETL، مما يسمح للمستخدمين بدمج البيانات من مصادر متنوعة مثل Postgres وBigQuery وجداول Iceberg والملفات في استعلام واحد، مع دفع الفلاتر إلى كل مصدر. هذا يلغي الحاجة لنسخ البيانات، أو وظائف التحميل، أو مراقبة المزامنة للبيانات الصغيرة والعرضية. عندما تنمو مجموعات البيانات أو تتطلب نمذجة، يمكن للمستخدمين بناء خطوط dbt إلى Iceberg ومتابعة استعلامها بشكل متسق. يوفر Thunderduck أيضًا تقدير التكلفة لكل استعلام قبل تشغيله، مما يمكّن من التحكم في الميزانية ومنع النفقات غير المتوقعة.
- الفئةأدوات SQL وقواعد البيانات بالذكاء الاصطناعي
- نموذج التسعيرمجاني مع ميزات مدفوعة
- النشرسحابي، محلي
- المنصاتالويب
الميزات الأساسية لـ Thunderduck
بنية مستودع بيانات معيارية
محرك DuckDB معزول لكل وكيل
استعلامات في أقل من ثانية على تيرابايت من البيانات
خيارات نشر محلي أو في السحابة
أتمتة مهام DevOps
حوكمة على مستوى المؤسسات
دعم متعدد المستأجرين
زمن استجابة أقل بدون عبء توزيع
سيادة البيانات وقواعد الوصول
تكامل مع وكلاء الذكاء الاصطناعي (Claude، ChatGPT، Cursor) عبر MCP
توليد استعلامات مدعوم بالذكاء الاصطناعي وبناء نماذج dbt
اتحاد الاستعلامات عبر مصادر متنوعة (PostgreSQL، BigQuery، Iceberg، S3)
اكتشاف تلقائي للمخططات والجداول والأعمدة والأنواع
تقدير التكلفة ووقت التشغيل لكل استعلام قبل التنفيذ
تشخيص استعلامات فاشلة مدعوم بالذكاء الاصطناعي واقتراح إصلاحات
تحكم في الوصول بناءً على الأدوار للفهارس
تخزين مؤقت للاستعلامات لاستعلامات فورية ومجانية
كيفية استخدام Thunderduck؟
الاتصال بفهرس: قدم بيانات الاعتماد لمصادر بياناتك مثل قواعد البيانات، المستودعات، بحيرات البيانات، أو تخزين الكائنات.
اكتشاف البيانات: يقرأ Thunderduck المخططات والجداول والأعمدة تلقائيًا، ويستنتج معاني الأعمدة، مما يحافظ عليها محدثة.
استعلام والانضمام: عالج أي جدول كـ catalog.schema.table وانضم عبر مصادر متعددة في عبارة SQL واحدة.
دمج وكلاء الذكاء الاصطناعي: قم بتوصيل Claude وChatGPT أو عملاء MCP الآخرين لتمكين وكلاء الذكاء الاصطناعي من تصفح الفهارس وتشغيل SQL.
أتمتة سير العمل: جدولة عبارات SQL على جدول زمني محدد أو ربط مستودعات dbt لتشغيل البناءات والاختبارات واللقطات.
مراقبة وحوكمة: استخدم تقديرات التكلفة قبل الاستعلام، وسجلات التدقيق، والتحكم في الوصول بناءً على الأدوار لإدارة الاستخدام والأمان.
حالات استخدام Thunderduck
- أعباء بيانات وكيلة
- تحسين التكاليف لفرق البيانات
- تحليلات البيانات في الوقت الحقيقي
- أتمتة خطوط البيانات
- سيادة البيانات والأمان
- استعلام مدعوم بالذكاء الاصطناعي
- دمج البيانات عبر المصادر
- إدارة التكاليف بشكل استباقي
- حوكمة البيانات والتدقيق
- بناء بحيرات البيانات