الوصف
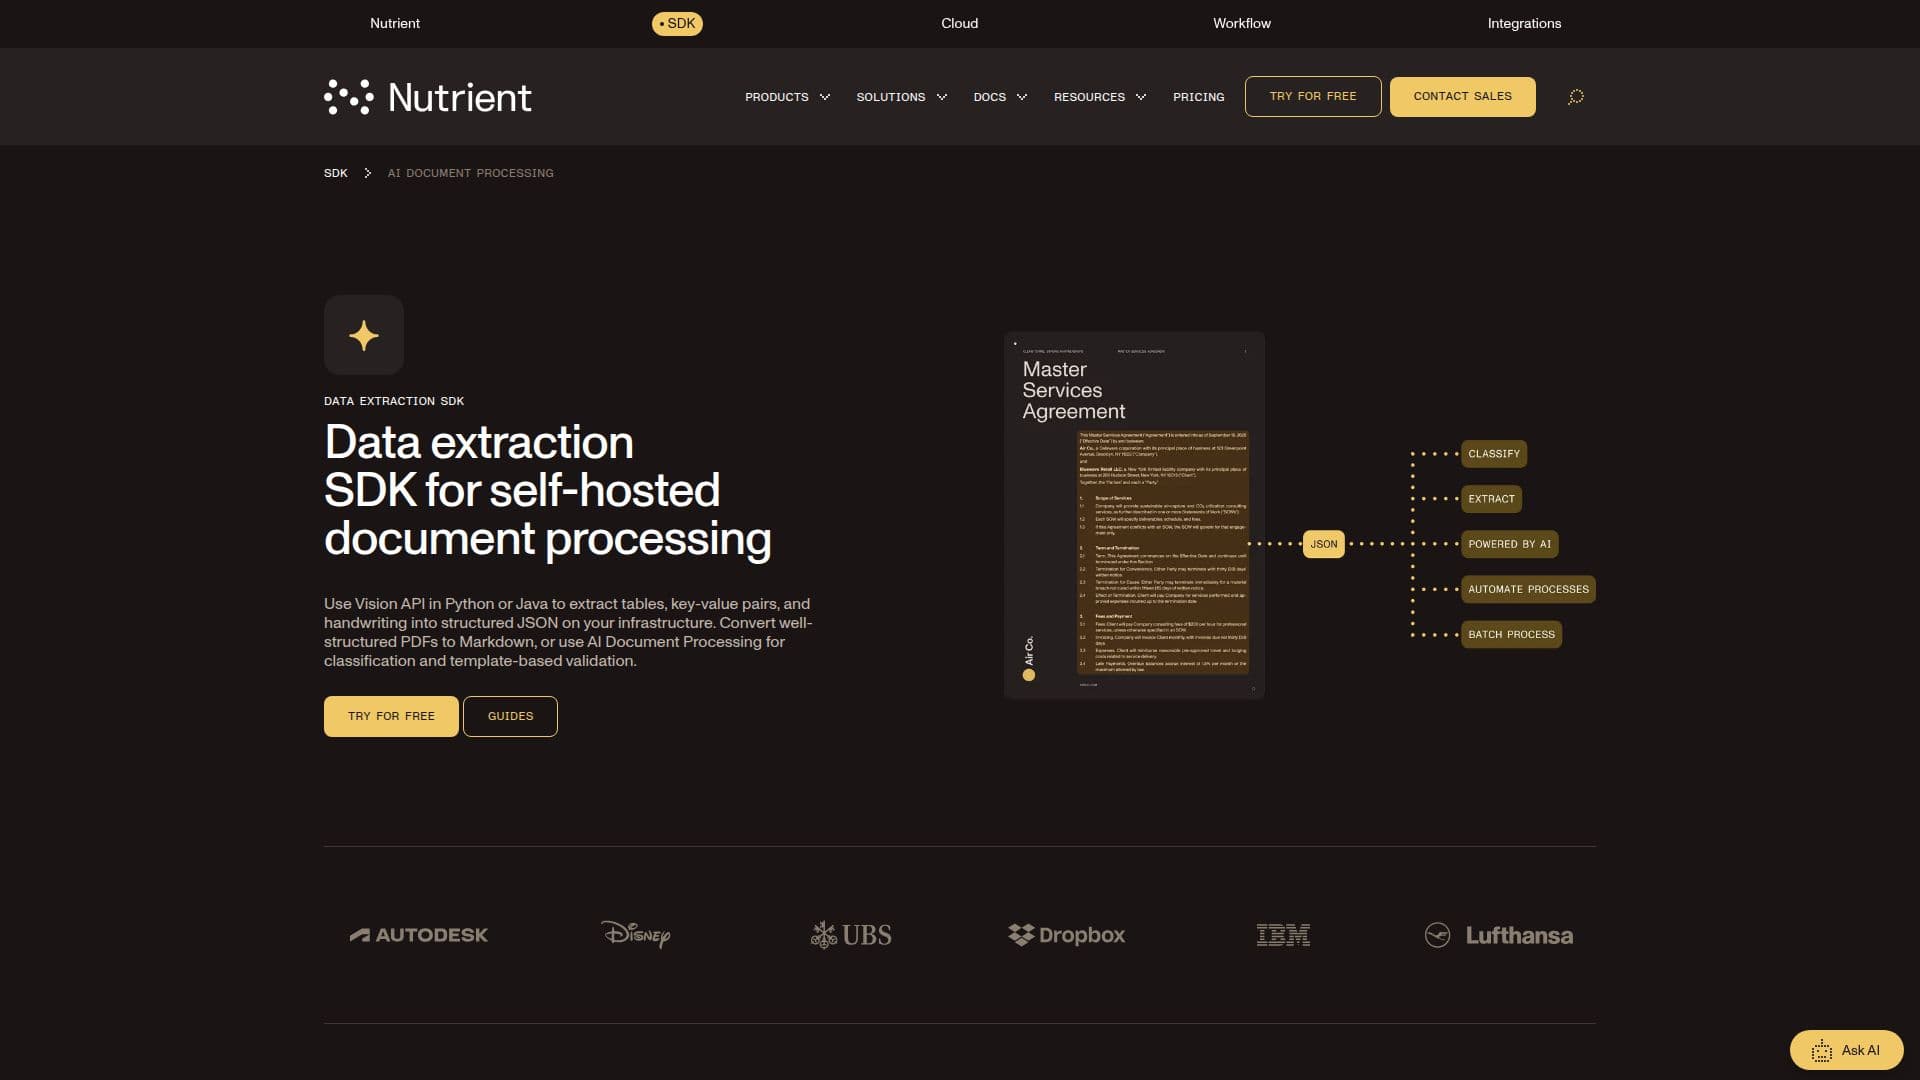
معالجة مستندات Nutrient AI هي مجموعة أدوات لاستخراج بيانات المستندات، كانت تُباع سابقًا تحت اسم XtractFlow من قبل Nutrient (المعروفة سابقًا باسم PSPDFKit). تعمل كجزء من مجموعات أدوات Nutrient لـ Python وJava ومصممة لمعالجة الفواتير وأوامر الشراء ومستندات الهوية والسير الذاتية والإيصالات على بنية الشركة التحتية الخاصة بدلاً من استخدام خدمة سحابية طرف ثالث.
قراءة المزيد
تقوم LLM بتحديد نوع المستند وتوجيهه إلى قالب استخراج مطابق؛ يتم شحن عشرة قوالب جاهزة للاستخدام، تغطي مستندات مثل الفواتير، وجوازات السفر، وبطاقات الهوية، والإيصالات، ويمكن بناء قوالب مخصصة من خلال وصف الحقول المطلوبة بلغة بسيطة بدلاً من كتابة قواعد أو تعبيرات منتظمة. يتم التحقق من القيم المستخرجة بواسطة أحد عشر مدققًا مدمجًا، بما في ذلك IBAN ورقم ضريبة القيمة المضافة ورقم بطاقة الائتمان والعنوان البريدي والبريد الإلكتروني ورقم الهاتف؛ أي قيمة تفشل في التحقق يتم الإشارة إليها على أنها تحتاج إلى تحقق بدلاً من قبولها بصمت.
تغطي صفحة المنتج نفسها مجموعة أدوات استخراج البيانات ذات المستوى الأدنى من Nutrient، والتي تعيد JSON منظم مع إحداثيات العناصر وترتيب القراءة ودرجات الثقة باستخدام OCR، ونماذج الذكاء الاصطناعي المحلية للتخطيط والتعرف على الكتابة اليدوية (ICR)، أو نموذج رؤية-لغة يمكن تشغيله محليًا مع Qwen أو الاتصال بمزود سحابي مثل Claude أو OpenAI. تقرأ أكثر من 100 نوع من الملفات، بما في ذلك ملفات PDF الممسوحة، ومستندات Office، وملفات CAD، وأكثر من 40 تنسيق RAW للكاميرا، وتتعامل مع تخطيطات متعددة الأعمدة، ولغات مختلطة، ومسحات مائلة. وضع PDF إلى Markdown منفصل يحول ملفات PDF الرقمية بالفعل إلى Markdown نظيف دون الحاجة إلى تشغيل أي نموذج ذكاء اصطناعي على الإطلاق.
تحتاج معالجة مستندات AI إلى مزود LLM متصل (OpenAI أو Azure OpenAI)؛ تعمل أوضاع OCR وICR وPDF إلى Markdown بالكامل على الموقع دون الحاجة إلى الوصول إلى الشبكة. تتوفر استخراج البيانات اليوم لـ Python (3.8+) وJava (8+)، مع تخطيط لـ .NET وواجهة برمجة تطبيقات DWS Processor كقريبًا؛ يتم تقديم تجربة مجانية دون الحاجة إلى معلومات الدفع.
هذه مجموعة أدوات للمطورين، وليست أداة بدون كود مستضافة، موجهة إلى فرق الهندسة التي تبني معالجة الفواتير، والتحقق من الهوية، أو خطوط أنابيب استلام المستندات التي تحتاج إلى التحكم في مكان ذهاب مستنداتها وبياناتها. الدعم عبر الأنظمة الأساسية لمعالجة مستندات AI يتجاوز توفرها الحالي مدرج كقريبًا بدلاً من الشحن اليوم.
- الفئةكشط الويب واستخراج البيانات
- نموذج التسعيرمبني على المكونات
- النشرمحلي، سحابي
- المنصاتبايثون، جافا
الميزات الأساسية لـ معالجة مستندات Nutrient AI
تصنيف المستندات المعتمد على LLM الذي يوجه كل مستند إلى قالب استخراج مطابق
عشرة قوالب جاهزة للفواتير وجوازات السفر وبطاقات الهوية والإيصالات والمزيد
قوالب استخراج مخصصة محددة بلغة بسيطة، دون الحاجة إلى تعبيرات منتظمة أو محرك قواعد
أحد عشر مدققًا مدمجًا (IBAN ورقم ضريبة القيمة المضافة ورقم بطاقة الائتمان والعنوان البريدي والبريد الإلكتروني ورقم الهاتف والمزيد)
ثلاثة محركات استخراج (OCR وICR وVLM) مدمجة في JSON منظم مع إحداثيات ودرجات ثقة
معالجة محلية لكل محرك، بما في ذلك نموذج رؤية-لغة، مع الاتصال بمزودي السحابة فقط إذا تم اختياره
دعم لأكثر من 100 نوع من الملفات، بما في ذلك ملفات PDF الممسوحة ومستندات Office وملفات CAD
تحويل PDF إلى Markdown لملفات PDF الرقمية، دون الحاجة إلى نموذج ذكاء اصطناعي أو الوصول إلى الشبكة
مجموعات أدوات Python وJava متاحة اليوم، مع تخطيط لـ .NET وواجهة برمجة تطبيقات DWS Processor
كيفية استخدام معالجة مستندات Nutrient AI؟
تثبيت مجموعة الأدوات: أضف مجموعة أدوات Nutrient Python أو Java إلى مشروعك.
اختيار وضع الاستخراج: اختر PDF إلى Markdown لملفات PDF الرقمية النظيفة، أو استخراج البيانات (OCR أو ICR أو VLM) للمسحات والتخطيطات المعقدة.
الاتصال بـ LLM (اختياري): لتفعيل معالجة مستندات AI، قم بتكوين مفتاح OpenAI أو Azure OpenAI لتمكين التصنيف والقوالب.
تشغيل الاستخراج: معالجة مستند واستلام JSON منظم مع إحداثيات ودرجات ثقة وترتيب القراءة.
التحقق من الحقول: تشير المدققون المدمجون إلى القيم، مثل IBAN أو رقم ضريبة القيمة المضافة، التي تفشل في التحقق من التنسيق.
نشر على بنيتك التحتية: تشغيل مجموعة الأدوات مستضافة ذاتيًا، حيث تبقى بيانات المستندات على شبكتك ما لم تتصل بمزود سحابي.
حالات استخدام معالجة مستندات Nutrient AI
- معالجة الفواتير
- التحقق من الهوية وجوازات السفر
- رقمنة المستندات الممسوحة
- خطوط بيانات مستضافة ذاتيًا