الوصف
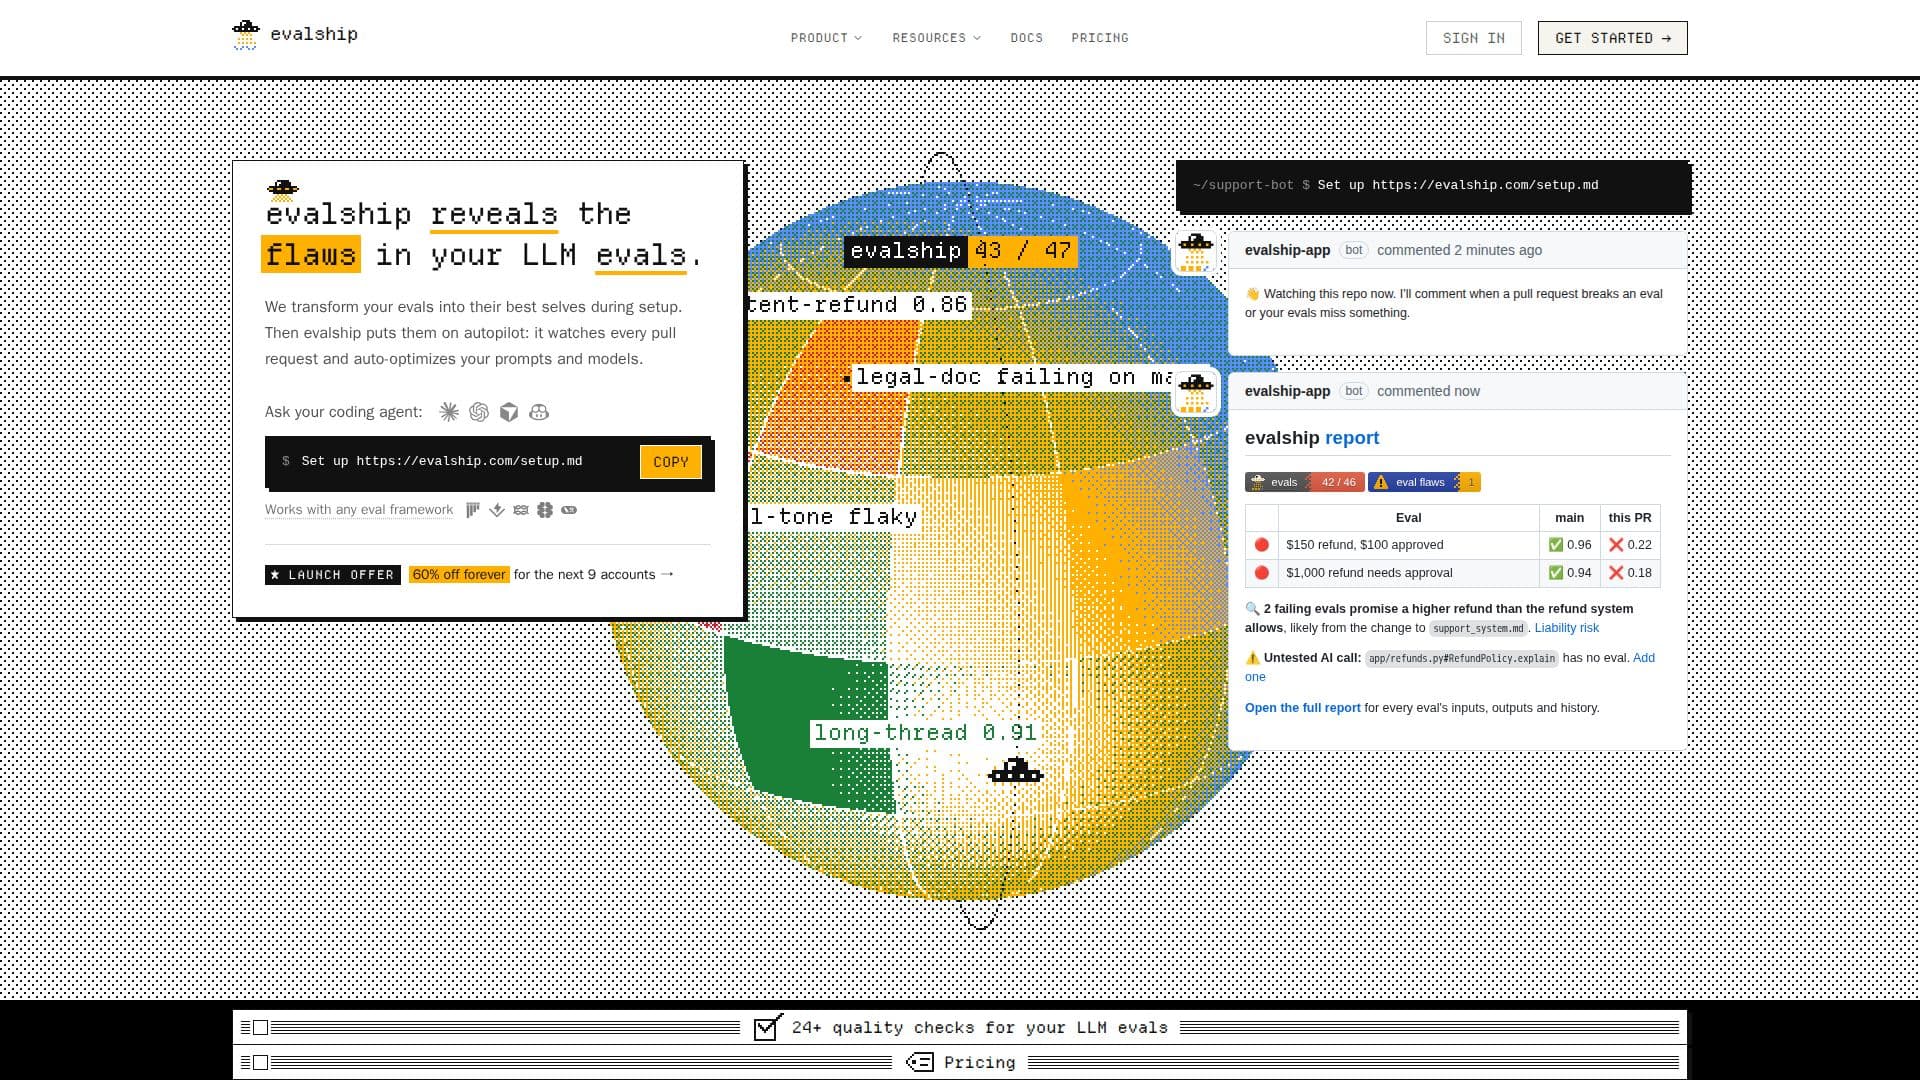
evalship تقدم حلاً شاملاً لمراقبة الجودة مصمم خصيصًا لتقييمات نماذج اللغة الكبيرة (LLM). تتكامل مباشرة في سير عمل GitHub الخاص بك، وتعمل كحارس يقظ لعملية تطوير LLM الخاصة بك. الغرض الأساسي من evalship هو تحديد ومعالجة العيوب في إعدادات التقييم الخاصة بك، مما يضمن أن تعمل LLM كما هو متوقع ولا تقدم تراجعات.
قراءة المزيد
عند الإعداد، تقوم evalship بمراجعة شاملة للمقيمين والحكام والمطالبات الحالية لتحديد نقاط الضعف مثل التقييمات التي تمر بشكل غير صحيح أو القواعد التي تفتقر إلى تغطية اختبار مناسبة. ثم تراقب كل طلب سحب، مقدمة ملاحظات فورية حول ما تعطل، ولماذا تعطل، والسبب المحتمل. يشمل ذلك الإشارة إلى مكالمات الذكاء الاصطناعي غير المختبرة وفصل التراجعات الحقيقية عن نتائج التقييم المتقطعة من خلال تحليل الأداء التاريخي على الفرع الافتراضي الخاص بك.
تعمل المنصة بسلاسة مع مجموعة متنوعة من أطر التقييم، بما في ذلك تلك التي تنتج JUnit XML، promptfoo JSON، أو evalship JSON، مثل pytest، Vitest، Jest، RSpec، Go، Java، PHPUnit، Rust، Langfuse، Braintrust، وLangSmith. لا تقوم بتشغيل تقييماتك مباشرة؛ بدلاً من ذلك، يقوم سير عمل GitHub Actions الخاص بك أو وكيل البرمجة بتنفيذها باستخدام مفاتيح API الخاصة بك، وتقوم evalship بمعالجة النتائج.
بعيدًا عن تحديد المشكلات، تساعد evalship في تحسين المطالبات والنماذج الخاصة بك. من خلال وكيل البرمجة الخاص بك، تختبر تغييرات مختلفة على جهازك، مثل النماذج الأرخص أو القواعد الأكثر وضوحًا، وتبلغ عن التغييرات التي تحقق تحسينات ذات دلالة إحصائية. يتيح ذلك للفرق اتخاذ قرارات مستندة إلى البيانات لتعزيز أداء النموذج وكفاءة التكلفة. كما تقدم evalship تقارير أسبوعية تلخص أداء التقييم وتبرز القضايا الحرجة التي تم اكتشافها قبل وصولها إلى الإنتاج.
تشمل التسعيرات مستوى مجاني للمستودعات العامة ومستودع خاص واحد مع مستخدم واحد، مما يوفر 100 تحليل PR و30 يومًا من تاريخ التقييم. تقدم الخطط المدفوعة (فريق، محترف، أعمال) عددًا أكبر من المستخدمين، ومستودعات خاصة، وتحليلات PR، وتاريخ تقييم أطول، مع خيارات للفوترة الشهرية أو السنوية. تقدم عرض إطلاق خصومات كبيرة للمستخدمين الأوائل. تضمن evalship الأمان من خلال عدم تخزين كود المصدر أو مفاتيح API الخاصة بك، بل تعالج فقط الفروقات ونتائج التقييم.
- الفئةمراجعة الشيفرة واختبارها بالذكاء الاصطناعي
- نموذج التسعيرمجاني مع ميزات مدفوعة
- النشرسحابي
- المنصاتالويب
الميزات الأساسية لـ evalship
تحديد العيوب في تقييمات LLM أثناء الإعداد
تعليق على كل طلب سحب مع تحليل مفصل لفشل التقييم
تحسين تلقائي للمطالبات والنماذج بناءً على بيانات الأداء
يعمل مع أي إطار تقييم موجود (JUnit XML، promptfoo، evalship JSON)
يوفر أكثر من 24 فحص جودة لتقييمات LLM
يفصل التراجعات عن التقييمات المتقطعة باستخدام البيانات التاريخية
يكتشف مكالمات الذكاء الاصطناعي غير المختبرة في طلبات السحب
يمنع الدمج الذي يكسر قواعد التقييم (قابل للتكوين)
يفتح طلبات السحب بمجرد إصلاح المشكلات
يرسل تقارير تقييم أسبوعية تلخص الأداء والمشكلات
يدعم المستودعات الأحادية وسير عمل تقييمات متعددة
يتكامل مع Langfuse وBraintrust وLangSmith دون الحاجة إلى تغيير
يقدم مراجعة مجانية للتقييمات عند الإعداد
يسمح لوكلاء البرمجة بالتحقق من التغييرات قبل فتح طلبات السحب
يضمن الأمان بعدم تخزين كود المصدر أو مفاتيح API
كيفية استخدام evalship؟
الإعداد: قم بتوصيل مستودع GitHub الخاص بك واطلب من وكيل البرمجة الخاص بك إعداد evalship، الذي يقوم بمراجعة تقييماتك وإنشاء طلب سحب للإعداد.
مراقبة طلبات السحب: evalship تراقب تلقائيًا كل طلب سحب، مع التعليق على التغييرات التي تكسر التقييمات أو تقدم مكالمات ذكاء اصطناعي غير مختبرة.
مراجعة التقارير: الوصول إلى تقارير مفصلة لكل تقييم من المدخلات والمخرجات والتاريخ لفهم ما تعطل ولماذا.
تحسين: استخدم ميزة تحسين evalship لاختبار تغييرات المطالبات والنماذج مع وكيل البرمجة الخاص بك، وتحديد التحسينات التي تتجاوز الصدفة.
استلام التقارير: احصل على تقارير أسبوعية عبر البريد الإلكتروني تلخص أداء التقييم وتبرز القضايا الحرجة التي تم اكتشافها قبل الدمج.
حالات استخدام evalship
- مراقبة جودة تقييم LLM
- مراجعة طلب السحب التلقائية
- تحسين المطالبات والنماذج
- منع التراجعات
- كشف مكالمات الذكاء الاصطناعي غير المختبرة
- إدارة التقييمات المتقطعة
- الامتثال وتقليل مخاطر المسؤولية
- تعزيز سير عمل المطورين