تخطَّ إلى المحتوى الرئيسي
ToolPotion
مستشار الذكاء الاصطناعي
إرسال (مجاني)

Confident AI

يوفر Confident AI منصة شاملة لتقييم نماذج اللغة الكبيرة (LLM) التي تقارن أنظمة الذكاء الاصطناعي، وتقارن بين المطالبات والنماذج، وتحدد التراجعات باستخدام مقاييس مدعومة بالأبحاث. يدعم اختبار المحادثات متعددة الأدوار ويسمح للمستخدمين بالتجربة دون اختناقات هندسية.

زيارة الرابط
مشاركة
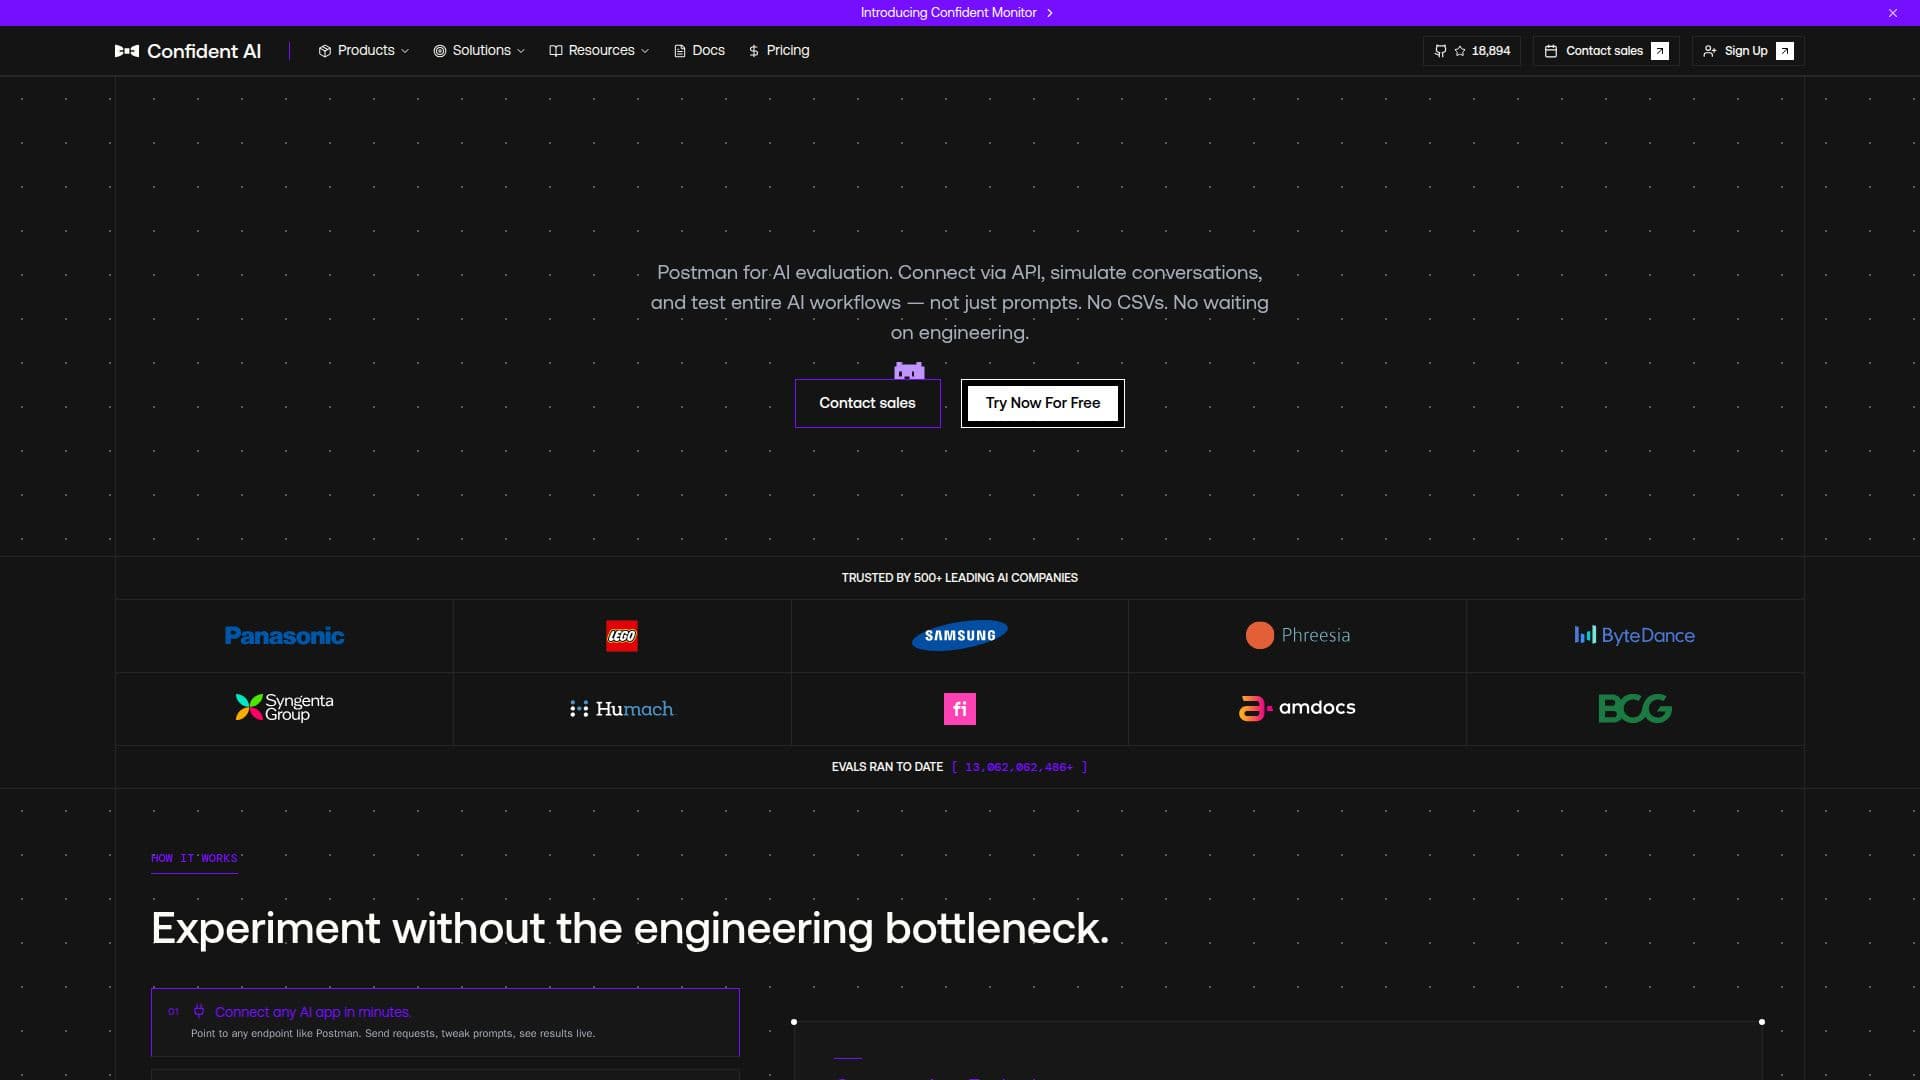
لقطة شاشة لـ Confident AI

يقدم Confident AI منصة قوية لتقييم نماذج اللغة الكبيرة (LLMs). تم بناؤها بواسطة مبتكري DeepEval، تتيح للمستخدمين تقييم أنظمة الذكاء الاصطناعي، ومقارنة المطالبات والنماذج، واكتشاف التراجعات باستخدام أكثر من 50 مقياسًا مدعومًا بالأبحاث. تقيم هذه المقاييس الجودة، والنبرة، والسلامة، والمزيد، مستفيدة من مقيمات LLM-as-a-judge.

قراءة المزيد

تدعم المنصة اختبار المحادثات متعددة الأدوار، مما يمكّن المستخدمين من محاكاة محادثات كاملة وتحديد الفشل الذي قد يظهر فقط عبر تبادلات متعددة. يمكن للمستخدمين تغيير المتغيرات مثل النماذج، والمطالبات، ومنطق النظام، وإجراء تجارب لمقارنة النتائج جنبًا إلى جنب عبر كل مقياس وخطوة في خط الأنابيب.

تم تصميم Confident AI ليكون سهل الاستخدام، مما يسمح لمديري المنتجات والخبراء في المجال بتعديل المطالبات، وإجراء التجارب، وتقييم النتائج دون الحاجة إلى دعم هندسي. يدعم مقدمي LLM الرئيسيين مثل OpenAI وAnthropic وGoogle، ويتكامل مع مقدمي الخدمات السحابية والبوابات.

تبدأ أسعار Confident AI من 0 دولار للمطورين الأفراد، مع خطط تتدرج حتى 2000 دولار شهريًا للفرق التي تدير ذكاءً اصطناعيًا حيويًا للأعمال. يتم تخصيص تسعير المؤسسات بناءً على احتياجات المنظمة. تقدم المنصة مستوى مجاني مع حدود سخية، ويمكن للمستخدمين الترقية أو الانخفاض في الخطط في أي وقت.

يثق في Confident AI الشركات التي تعطي الأولوية لجودة الذكاء الاصطناعي، حيث تقدم أدوات لتحويل الفشل في الإنتاج إلى مجموعات بيانات، ومحاذاة المقاييس، ومنع التراجعات دون الحاجة إلى عمل هندسي مخصص. يوفر الوقت بشكل كبير في تقييم الذكاء الاصطناعي ويقدم بيانات لدعم قرارات الجودة عبر الفرق.

  • الفئةمنصّات تعلّم الآلة
  • نموذج التسعيرمجاني مع ميزات مدفوعة
  • النشرسحابي
  • المنصاتالويب

  • مجموعة تقييم LLM

  • أكثر من 50 مقياس مدعوم بالأبحاث

  • اختبار المحادثات متعددة الأدوار

  • بدون اعتماد على الهندسة

  • يدعم مقدمي LLM الرئيسيين

  • مقارنة التجارب جنبًا إلى جنب

  • نماذج تقييم قابلة للتخصيص

  • تكامل مع خطوط أنابيب CI/CD

  1. الاتصال: الإشارة إلى أي نقطة نهاية لتطبيق الذكاء الاصطناعي

  2. التعريف: تحميل حالات الاختبار وتحديد المقاييس

  3. التنفيذ: تنفيذ التجارب على التطبيقات الحية

  4. الشحن: دمج التقييمات في CI لفحوصات الجودة

  • تقييم الذكاء الاصطناعي
  • اختبار المطالبات
  • كشف التراجعات
  • المحادثات متعددة الأدوار
  • تقييم النموذج المخصص

من Confident AI

تقييمات Confident AI

جاري التحميل...

أدوات ذكاء اصطناعي شائعة مثل Confident AI

تقدم Evidently AI أدوات مفتوحة المصدر لتقييم ومراقبة تطبيقات الذكاء الاصطناعي. تساعد في ضمان جاهزية أنظمة الذكاء الاصطناعي للإنتاج من خلال اختبار نماذج اللغة الكبيرة ومراقبة…

MLOps ونشر النماذج

المرتبة 24 في MLOps ونشر النماذج

عرض الأداة

تقدم Evidently AI أدوات مفتوحة المصدر لتقييم ومراقبة تطبيقات الذكاء الاصطناعي. تساعد في ضمان جاهزية أنظمة الذكاء الاصطناعي للإنتاج من خلال اختبار نماذج اللغة الكبيرة ومراقبة…

MLOps ونشر النماذج
المرتبة 24 في MLOps ونشر النماذج

ChainForge

تطبيقات الذكاء الاصطناعي

ChainForge هو بيئة برمجة بصرية مفتوحة المصدر مصممة لهندسة الطلبات. تتيح للمستخدمين تقييم الطلبات ونماذج توليد النصوص بفعالية، مما يجعل العملية ممتعة وسهلة.

أدوات هندسة الأوامر

المرتبة 20 في أدوات هندسة الأوامر

عرض الأداة

تطبيقات الذكاء الاصطناعي

بيئة برمجة بصرية مفتوحة المصدر مصممة لهندسة الطلبات. تتيح للمستخدمين تقييم الطلبات ونماذج توليد النصوص بفعالية، مما يجعل العملية ممتعة وسهلة.ChainForge هو بيئة برمجة بصرية مفتوحة المصدر مصممة لهندسة الطلبات. تتيح للمستخدمين تقييم الطلبات ونماذج توليد النصوص بفعالية، مما يجعل العملية ممتعة وسهلة.

أدوات هندسة الأوامر
المرتبة 20 في أدوات هندسة الأوامر

Future AGI

تطبيقات الذكاء الاصطناعي

Future AGI هي منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…

MLOps ونشر النماذج

المرتبة 42 في MLOps ونشر النماذج

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…Future AGI هي منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…

مميزةMLOps ونشر النماذج
المرتبة 42 في MLOps ونشر النماذج

LangWatch

تطبيقات الذكاء الاصطناعي

LangWatch هي منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…

MLOps ونشر النماذج

المرتبة 14 في أدوات هندسة الأوامر

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…LangWatch هي منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…

مميزةMLOps ونشر النماذج
المرتبة 14 في أدوات هندسة الأوامر

Entry Point AI

تطبيقات الذكاء الاصطناعي

Entry Point AI هي منصة بدون كود لضبط نماذج اللغة الكبيرة. تتيح للمستخدمين إدارة المطالبات، والضبط الدقيق، والتقييمات في مكان واحد. قم بتحسين النماذج الخاصة والمفتوحة المصدر للحصول…

منصّات تعلّم الآلة

المرتبة 87 لـ تحسين نماذج AI

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة بدون كود لضبط نماذج اللغة الكبيرة. تتيح للمستخدمين إدارة المطالبات، والضبط الدقيق، والتقييمات في مكان واحد. قم بتحسين النماذج الخاصة والمفتوحة المصدر للحصول…Entry Point AI هي منصة بدون كود لضبط نماذج اللغة الكبيرة. تتيح للمستخدمين إدارة المطالبات، والضبط الدقيق، والتقييمات في مكان واحد. قم بتحسين النماذج الخاصة والمفتوحة المصدر للحصول…

منصّات تعلّم الآلة
المرتبة 87 لـ تحسين نماذج AI

تقييم Deepchecks LLM

تطبيقات الذكاء الاصطناعي

تقييم Deepchecks LLM هو منصة من الدرجة المؤسسية لاختبار الذكاء الاصطناعي، والمراقبة، والرصد. توفر رؤية، وتحكم، وثقة عبر أنظمة الذكاء الاصطناعي في الإنتاج، مما يضمن الدقة والاتساق…

MLOps ونشر النماذجالرعاية الصحية وعلوم الحياة

المرتبة 90 في MLOps ونشر النماذج

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة من الدرجة المؤسسية لاختبار الذكاء الاصطناعي، والمراقبة، والرصد. توفر رؤية، وتحكم، وثقة عبر أنظمة الذكاء الاصطناعي في الإنتاج، مما يضمن الدقة والاتساق…تقييم Deepchecks LLM هو منصة من الدرجة المؤسسية لاختبار الذكاء الاصطناعي، والمراقبة، والرصد. توفر رؤية، وتحكم، وثقة عبر أنظمة الذكاء الاصطناعي في الإنتاج، مما يضمن الدقة والاتساق…

MLOps ونشر النماذجالرعاية الصحية وعلوم الحياة
المرتبة 90 في MLOps ونشر النماذج

Revalvo

تطبيقات الذكاء الاصطناعي

Revalvo هو منصة تقييم LLM تعتمد على النظام المحلي تسمح للمستخدمين بتشغيل الطلبات على نماذج متعددة في وقت واحد. يوفر تقييمًا في الوقت الفعلي، والتحكم في الإصدارات، وواجهة خالية من…

أدوات هندسة الأوامر

المرتبة 82 في أدوات هندسة الأوامر

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة تقييم LLM تعتمد على النظام المحلي تسمح للمستخدمين بتشغيل الطلبات على نماذج متعددة في وقت واحد. يوفر تقييمًا في الوقت الفعلي، والتحكم في الإصدارات، وواجهة خالية من…Revalvo هو منصة تقييم LLM تعتمد على النظام المحلي تسمح للمستخدمين بتشغيل الطلبات على نماذج متعددة في وقت واحد. يوفر تقييمًا في الوقت الفعلي، والتحكم في الإصدارات، وواجهة خالية من…

أدوات هندسة الأوامر
المرتبة 82 في أدوات هندسة الأوامر

H2O Eval Studio

تطبيقات الذكاء الاصطناعي

H2O Eval Studio هو منصة معيارية مصممة لتقييم الأداء والموثوقية والأمان لتطبيقات الجيل المعزز بالاسترجاع ونماذج اللغة الكبيرة. تقدم لوحات معلومات تنفيذية، ومقيمين قابلين للتخصيص،…

MLOps ونشر النماذج

المرتبة 77 في MLOps ونشر النماذج

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة معيارية مصممة لتقييم الأداء والموثوقية والأمان لتطبيقات الجيل المعزز بالاسترجاع ونماذج اللغة الكبيرة. تقدم لوحات معلومات تنفيذية، ومقيمين قابلين للتخصيص،…H2O Eval Studio هو منصة معيارية مصممة لتقييم الأداء والموثوقية والأمان لتطبيقات الجيل المعزز بالاسترجاع ونماذج اللغة الكبيرة. تقدم لوحات معلومات تنفيذية، ومقيمين قابلين للتخصيص،…

MLOps ونشر النماذج
المرتبة 77 في MLOps ونشر النماذج
1 من 8