Descrição
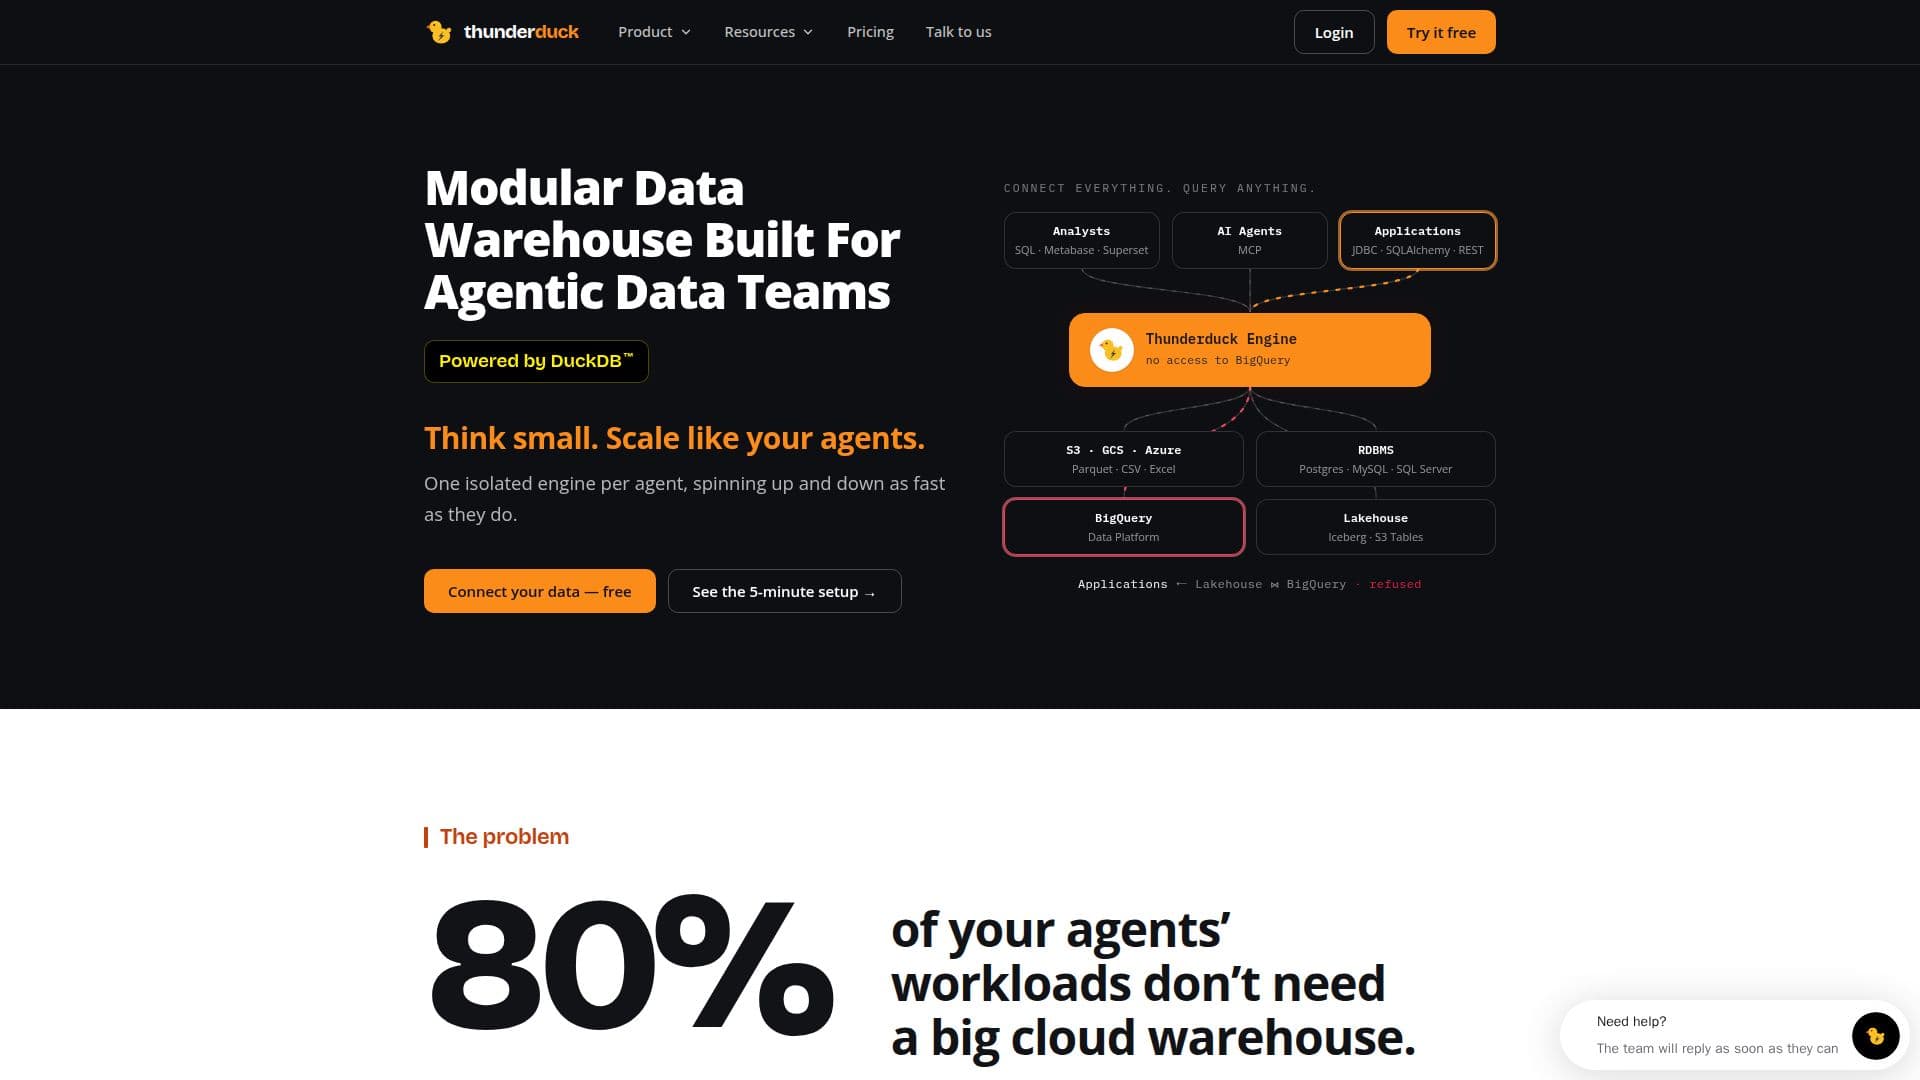
Thunderduck oferece uma solução de armazém de dados modular especificamente projetada para equipes de dados agentes, aproveitando o poder do DuckDB. Ele aborda o problema comum onde 80% das cargas de trabalho dos agentes não requerem um grande armazém em nuvem, mas as equipes incorrem em custos significativos de sistemas distribuídos e prêmios de serviços gerenciados. Ao fornecer um motor isolado por agente, Thunderduck permite que os motores sejam ativados e desativados rapidamente, correspondendo à natureza dinâmica das cargas de trabalho agentes.
Ler mais
A plataforma é projetada para fornecer consultas em menos de um segundo em terabytes de dados, independentemente do número de agentes em execução. Ela simplifica a construção de pipelines de dados e automatiza tarefas de DevOps, tudo isso mantendo a governança de nível empresarial. Os usuários têm a flexibilidade de implantar o Thunderduck em qualquer lugar, seja localmente com flexibilidade semelhante à nuvem ou dentro de sua infraestrutura de nuvem existente.
Em sua essência, Thunderduck utiliza o DuckDB, um banco de dados analítico de código aberto e em processo com um motor vetorizado. Essa arquitetura significa que ele é executado onde seu código é executado, eliminando a necessidade de gerenciamento de servidores. Ele suporta multi-inquilinos e oferece segurança de nível empresarial, garantindo a soberania dos dados ao manter os dados dentro da nuvem ou do centro de dados do usuário sob suas regras de acesso.
Thunderduck facilita a integração perfeita com agentes de IA como Claude, ChatGPT ou Cursor via MCP. Os agentes podem interpretar significados de tabelas e colunas, não apenas nomes, para encontrar as tabelas corretas, ler partições e índices, e escrever consultas eficientes. Essas consultas são executadas sob funções e limites de custo predefinidos. A plataforma também pode automatizar a construção de modelos dbt, seguindo camadas de medalhão, testando em branches e abrindo pull requests para manter data marts limpos e gerenciáveis.
Ela suporta federação de consultas com zero ETL, permitindo que os usuários unam dados de várias fontes como Postgres, BigQuery, tabelas Iceberg e arquivos em uma única consulta, com filtros aplicados a cada fonte. Isso elimina a necessidade de cópias de dados, trabalhos de carga ou supervisão de sincronização para dados pequenos e ad-hoc. Quando os conjuntos de dados crescem ou requerem modelagem, os usuários podem construir pipelines dbt em Iceberg e continuar consultando-os de forma consistente. Thunderduck também fornece estimativas de custo para cada consulta antes de sua execução, permitindo controle orçamentário e prevenindo despesas inesperadas.
- CategoriaFerramentas de SQL e banco de dados com IA
- Modelo de preçosFreemium
- ImplantaçãoNuvem, Local
- PlataformasWeb
Recursos principais de Thunderduck
Arquitetura modular de armazém de dados
Um motor DuckDB isolado por agente
Consultas em menos de um segundo em terabytes de dados
Opções de implantação local ou em nuvem
Tarefas de DevOps automatizadas
Governança de nível empresarial
Suporte a multi-inquilinos
Menor latência sem sobrecarga distribuída
Soberania dos dados e regras de acesso
Integração com agentes de IA (Claude, ChatGPT, Cursor) via MCP
Geração de consultas assistida por IA e construção de modelos dbt
Federação de consultas entre fontes diversas (PostgreSQL, BigQuery, Iceberg, S3)
Descoberta automática de esquemas, tabelas, colunas e tipos
Estimativa de custo e tempo de execução para cada consulta antes da execução
Diagnóstico de consultas falhadas assistido por IA e sugestões de correções
Controle de acesso baseado em funções para catálogos
Cache de consultas para consultas repetidas instantâneas e gratuitas
Como usar Thunderduck?
Conectar um Catálogo: Forneça credenciais para suas fontes de dados, como bancos de dados, armazéns, lakehouses ou armazenamento de objetos.
Descobrir Dados: Thunderduck lê automaticamente esquemas, tabelas, colunas e infere significados de colunas, mantendo-os atualizados.
Consultar e Juntar: Aborde qualquer tabela como catalog.schema.table e junte-se a várias fontes em uma única instrução SQL.
Integrar Agentes de IA: Conecte Claude, ChatGPT ou outros clientes MCP para permitir que agentes de IA naveguem pelos catálogos e executem SQL.
Automatizar Fluxos de Trabalho: Programe instruções SQL em um cronograma ou conecte repositórios dbt para executar builds, testes e snapshots.
Monitorar e Governar: Utilize estimativas de custo pré-consulta, logs de auditoria e controle de acesso baseado em funções para gerenciar uso e segurança.
Casos de uso de Thunderduck
- Cargas de Trabalho de Dados Agentes
- Otimização de Custos para Equipes de Dados
- Análise de Dados em Tempo Real
- Automação de Pipeline de Dados
- Soberania e Segurança dos Dados
- Consulta Assistida por IA
- Juntando Dados de Múltiplas Fontes
- Gerenciamento Proativo de Custos
- Governança e Auditoria de Dados
- Construção de Lakehouses