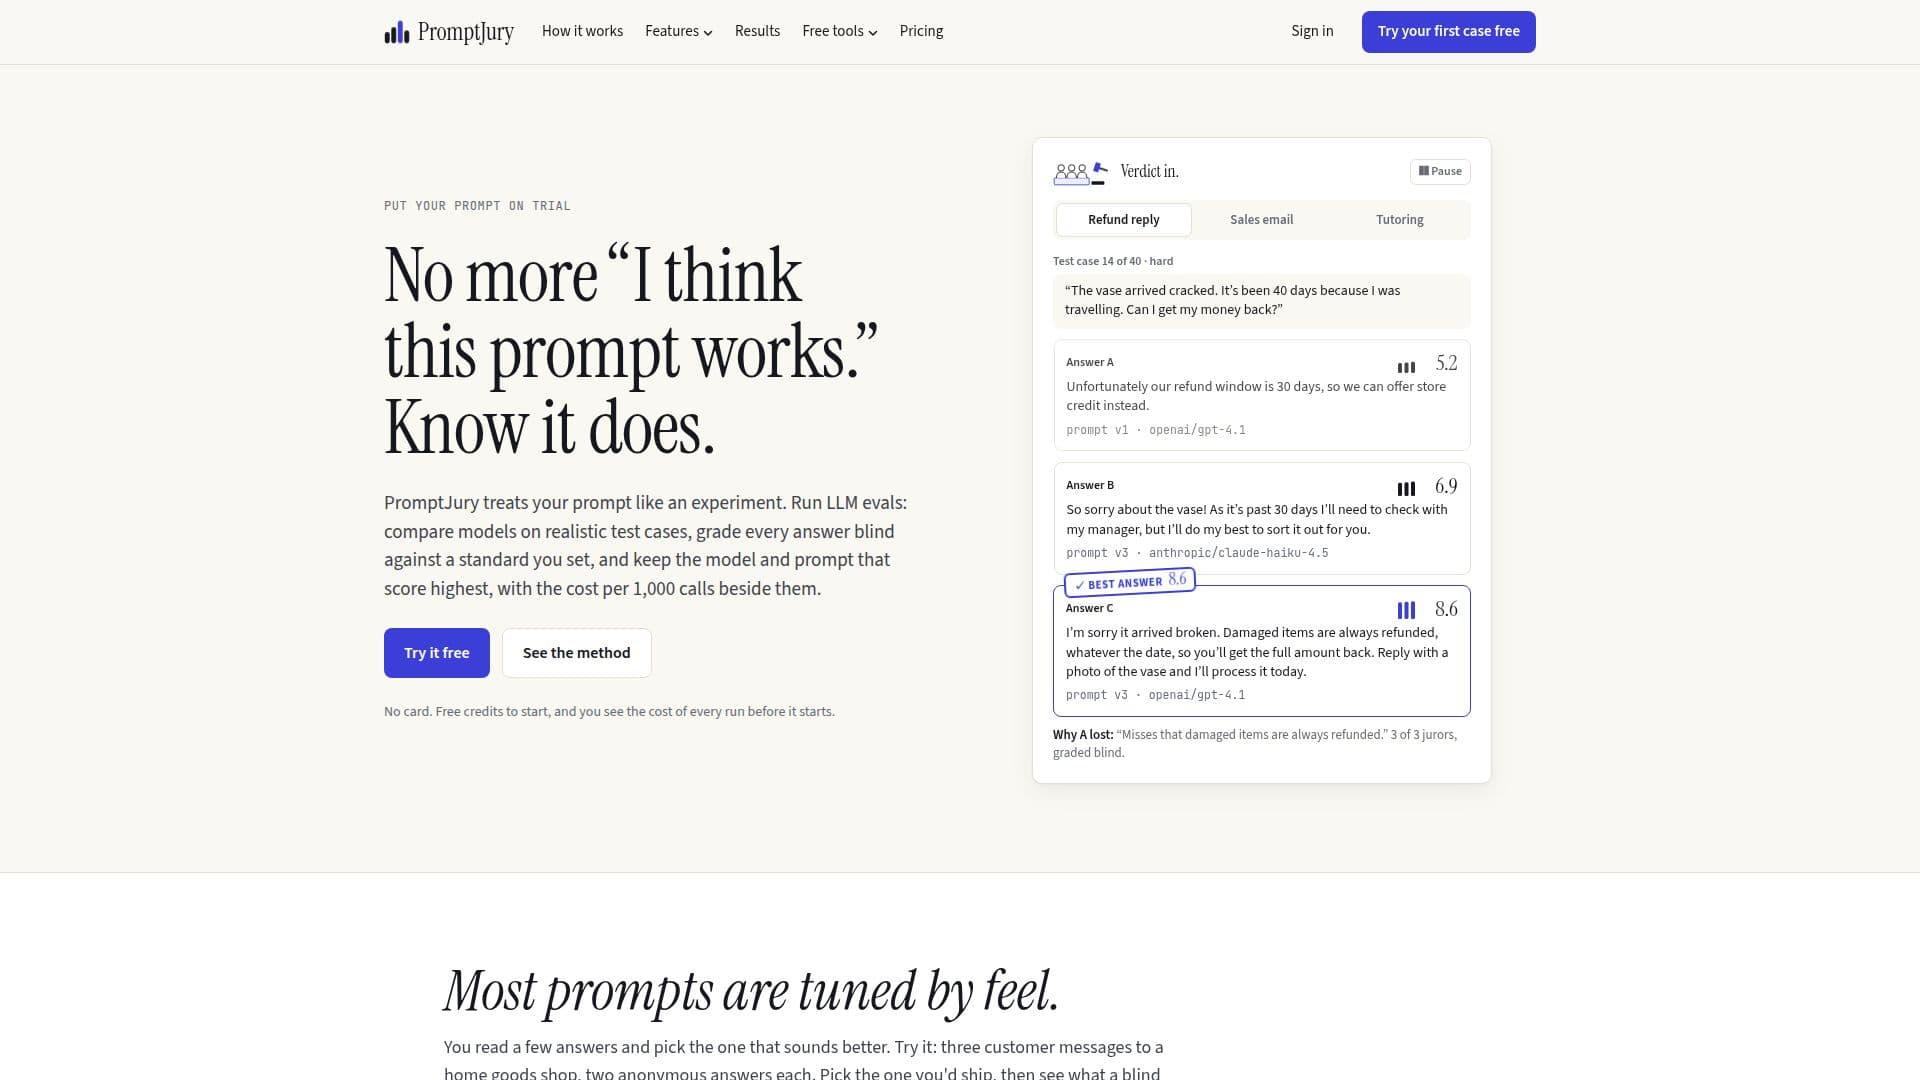
Descrição
PromptJury oferece uma plataforma abrangente para avaliar Modelos de Linguagem de Grande Escala (LLMs) e prompts, projetada para ajudar os usuários a tomar decisões baseadas em dados sobre suas aplicações de IA. O serviço permite que indivíduos e equipes realizem avaliações de LLM em seus prompts personalizados, comparando modelos como GPT, Claude e Gemini em casos de teste avaliados de forma cega.
Ler mais
Esse processo revela quais combinações de modelo e prompt alcançam as maiores pontuações e qual é o custo de cada opção, proporcionando uma abordagem científica para a engenharia de prompts.
Diferente das plataformas de avaliação centradas em desenvolvedores que exigem SDKs, configurações personalizadas e conjuntos de testes fornecidos pelo usuário, o PromptJury simplifica todo o fluxo de trabalho de avaliação. Ele gera automaticamente guias de avaliação e casos de teste, elabora prompts rivais e realiza a avaliação cega utilizando um júri diversificado de modelos de vários fabricantes. A plataforma então fornece uma recomendação clara, incluindo o prompt vencedor, o modelo e seu custo associado, tudo isso sem exigir qualquer expertise em codificação.
O PromptJury garante o rigor científico de suas avaliações ao estabelecer uma definição clara de uma "boa resposta" antes que qualquer pontuação comece. Cada prompt e modelo é submetido ao mesmo conjunto de casos de teste, e a avaliação é realizada de forma cega. Cada pontuação é apresentada com uma faixa, permitindo que os usuários avaliem com precisão o impacto de quaisquer alterações feitas em seus prompts ou modelos. O sistema aborda preocupações sobre a avaliação de IA por IA, garantindo que o padrão de avaliação seja aprovado pelo usuário, múltiplos modelos de diferentes fabricantes avaliem as respostas sem conhecer a origem, e nenhum modelo avalie sua própria saída. A pontuação mediana de três ou mais avaliadores previne viés de um único jurado severo ou generoso.
Os usuários podem comparar qualquer modelo de chat disponível na lista ao vivo do OpenRouter, incluindo ofertas da OpenAI, Anthropic, Google, xAI, DeepSeek e Mistral. A plataforma também ajuda a identificar modelos mais baratos que apresentam desempenho comparável aos principais concorrentes, fornecendo uma "escolha de valor" ao lado do vencedor. Isso inclui dados de custo por 1.000 chamadas e potenciais economias mensais com base em volumes de chamadas definidos pelo usuário. Novas contas recebem 200 créditos gratuitos para realizar uma avaliação inicial sem exigir um cartão de crédito, com planos pagos a partir de $25 por mês. O serviço não requer chaves de API, SDKs ou uma conta OpenRouter, pois todas as chamadas de modelo são gerenciadas através da própria conta OpenRouter do PromptJury e pagas com créditos do usuário. A plataforma suporta saídas subjetivas permitindo que os usuários definam dimensões de qualidade com exemplos escritos para avaliação. Os usuários também podem enviar seus próprios casos de teste via arquivos CSV ou JSONL ou editar os gerados pelo sistema. O PromptJury afirma explicitamente que não treina com prompts ou dados do usuário, garantindo privacidade e controle sobre o conteúdo do usuário.
- CategoriaFerramentas de engenharia de prompts
- Modelo de preçosFreemium
- ImplantaçãoNuvem
- PlataformasWeb
Recursos principais de PromptJury
Plataforma de Avaliação de LLM
Comparar GPT, Claude, Gemini e outros modelos
Casos de teste avaliados de forma cega
Geração automatizada de casos de teste
Criação automatizada de guias de avaliação
Elabora prompts rivais
Processo de avaliação sem codificação
Custo por 1.000 chamadas exibido
Identifica escolha de valor (modelo bom mais barato)
Suporta avaliação de saídas subjetivas
Carregar casos de teste personalizados (CSV, JSONL)
Nenhuma chave de API ou SDK necessária
Não treina com dados do usuário
Testes de regressão programados (reavaliações)
Relatórios de veredicto privados
Como usar PromptJury?
Descrever Tarefa: Defina o objetivo da sua IA e seu público em duas frases.
Criar Guia de Avaliação: Aprove o que uma ótima resposta parece, dimensão por dimensão, com uma escala para cada uma.
Gerar Prompts Concorrentes: Permita que os modelos elaborem prompts rivais e critiquem uns aos outros com base no seu guia de avaliação.
Coletar Casos de Teste: Use entradas realistas geradas pelo sistema ou envie seu próprio arquivo CSV/JSONL.
Executar Teste Cego: Cada prompt e modelo responde a cada caso de teste, com um painel separado avaliando as respostas de forma cega.
Revisar Veredicto e Melhorar: Obtenha o melhor prompt e modelo, com provas e sugestões para melhorias adicionais.
Casos de uso de PromptJury
- Otimização de Prompt
- Comparação de Modelos
- Garantia de Qualidade
- Eficiência de Custo
- Avaliação de Saídas Subjetivas
- Testes de Regressão
- Relatórios para Clientes
- Desenvolvimento de Recursos de IA