Descrição
O Contador de Tokens de Prompt para Modelos OpenAI é uma utilidade online essencial projetada para auxiliar os usuários no gerenciamento de suas interações com modelos de linguagem grandes. Ao trabalhar com modelos de IA como o GPT-3.5 da OpenAI, entender e aderir aos limites de tokens é crucial. Esses limites ditam a quantidade máxima de texto, compreendendo tanto os prompts de entrada quanto as respostas de saída, que um modelo pode processar em uma única interação. Esta ferramenta fornece uma maneira direta de contar tokens em seus prompts, ajudando você a permanecer dentro dessas fronteiras.
Ler mais
Tokens são as unidades fundamentais de texto que os modelos de linguagem processam. Eles podem representar palavras, partes de palavras, caracteres ou pontuação, dependendo do tokenizador específico empregado pelo modelo. Cada token consome recursos computacionais e contribui para a contagem total de tokens. Exceder o limite de tokens de um modelo pode levar à rejeição de solicitações ou ao truncamento de respostas, prejudicando a comunicação eficaz com a IA.
O Contador de Tokens de Prompt é vital por várias razões. Primeiro, garante que seus prompts permaneçam dentro dos limites máximos de tokens dos modelos OpenAI que você está usando, prevenindo erros e garantindo a execução bem-sucedida da consulta. Segundo, auxilia no controle de custos, pois muitos modelos de IA cobram com base no número de tokens processados. Ao rastrear com precisão o uso de tokens, os usuários podem gerenciar despesas com mais eficiência e evitar custos desnecessários. Terceiro, auxilia no gerenciamento de respostas; ao estimar a contagem de tokens de respostas potenciais, os usuários podem ajustar seus prompts para acomodar os comprimentos de saída desejados. Finalmente, promove a comunicação eficiente, incentivando prompts concisos e claros, garantindo que o modelo compreenda com precisão a intenção do usuário sem verbosidade.
Para usar efetivamente um contador de tokens, os usuários devem primeiro se familiarizar com os limites de tokens de seu modelo OpenAI escolhido, como o limite de 4096 tokens do GPT-3.5-turbo. Recomenda-se pré-processar prompts usando técnicas de tokenização semelhantes às do próprio modelo, muitas vezes facilitadas por bibliotecas como o tokenizador OpenAI GPT-3. Após a tokenização, o número de tokens pode ser contado, lembrando que pontuação, espaços e caracteres especiais também contribuem. Os usuários também devem considerar a contagem esperada de tokens da resposta do modelo e refinar iterativamente seus prompts se excederem os limites permitidos. Este processo iterativo garante que os prompts sejam otimizados tanto para comprimento quanto para clareza, levando a uma experiência de interação de IA mais suave e econômica.
- CategoriaFerramentas de engenharia de prompts
- Modelo de preçosGrátis
- ImplantaçãoNuvem
- PlataformasWeb
Recursos principais de Contador de Tokens de Prompt
Conta tokens para modelos OpenAI
Ajuda os usuários a permanecerem dentro dos limites de tokens do modelo
Auxilia na otimização de prompts
Suporta controle de custos para interações de IA
Previne rejeição de prompts devido a excesso de tokens
Facilita a comunicação eficaz com a IA
Rastreia o uso de tokens de prompt
Auxilia no gerenciamento da alocação de tokens de resposta
Fornece uma compreensão clara da tokenização
Ferramenta online para uso imediato
Garante que os prompts se encaixem nas restrições do modelo
Suporta gerenciamento eficiente de consultas de IA
Como usar Contador de Tokens de Prompt?
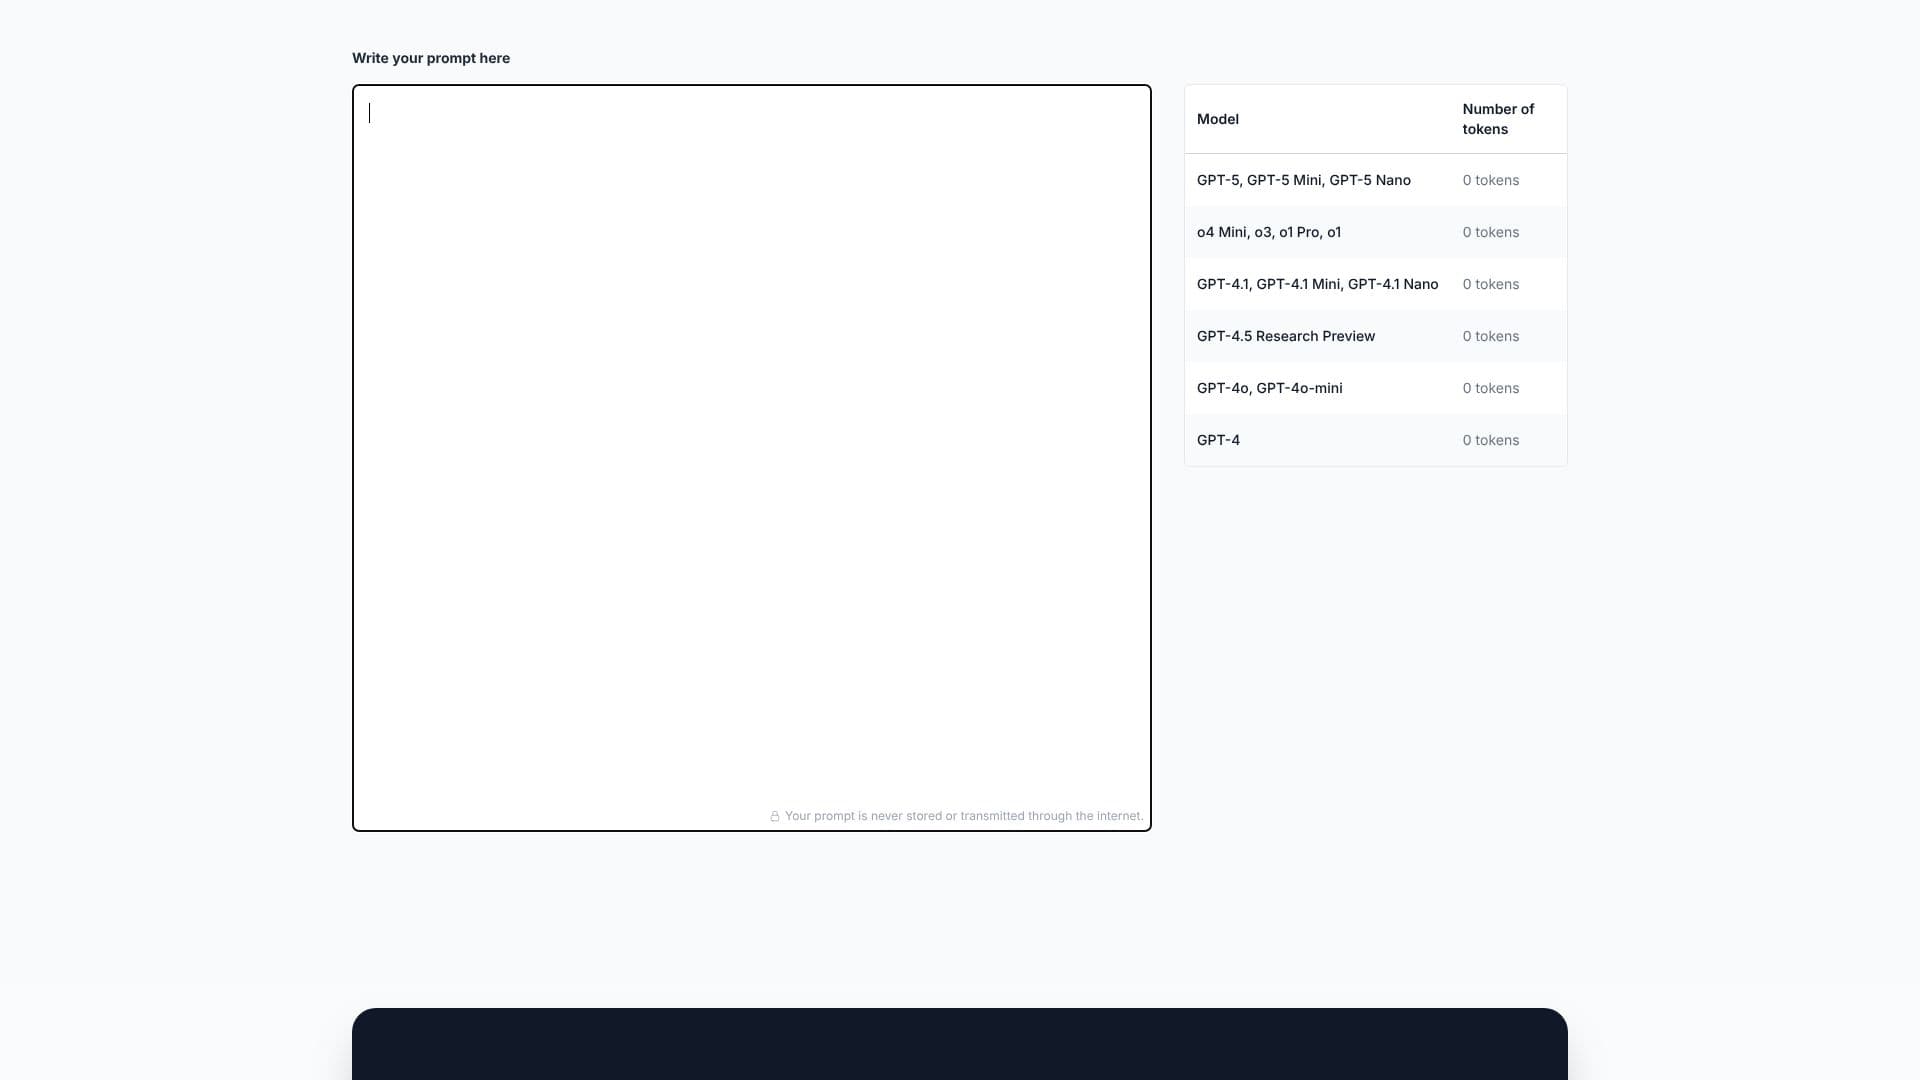
Inserir Prompt: Escreva o texto do seu prompt no campo fornecido.
Selecionar Modelo: Escolha o modelo OpenAI relevante para a contagem de tokens.
Contar Tokens: A ferramenta calcula automaticamente o número de tokens.
Revisar Contagem: Verifique a contagem de tokens em relação ao limite do modelo.
Otimizar Prompt: Ajuste o comprimento do prompt se ele exceder o limite de tokens.
Iterar: Refine o prompt e recontar os tokens até que ele se encaixe.
Casos de uso de Contador de Tokens de Prompt
- Gerenciamento de Comprimento de Prompt
- Otimização de Custos
- Previsão de Resposta
- Eficiência de Interação com IA
- Prevenção de Erros
- Refinamento de Prompt