Descrição
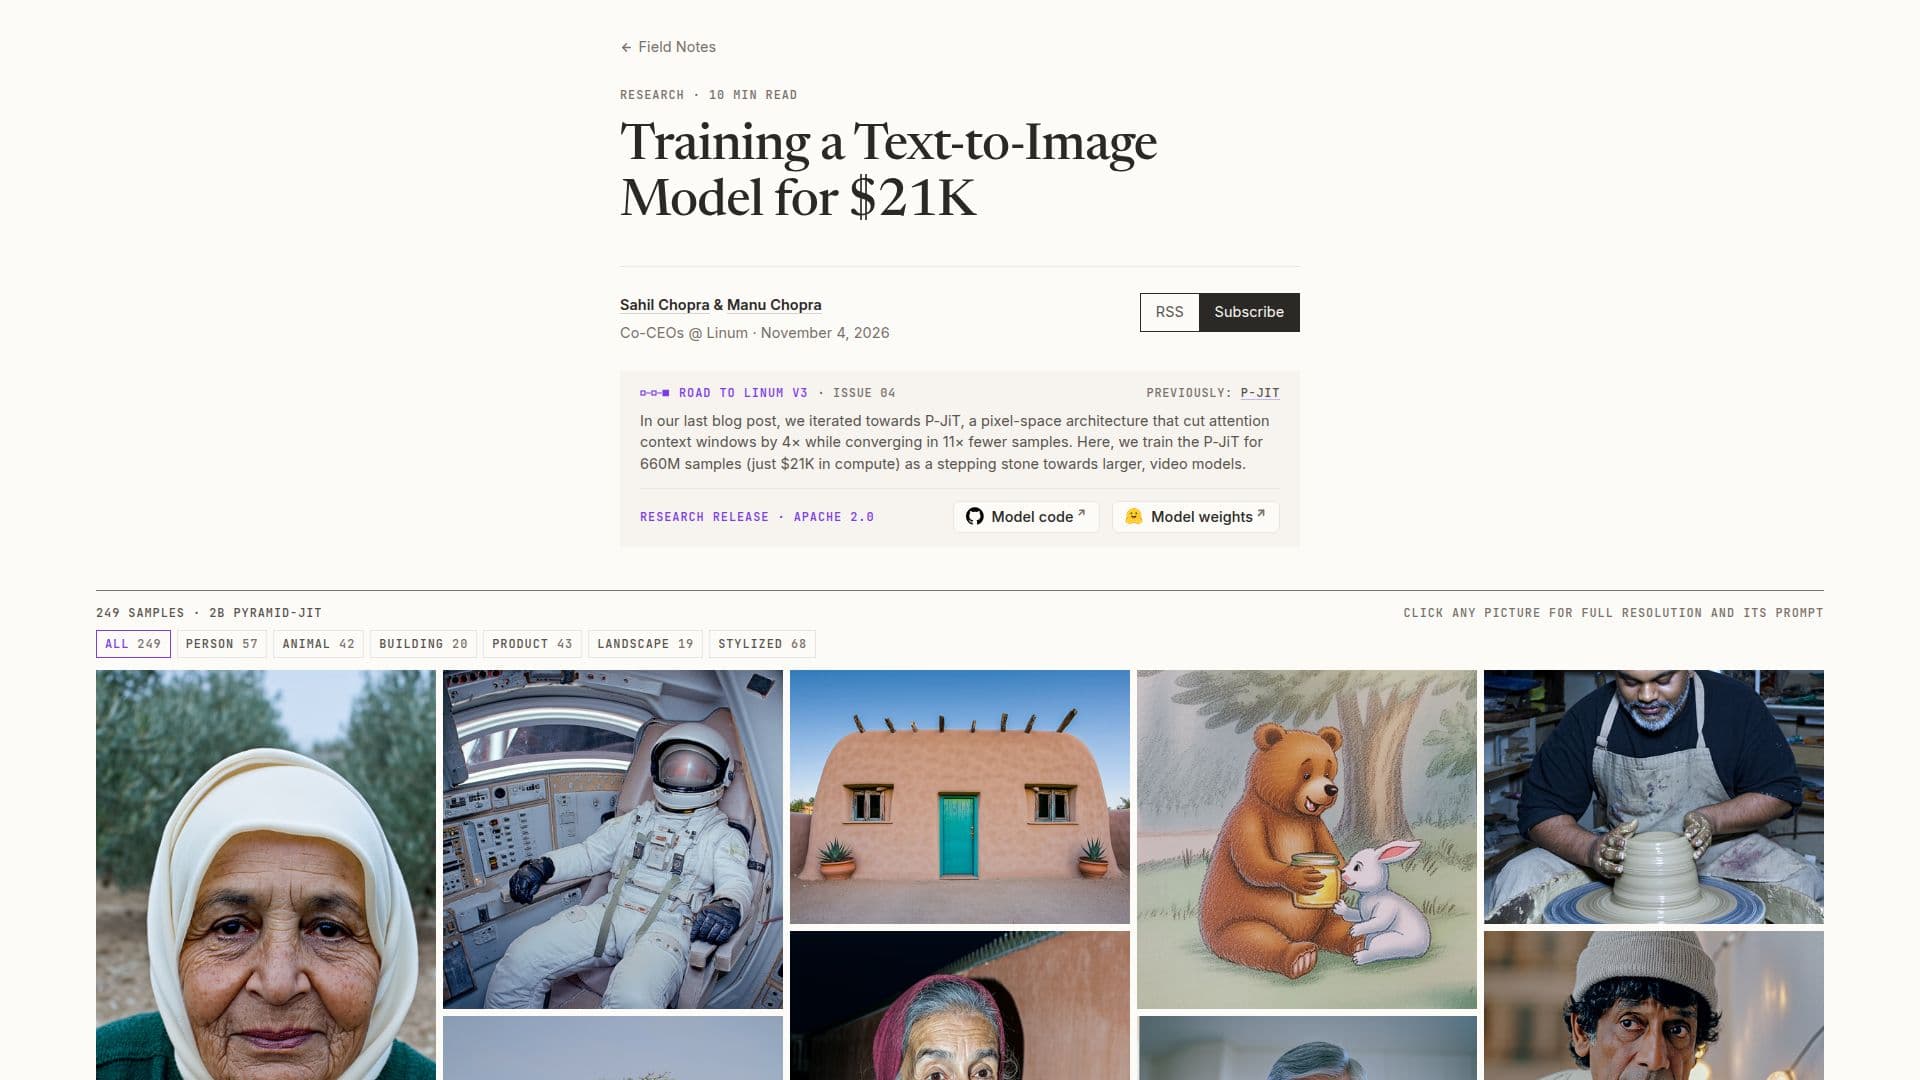
Linum P-JiT é um modelo experimental de texto para imagem desenvolvido pela Linum, um laboratório de pesquisa de duas pessoas dedicado ao treinamento de modelos de vídeo generativos do zero. Este modelo específico, um Pyramid-JiT (P-JiT) com 2 bilhões de parâmetros, serve como uma prova de conceito para sua pesquisa contínua em democratizar o acesso à animação por meio de ferramentas generativas econômicas e controláveis. A execução de treinamento para este modelo custou aproximadamente $21.038, demonstrando o potencial para resultados de alta qualidade a um custo computacional relativamente baixo.
Ler mais
A inovação central por trás do P-JiT é sua capacidade de alcançar uma compressão mais agressiva e um aprendizado mais rápido ao eliminar o tradicional Variational Autoencoder (VAE) da arquitetura do modelo de difusão. Em vez disso, o modelo de difusão aprende um espaço latente projetado especificamente para seu caso de uso, permitindo uma maior compressão e uma geração aprimorada. Este modelo em espaço de pixels converge em 11 vezes menos amostras do que o Linum v2 e oferece uma redução de tokens quatro vezes mais agressiva, representando uma imagem de 512x512 com o mesmo número de tokens anteriormente usados para uma imagem de 256x256. Isso se traduz em uma redução de quatro vezes na janela de contexto de atenção, reduzindo significativamente os custos de treinamento e inferência.
A arquitetura P-JiT incorpora um pipeline de processamento de texto e imagem, onde cada modalidade passa por blocos DiT "refinadores" de modalidade única antes de se fundir em um fluxo de 22 blocos DiT idênticos. A representação de texto é derivada de um modelo Qwen3.5-4B congelado, enquanto as imagens são divididas em patches de 32x32 e comprimidas em um espaço de 1024 dimensões. O modelo também apresenta leituras PixelREPA alinhadas ao DINOv3-L e cabeçotes de leitura linear adicionais ao longo do tronco para acelerar a convergência, prevendo versões de baixa resolução da imagem final.
O treinamento foi conduzido em várias etapas, começando com resolução de 512x512 para 610 milhões de amostras e, em seguida, transicionando para resolução de 1024x1024 para 50 milhões de amostras. Um currículo sobre o cronograma de ruído foi empregado, inicialmente concentrando-se em alto ruído para aprender a estrutura básica, e depois ampliando a distribuição para detalhes mais finos. O pós-treinamento envolveu uma variante da Otimização de Fluxo de Diferença Finita (FDFO) com JEV-Image e juízes humanos. Embora o modelo mostre resultados promissores, ele tem limitações, particularmente com geração de corpo inteiro, múltiplas entidades, interações entre várias pessoas e conhecimento de mundo, que são comuns para modelos de seu tamanho. Não foi treinado com imagens de texto renderizado, portanto, não pode gerar texto ou pôsteres.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Recursos principais de Linum P-JiT
Arquitetura Pyramid-JiT (P-JiT): Modelo em espaço de pixels inovador para geração eficiente
DiT com 2 bilhões de parâmetros: Tamanho do modelo central de difusão
Codificador de Texto com 4 bilhões: Utiliza um modelo Qwen3.5-4B congelado para representação de texto
Design sem VAE: Elimina o VAE para compressão mais agressiva e aprendizado mais rápido
Redução de Tokens 4x: Representa imagens de 512x512 com 4x menos tokens do que o Linum v2
Convergência 11x mais rápida: Alcança resultados com significativamente menos amostras de treinamento
Treinamento em Múltiplas Etapas: Progride de 512x512 para 1024x1024 de resolução
Cronograma de Ruído Curricular: Adapta a distribuição de ruído para aprendizado de estrutura e detalhes
Leituras PixelREPA: Alinha o espaço latente ao DINOv3-L para aprendizado de detalhes aprimorado
Cabeçotes de Leitura Linear: Prevê imagens limpas em resolução de um quarto e metade para convergência acelerada
Otimização de Fluxo de Diferença Finita (FDFO): Utilizada para refinamento pós-treinamento
Licença Apache 2.0: Pesos são liberados sob uma licença de código aberto
Treinamento Econômico: Alcançou resultados de alta qualidade por aproximadamente $21K
Foco em Pesquisa de Vídeo Generativo: Um passo em direção a futuros modelos de vídeo
Como usar Linum P-JiT?
Entender a Arquitetura: Revise os detalhes da arquitetura P-JiT, incluindo fluxos de processamento de texto e imagem.
Examinar o Regime de Treinamento: Aprenda sobre o processo de treinamento em múltiplas etapas, cronogramas de ruído e transições de resolução.
Explorar as Limitações do Modelo: Entenda as limitações atuais em relação à geração de corpo inteiro, múltiplas entidades e geração de texto.
Acessar Configurações de Treinamento: Consulte o Apêndice A para parâmetros e configurações de treinamento detalhados.
Revisar a Quebra de Custos: Veja a divisão dos custos de computação pré e pós-treinamento.
Analisar Exemplos de Falhas: Estude exemplos fornecidos de falhas do modelo para compreender as capacidades atuais e áreas de melhoria.
Casos de uso de Linum P-JiT
- Pesquisa de Geração de Texto para Imagem
- Treinamento de Modelo Econômico
- Desenvolvimento de Modelos de Vídeo Generativo
- Teste de Inovação Arquitetônica
- Experimentação em IA de Código Aberto