Descrição
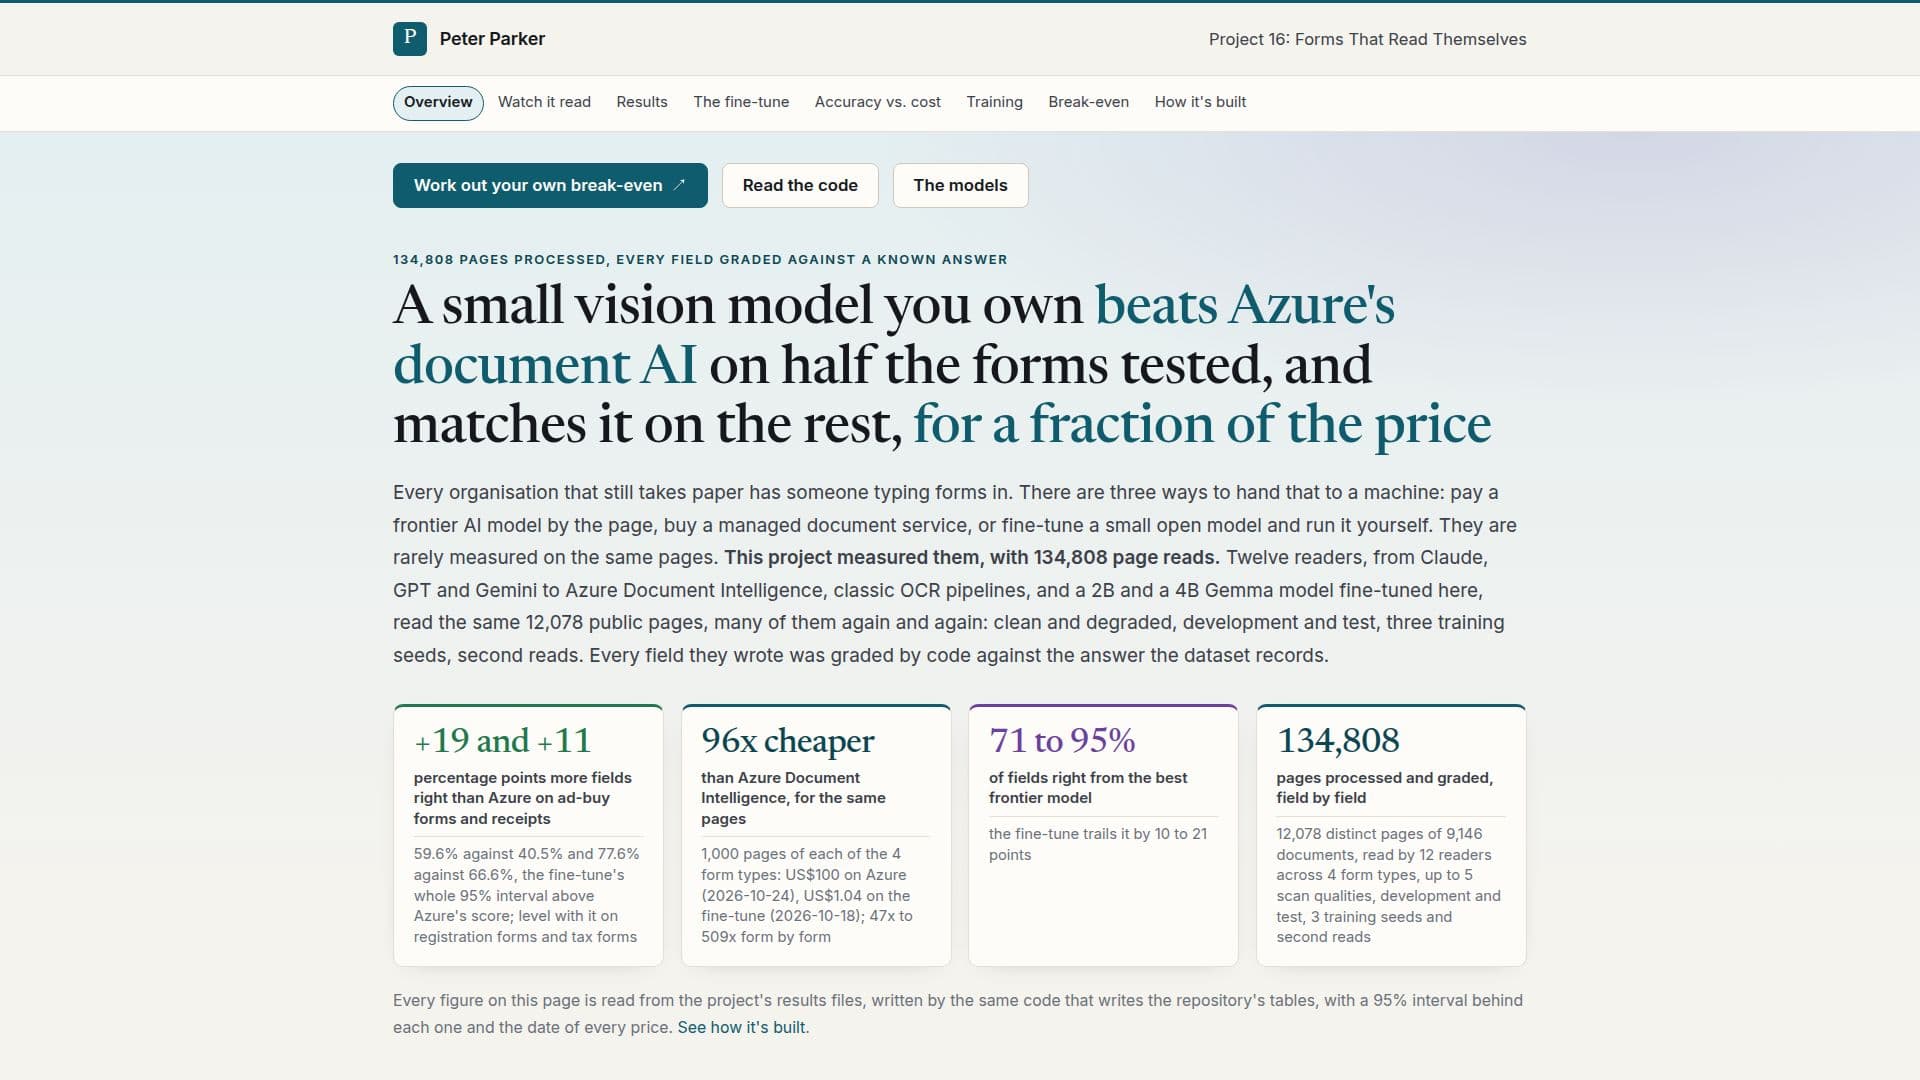
Forms That Read Themselves introduz uma avaliação abrangente de doze leitores diferentes para formulários digitalizados, variando de APIs de visão de última geração a um modelo personalizado de 2B parâmetros ajustado especificamente para esse propósito. A oferta principal é um pequeno modelo de visão que os usuários podem possuir e operar, fornecendo uma alternativa econômica a soluções comerciais como Azure Document Intelligence.
Ler mais
A plataforma avalia meticulosamente cada leitor campo a campo em conjuntos de dados públicos com respostas conhecidas, incluindo o NIST Special Database 2 para formulários fiscais dos EUA de 1988, registros da Foreign Agents Registration Act, ordens de compra de anúncios políticos da FCC e recibos do CORD v2. Essa rigorosa avaliação revela que o modelo ajustado supera o Azure Document Intelligence em metade dos tipos de formulários testados e iguala seu desempenho no restante, tudo isso operando a uma fração do preço. Por exemplo, em formulários de compra de anúncios, o modelo ajustado alcança 59,6% de precisão contra 40,5% do Azure, e em recibos, 77,6% contra 66,6%.
Uma descoberta chave é o impacto transformador do ajuste fino em modelos menores. Modelos não ajustados como o Gemma 4 E2B mostram precisão significativamente mais baixa (por exemplo, 15,0% em formulários fiscais), que melhora dramaticamente para 73,6% após o ajuste fino. Esse processo, que pode levar de 8 minutos a 4,9 horas em uma GPU alugada, torna esses modelos menores altamente competitivos. O modelo ajustado também demonstra uma taxa menor de invenção de valores em comparação com modelos de ponta em certos tipos de formulários, como formulários de registro e recibos, o que é crucial para aplicações onde um campo em branco é preferível a uma entrada confiante, mas incorreta.
Embora modelos de visão de ponta como GPT-6.1 Sol e Gemini 3.8 Flash geralmente alcancem maior precisão, o modelo ajustado oferece um equilíbrio convincente entre desempenho e custo. Por exemplo, em recibos, ele alcança 77,6% de precisão por US$0,16 por mil páginas, em comparação com 76,7% do Claude Haiku 5.5 por US$0,38. Uma vantagem significativa de possuir e executar o modelo em uma GPU de consumidor é a maior privacidade de dados, já que nenhuma página precisa deixar a rede do usuário.
O projeto também destaca a robustez dos modelos de visão contra degradação de digitalizações. Ao contrário de pipelines baseados em OCR, que sofrem quedas drásticas de precisão com qualidade de digitalização ruim, modelos de visão que leem pixels diretamente mantêm alto desempenho. No entanto, é importante notar que nenhum leitor alcançou 99% de precisão em todos os campos, o que significa que a verificação humana continua sendo necessária para aplicações críticas. Os modelos automatizam principalmente o processo de digitação, não a verificação final.
A arquitetura envolve o treinamento dos modelos Gemma 4 E2B e E4B de pesos abertos usando QLoRA, congelando os pesos do modelo base em 4 bits enquanto treina pequenas matrizes de adaptadores. Esses adaptadores são servidos com vLLM em uma GPU RTX 3090, permitindo uma implantação eficiente no local. O site fornece uma calculadora para determinar o ponto de equilíbrio entre os custos de API e aluguel de GPU, enfatizando que o custo real de um modelo próprio depende de sua utilização.
- CategoriaFerramentas de visão computacional
- Modelo de preçosGPU Rental Cost
- ImplantaçãoOn-Premise
- PlataformasWeb
Recursos principais de Forms That Read Themselves
Modelos de visão ajustados para extração de formulários digitalizados
Avaliação em comparação com APIs de visão de ponta (GPT-6.1 Sol, Claude Sonnet, Gemini Flash)
Comparação com Azure Document Intelligence
Suporte para vários tipos de formulários: registro, compra de anúncios, recibos, formulários fiscais
Avaliação de precisão campo a campo em conjuntos de dados públicos
Alternativa econômica a APIs comerciais
Capacidade de implantação no local em GPUs de consumidor (por exemplo, RTX 3090)
Redução da invenção de valores em certos tipos de formulários
Robustez contra degradação de digitalizações (ruído, desfoque, distorção, contraste perdido)
Métricas de desempenho detalhadas, incluindo campos corretos e custo por mil páginas
Modelos base de pesos abertos (Gemma 4 E2B, E4B) usados para ajuste fino
Receita de ajuste fino QLoRA para treinamento eficiente em GPUs únicas
vLLM para servir modelos ajustados
Calculadora para análise de ponto de equilíbrio entre custos de API e GPU própria
Privacidade de dados mantendo páginas dentro da sua rede
Como usar Forms That Read Themselves?
Selecione um Leitor: Escolha entre vários modelos de visão ou pipelines de OCR para comparar seu desempenho.
Ajuste a Qualidade da Digitalização: Simule diferentes níveis de degradação (ruído, desfoque, distorção, contraste perdido) para observar o impacto na precisão.
Revise os Resultados Campo a Campo: Veja quais campos cada leitor extrai corretamente, marcados em verde, e quais estão incorretos, marcados em vermelho e tracejado.
Analise a Precisão e o Custo: Compare a proporção de campos corretos e o custo por mil páginas para diferentes leitores e tipos de formulários.
Entenda o Impacto do Ajuste Fino: Observe como o ajuste fino melhora significativamente a precisão de modelos menores em tipos de formulários específicos.
Avalie os Custos de Implantação: Use a calculadora fornecida para determinar a viabilidade econômica de alugar uma GPU em comparação com o uso de APIs comerciais com base no seu volume.
Acesse Adaptadores: Baixe adaptadores ajustados disponíveis para recibos, formulários de compra de anúncios e formulários fiscais do Hugging Face.
Casos de uso de Forms That Read Themselves
- Extração Automatizada de Dados de Formulários
- Processamento de Documentos Econômico
- Processamento de Dados no Local
- Avaliação de Modelos de Visão de IA
- Melhorando a Precisão do OCR
- Desenvolvimento de Modelos Personalizados