Descrição
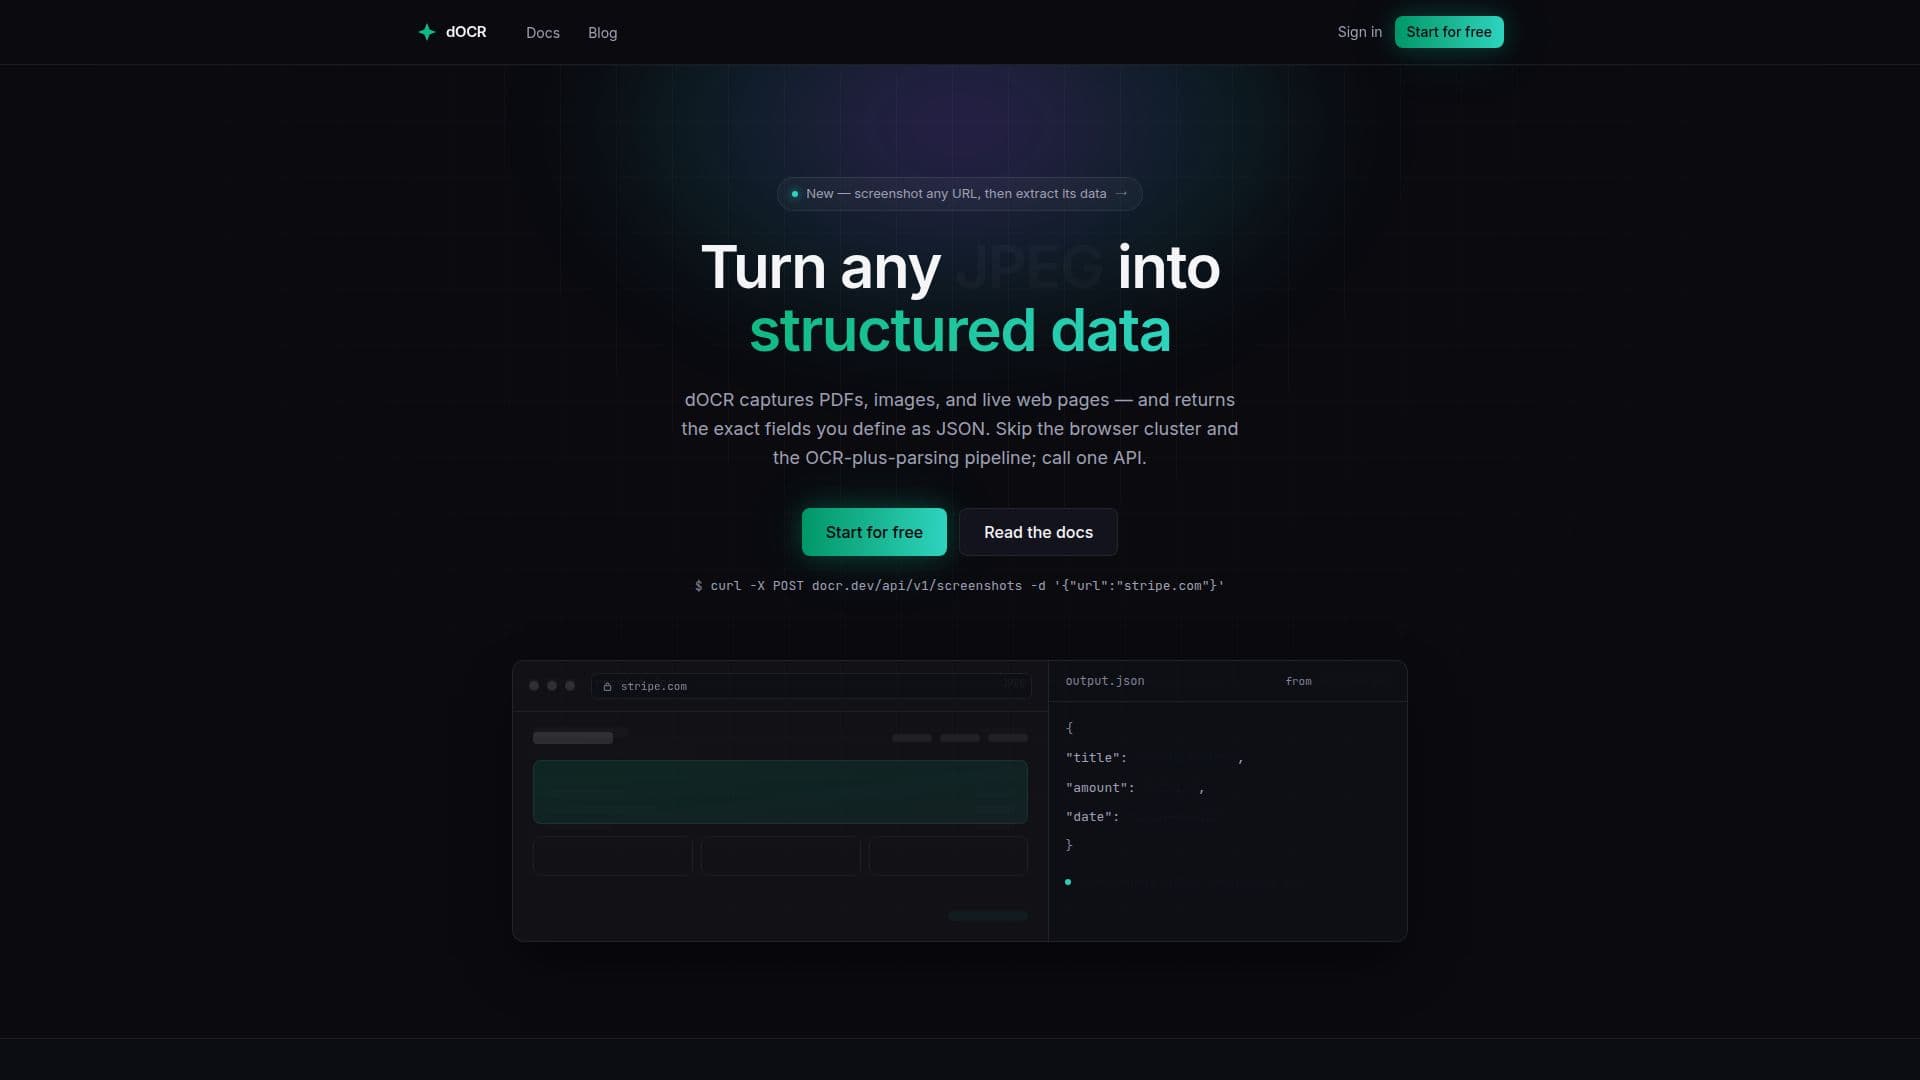
dOCR fornece uma API robusta de extração de dados de documentos projetada para transformar vários tipos de documentos e páginas da web ao vivo em dados JSON estruturados. O serviço lida com as complexidades de renderização de páginas e análise de documentos, entregando capturas de tela limpas e campos JSON validados. Essa abordagem permite que os usuários evitem clusters de navegador tradicionais e pipelines de OCR mais análise, simplificando a aquisição de dados por meio de uma única chamada de API.
Ler mais
A plataforma suporta uma ampla gama de entradas, incluindo PDFs, imagens e URLs ao vivo. Os usuários podem definir os campos exatos que precisam, e o dOCR localizará, validará e pontuará cada um, garantindo uma saída de dados consistente sem a necessidade de qualquer código de análise. Essa capacidade é particularmente útil para processar documentos comerciais como faturas, recibos, formulários e documentos de identidade, bem como para extrair dados de qualquer página da web ao vivo.
As funcionalidades principais incluem a capacidade de capturar qualquer URL, renderizando páginas em vários formatos, como PNG, JPEG, WebP ou PDF, com opções para captura de página inteira e diferentes visualizações de dispositivos. O dOCR também bloqueia automaticamente anúncios e banners de cookies, simplificando ainda mais o processo de captura de dados. O serviço é projetado para velocidade, com a maioria dos documentos processados em poucos segundos, incluindo PDFs de várias páginas, tornando-o adequado para solicitações em tempo real em vez de trabalhos em lote.
Os usuários podem definir tipos de documentos personalizados, especificando os campos desejados uma vez para garantir que cada extração retorne dados nessa forma exata. A plataforma oferece tanto um painel para testes e navegação no histórico de extrações, quanto uma API para automação de backend. Essa flexibilidade permite que os desenvolvedores integrem o dOCR em seus fluxos de trabalho com uma sobrecarga mínima de infraestrutura.
A transparência é um aspecto central do dOCR, fornecendo logs detalhados para cada extração. Os usuários podem rastrear cada campo desde o upload até o OCR, extração de campo e validação de esquema, completos com pontuações de confiança. Essa visibilidade ajuda a identificar e resolver quaisquer discrepâncias, garantindo precisão e confiabilidade dos dados. O serviço é acessível por meio de uma única chave de API, suportando tanto captura de tela quanto extração de dados estruturados, e oferece um nível gratuito para começar.
- CategoriaWeb scraping e extração de dados
- Modelo de preçosFreemium
- ImplantaçãoNuvem
- PlataformasWeb
Recursos principais de dOCR
API de extração de dados de documentos
Converte documentos e sites em JSON estruturado
Suporta faturas, recibos, formulários e documentos de identidade
Captura PDFs, imagens e páginas da web ao vivo
Retorna campos definidos pelo usuário como JSON
Fornece capturas de tela limpas de páginas da web
Valida e pontua campos JSON extraídos
Renderiza páginas em PNG, JPEG, WebP ou PDF
Bloqueia anúncios e banners de cookies durante a captura da web
Processamento rápido, tipicamente em segundos
Suporta processamento de PDFs de várias páginas
Permite definição de tipos de documentos personalizados
Oferece painel para testes e histórico
Fornece logs detalhados de extração com pontuações de confiança
Uma única chave de API para todas as funcionalidades
Como usar dOCR?
Criar Conta: Inscreva-se em docr.dev para obter uma chave de API.
Definir Tipo de Documento: Especifique os campos JSON que deseja extrair para seu tipo de documento.
Enviar Documento ou URL: Use a API para enviar um documento (PDF, imagem, DOCX) ou uma URL ao vivo.
Receber Dados Estruturados: Receba os campos definidos como JSON validado com pontuações de confiança.
Revisar Extrações: Monitore o histórico de extrações e logs no painel para transparência.
Casos de uso de dOCR
- Automação de Processamento de Faturas
- Captura de Dados de Recibos
- Extração de Dados de Formulários
- Raspagem de Dados de Páginas da Web
- Arquivamento de Documentos com Metadados
- Processamento de Dados em Tempo Real
- Relatórios Automatizados
- Conformidade e Trilhas de Auditoria