Descrição
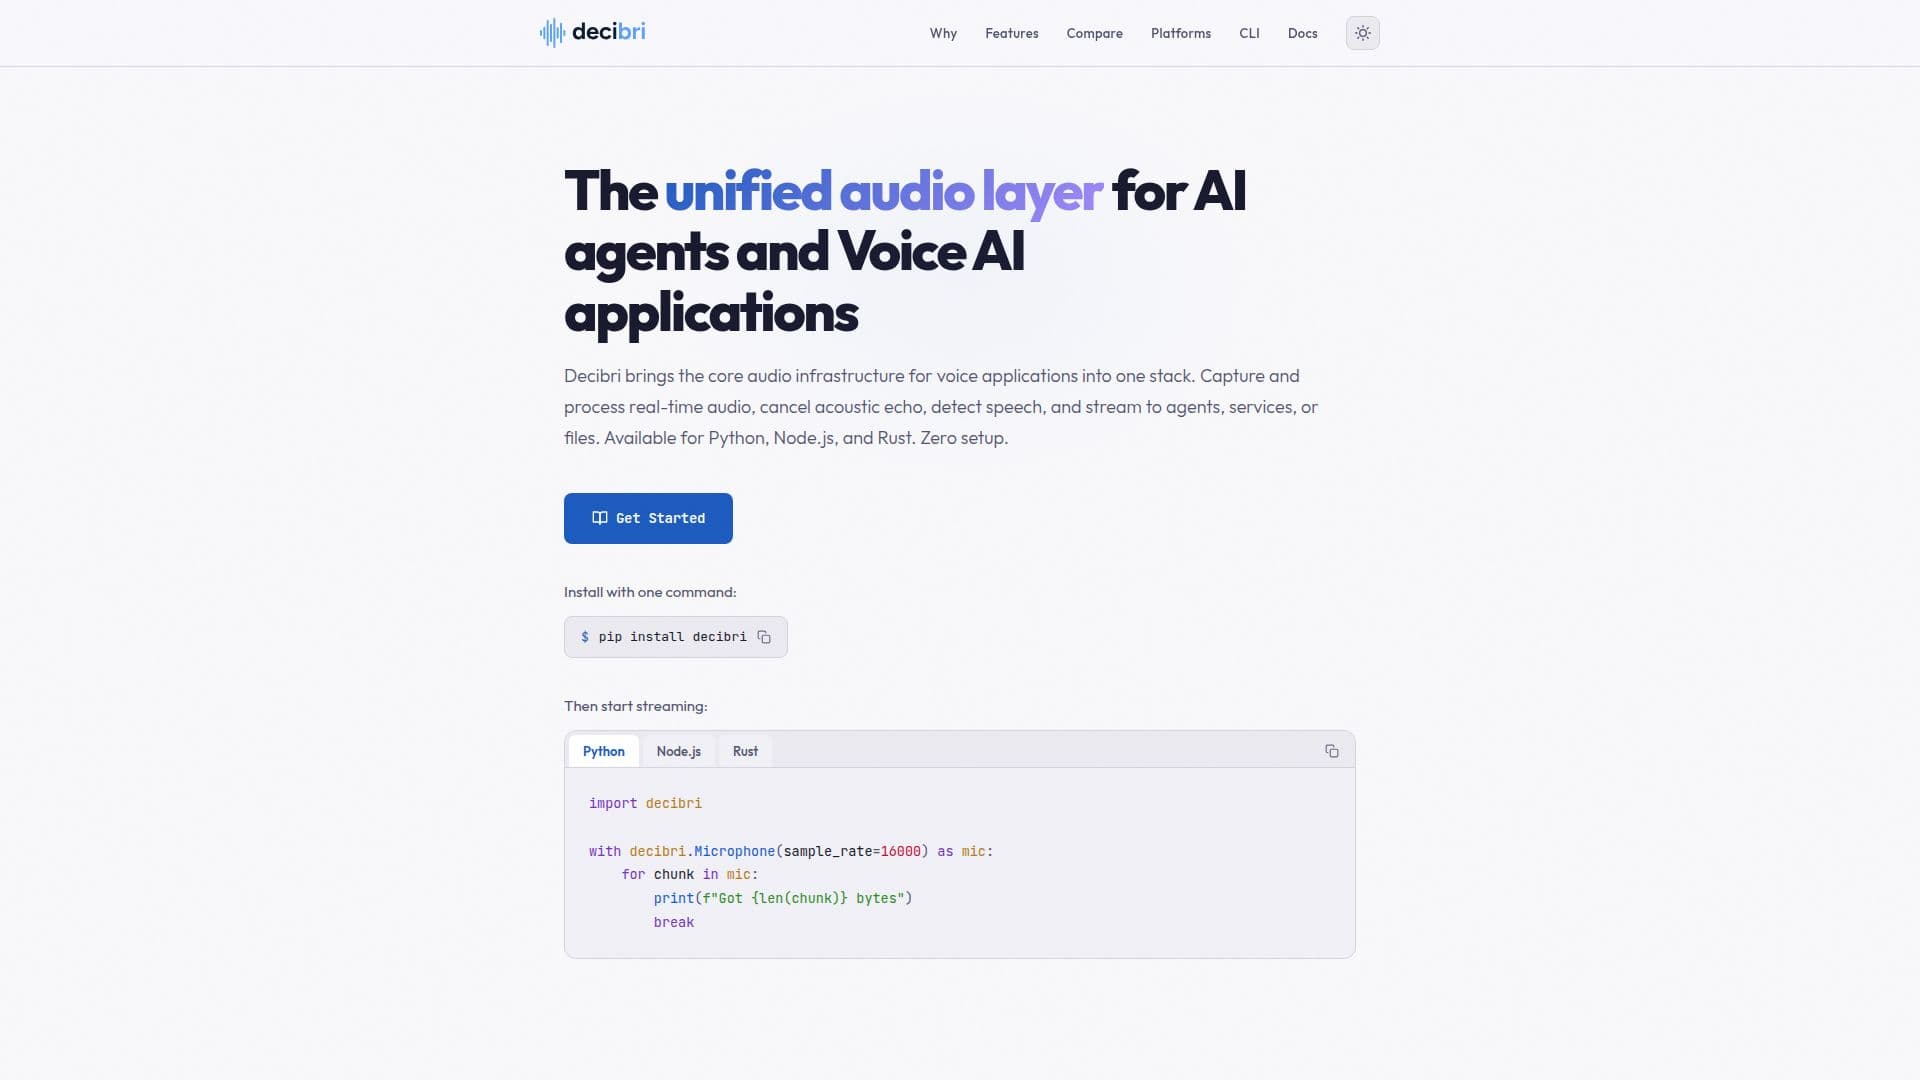
Decibri serve como uma camada de áudio unificada especificamente projetada para agentes de IA e aplicações de Voz IA. Ele fornece capacidades essenciais de áudio em tempo real, incluindo captura de microfone, saída de alto-falante e detecção de atividade de voz (VAD). A plataforma suporta várias linguagens de programação, nomeadamente Python, Node.js e Rust, tornando-a versátil para diversos ambientes de desenvolvimento.
Ler mais
Uma das principais vantagens do Decibri é sua facilidade de instalação e compatibilidade multiplataforma. Ele oferece binários pré-compilados para Python e Node.js em todas as plataformas suportadas (Windows, macOS, Linux), eliminando a necessidade de compilação ou ferramentas de construção complexas. Essa abordagem de "zero configuração" garante que os desenvolvedores possam integrar rapidamente funcionalidades de áudio em tempo real em seus projetos. O núcleo em Rust, que alimenta os pacotes de Python, Node.js e Rust, compila para código nativo, garantindo áudio de baixa latência previsível diretamente da camada de áudio do sistema operacional.
Decibri captura áudio diretamente da camada de áudio do sistema operacional, fornecendo blocos de áudio de 100ms por padrão no formato PCM de inteiro assinado de 16 bits, que é o padrão esperado pela maioria dos motores de fala e palavras-chave, como Vosk, sherpa-onnx e whisper.cpp. Um formato de ponto flutuante de 32 bits também está disponível. Ele suporta expressões idiomáticas nativas de fluxo para cada linguagem, permitindo que os desenvolvedores canalizem áudio para arquivos, WebSockets ou agentes de voz de forma eficiente. A plataforma também inclui um modelo Silero VAD v6.2 embutido para detecção precisa de fala em ambientes ruidosos, funcionando localmente via ONNX Runtime sem exigir APIs em nuvem.
Além da captura e reprodução básicas, o Decibri oferece recursos avançados de processamento de áudio por meio de seu Motor de Captura de Áudio (ACE), incluindo remoção de DC, redução de ruído, filtragem passa-alta, controle automático de ganho e limitação. Ele também fornece Cancelamento de Eco Acústico (AEC) para remover o som do alto-falante da captura do microfone. Para processamento offline, o Processador de Arquivo de Áudio (AFP) permite condicionar amostras gravadas ou em memória. Decibri integra-se com numerosos provedores de fala-para-texto (STT), tanto baseados em nuvem (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) quanto locais (Sherpa-ONNX, Whisper.cpp), assim como texto-para-fala (TTS) local com o modelo Kokoro e detecção de palavras-chave (KWS) com Sherpa-ONNX.
Decibri é construído para sistemas em tempo real, garantindo I/O de áudio de baixa latência sem ferramentas de áudio externas ou manipulação específica da plataforma. Ele suporta operações assíncronas em Python com `asyncio` e funciona tanto em ambientes Node.js quanto em navegadores a partir de um único pacote. A ferramenta `decibri-cli` fornece capacidades de linha de comando para captura de áudio, reprodução e enumeração de dispositivos, ampliando ainda mais sua utilidade para scripts e pipelines de CI/CD.
- CategoriaCriadores de agentes de IA
- Modelo de preçosGrátis
- ImplantaçãoLocal
- PlataformasWindows, macOS, Linux, Browser
Recursos principais de Decibri
Captura de Microfone em Tempo Real
Saída e Reprodução de Alto-falante
Detecção de Atividade de Voz (VAD)
Suporte Multiplataforma (Python, Node.js, Rust)
Binários Pré-compilados para Zero Configuração
Acesso Direto à Camada de Áudio do SO
Saída de Áudio PCM de 16 bits e Float de 32 bits
Suporte a API Assíncrona (asyncio para Python)
Compatibilidade com Navegadores (pacote Node.js)
Motor de Captura de Áudio (remoção de DC, redução de ruído, AGC)
Cancelamento de Eco Acústico (AEC)
Detecção de Voz ML Local (Silero VAD)
Integração com Serviços de STT em Nuvem
Integração com Modelos Locais de STT/TTS/KWS
Interface de Linha de Comando (decibri-cli)
Como usar Decibri?
Instalar Decibri: Use `pip install decibri` para Python ou `npm install decibri` para Node.js para obter os binários pré-compilados.
Abrir Microfone: Utilize `decibri.Microphone.open()` em Python ou `new Microphone()` em Node.js para começar a capturar áudio.
Transmitir Áudio: Leia blocos de áudio usando iteradores Python, streams legíveis do Node.js ou canais Rust.
Processar Áudio: Aplique condicionamento embutido como remoção de DC, redução de ruído ou cancelamento de eco acústico.
Detectar Fala: Ative o modelo Silero VAD embutido para detecção local de atividade de voz.
Integrar com Serviços de IA: Canalize áudio PCM bruto para serviços de fala-para-texto, agentes de voz ou outros modelos de IA.
Reproduzir Áudio: Use a API de Alto-falante do Decibri para reproduzir áudio através do alto-falante do sistema.
Gravar em Arquivo: Utilize `record_to_file()` para gravação simples de áudio ou controle total de streaming para casos de uso avançados.
Casos de uso de Decibri
- Agentes de Voz IA em Tempo Real
- Integração de Fala-para-Texto
- Detecção de Atividade de Voz
- Gravação de Áudio para ASR
- Aplicações de Áudio Multiplataforma
- Backends de Voz do Lado do Servidor
- Detecção de Palavras-chave
- Comunicação de Áudio Full Duplex