Descrição
Crawl4AI é um crawler e scraper de código aberto, amigável para LLM, que capacita desenvolvedores a extrair dados de forma eficiente da web. Construído para grandes modelos de linguagem e agentes de IA, fornece uma solução confiável para extração web que é ao mesmo tempo econômica e fácil de implantar.
Ler mais
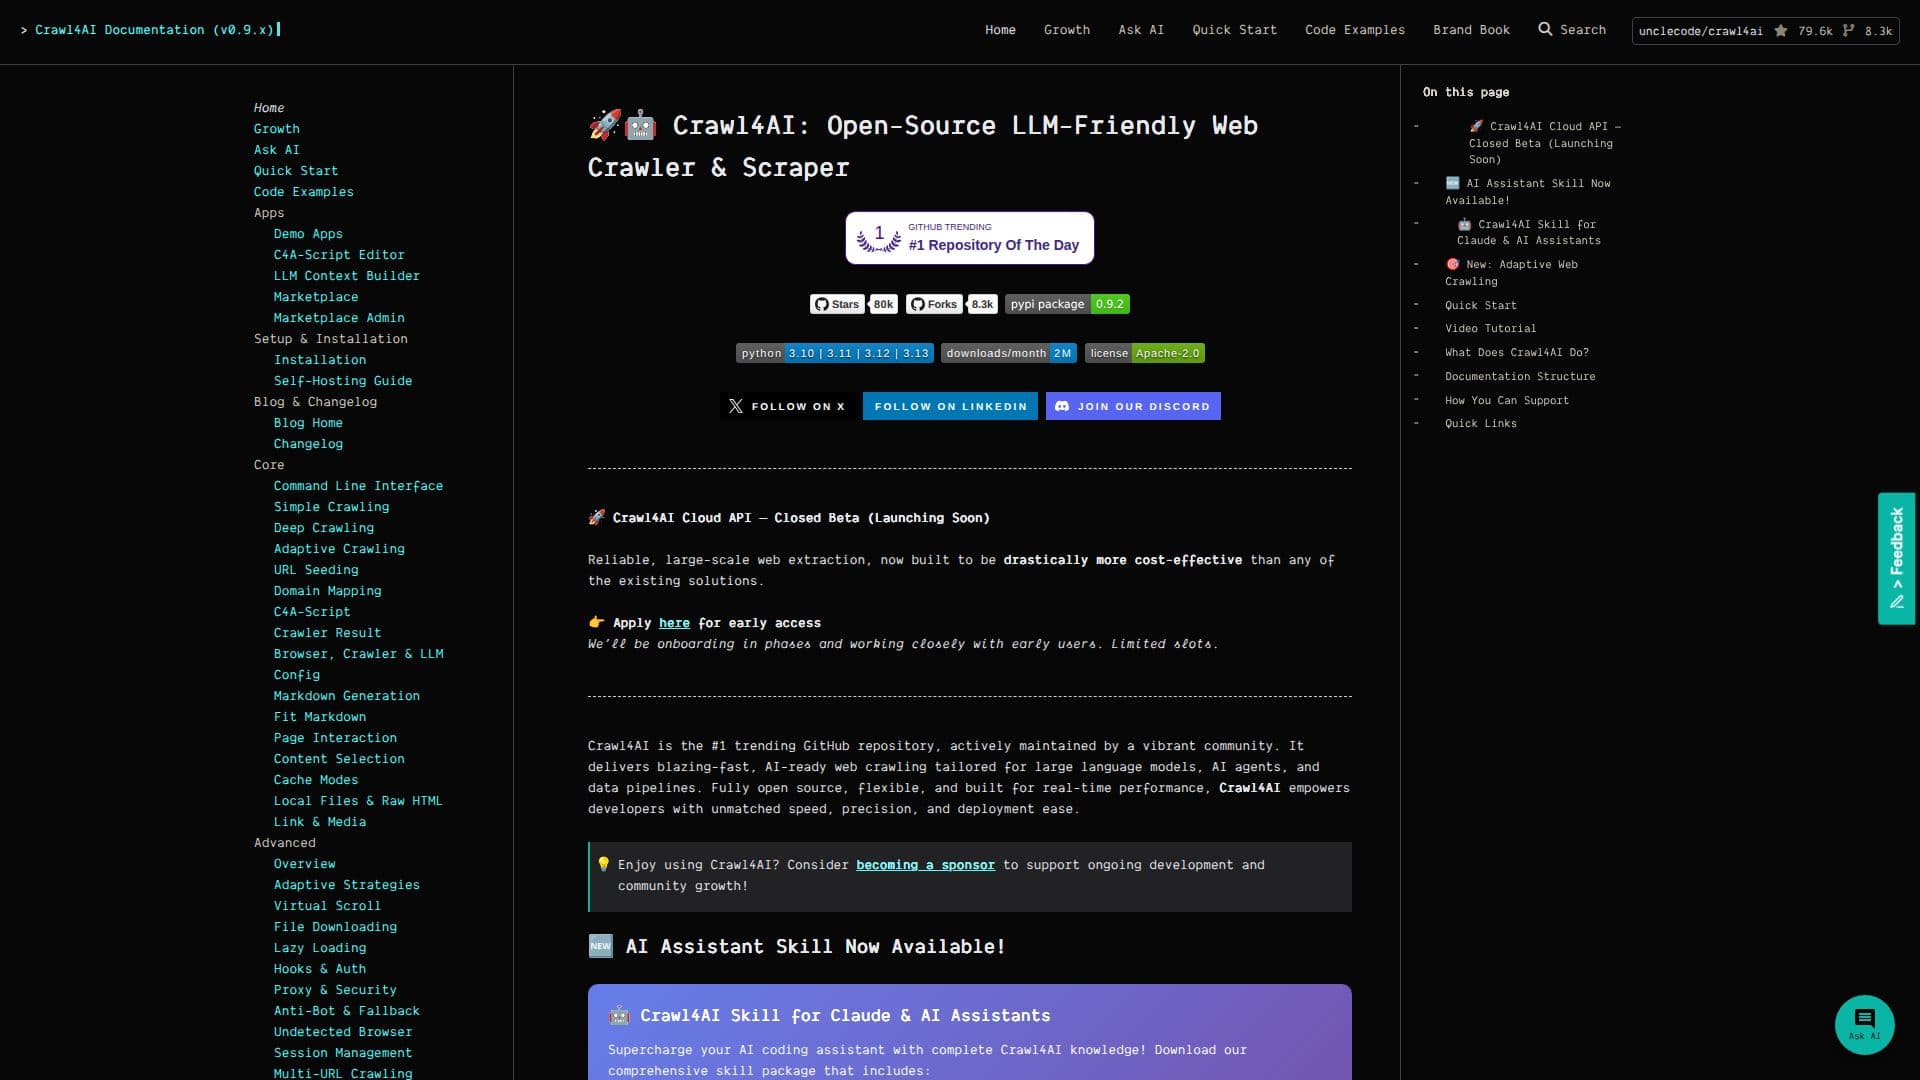
A plataforma é mantida ativamente por uma comunidade vibrante e ganhou reconhecimento como o repositório do GitHub em tendência número 1. Com seu desempenho extremamente rápido, o Crawl4AI é adaptado para aplicações em tempo real, tornando-se uma escolha ideal para desenvolvedores que buscam integrar scraping web em seus pipelines de dados.
Um dos recursos de destaque do Crawl4AI é sua capacidade de gerar Markdown limpo, que é perfeito para pipelines de geração aumentada por recuperação (RAG) ou ingestão direta em LLMs. Suporta extração estruturada, permitindo que os usuários analisem padrões repetidos usando CSS, XPath ou métodos de extração baseados em LLM. Além disso, o Crawl4AI oferece controle avançado do navegador com recursos como hooks, proxies, modos furtivos e reutilização de sessões, proporcionando controle detalhado sobre o processo de crawling.
O Crawl4AI também introduz crawling adaptativo inteligente, que utiliza algoritmos avançados de forrageamento de informações para determinar quando informações suficientes foram coletadas para responder a uma consulta. Esse recurso aumenta a eficiência da coleta de dados, minimizando solicitações desnecessárias.
A documentação é bem estruturada, fornecendo seções claras sobre configuração, instalação e recursos avançados. Os usuários podem encontrar guias práticos, exemplos de código e referências para ajudá-los a começar rapidamente. A plataforma incentiva a participação da comunidade, permitindo que os usuários contribuam por meio de pull requests, relatem problemas e participem de discussões no Discord.
A missão do Crawl4AI é democratizar o acesso a dados, tornando-o gratuito e altamente configurável. O objetivo é capacitar estudantes, pesquisadores, empreendedores e cientistas de dados a acessar, analisar e moldar os dados do mundo com rapidez e liberdade criativa.
- CategoriaWeb scraping e extração de dados
- Modelo de preçosGrátis
- ImplantaçãoNuvem
- PlataformasMultiplataforma
Recursos principais de Crawl4AI
Código Aberto
Amigável para LLM
Crawling Adaptativo
Extração Estruturada
Controle Avançado do Navegador
Alto Desempenho
Casos de Uso em Tempo Real
Sem Chaves de API Obrigatórias
Como usar Crawl4AI?
Configurar: Configure o Crawl4AI via pip ou Docker.
Usar: Inicie seu primeiro crawl com os exemplos fornecidos.
Extrair: Utilize métodos de extração estruturada para análise de dados.
Otimizar: Implemente recursos avançados como crawling adaptativo e persistência de sessão.
Casos de uso de Crawl4AI
- Extração de Dados
- Web Scraping
- Pesquisa
- Treinamento de IA
- Agregação de Conteúdo